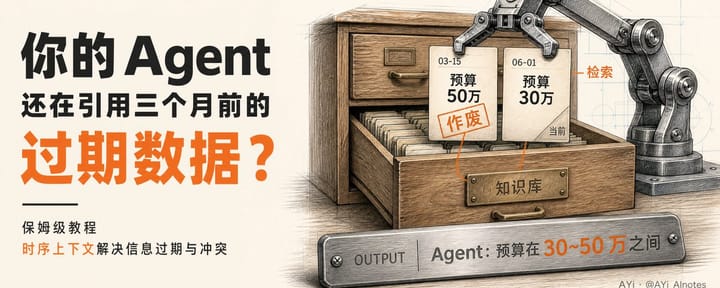
19 Aug 2026 AYi 我终于想明白 RAG 为什么治不了 Agent 记忆过期:时序上下文的四个机制、两条开源路线和真实边界实操 本文作者:AYi(@AYi_AInotes)。版权归作者所有,未经授权禁止转载。 做 RAG 应用,最危险的不是检索不到,而是新旧事实一起被检索出来:客户三月确认预算 50 万,六月改成 30 万,Agent 却回答 "预算在 30 万到 50 万之间&
19 Aug 2026 程序员小灰 电影《牛来》,打了多少人的脸? 本文作者:程序员小灰(@XiaohuiAI666)。版权归作者所有,未经授权禁止转载。 大家好,我是程序员小灰。 2026年最火爆的国产电影是什么?毫无疑问,就是近期正在上映的动画电影《牛来》。 这部电影之所以火爆,不是因为它的做工有多么精良,恰恰相反,而是因为它因为做得 “烂” 而走红。 截至这篇文章发布,《牛来》的票房已经突破 1000 万,超过了同期许多大制作、大牌明星出演的电影。 小灰出于好奇,
19 Aug 2026 花叔 我把10本橙皮书搬进了WorkBuddy! 本文作者:花叔(@AlchainHust)。版权归作者所有,未经授权禁止转载。 DeepSeek把Harness开源的第二天,我发了本橙皮书到GitHub上,名字叫《DeepSeek Harness:从开机到拆开》。 做橙皮书现在算是我学一个新概念的主要方式了。我早就说过,我这套橙皮书基本都是agent写的,我自己要做的只有那么几件事:想清楚我到底要什么,这本书是写给谁看的,内容按什么顺序摆出来读者才好理解,以及它写到什么程度更可能对我和我的目标受众有用。 这套橙皮书📙还有一点其实挺关键的。这些新概念冒出来的时间都太近了,压根不在模型的训练语料里,你直接让它写,它就开始编,
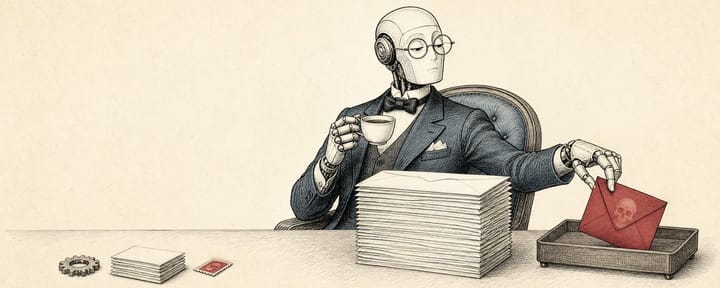
19 Aug 2026 huangserva 我让邮箱 Agent 管了一周收件箱,最后给它发了一封投毒邮件 本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 最近很苦恼,我的收件箱有 900多封未读邮件,多半是 GitHub 发来的 "Run failed"。 漏一封 GitHub 通知无所谓。可这几百封构建失败通知里,也有品牌方的 brief、报价、发票——漏一封,
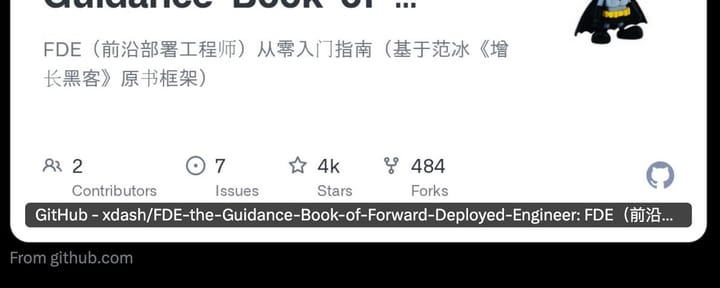
19 Aug 2026 XDash 一本 FDE 开源书的意外爆火: AI Native 的写作出版应该是什么样的? 本文作者:XDash(@XDash)。版权归作者所有,未经授权禁止转载。 7 月 29 日,我在 Claude Code 的辅助下,写完了一本 20.6 万字的新「书」。它原本只是我拿来自学的材料,也是我尝试用 AI 长篇写作的样例。 第二天下午,我顺手把它上传到了 GitHub
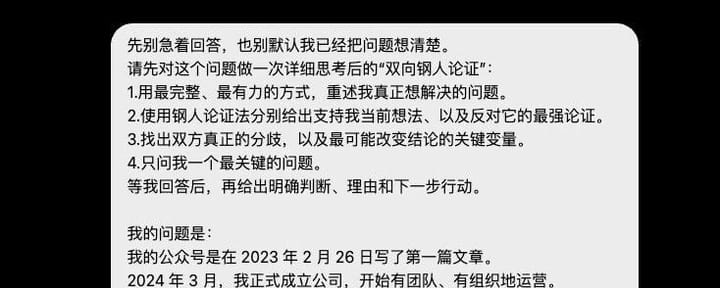
19 Aug 2026 数字生命卡兹克 一个极度实用的深度思考Prompt,帮你挖出最本质的答案。 本文作者:数字生命卡兹克(@Khazix0918)。版权归作者所有,未经授权禁止转载。 前几天,我在推特上刷到了一条很有意思的分享。 原文找不到了,只剩下了这张图。 大概意思就是,先不要让大模型直接回答,先进行一些深度思考,再给你回答。 我顺手也试了一下,效果确实还不错。 里面我觉得最有用的那句可能就是: “让最终答案真正对我有用,而不是给出一份谁都能套用的通用建议。” 但是坦诚的讲,毕竟Prompt这玩意已经快3年半了,都比一坤年还多了一整年,这个Prompt在日常用的时候,确实还可以,但是我觉得还没有到能形成一个很棒的方法论的程度。 于是我又去顺手找了一下上面帖子里面说的Reddit的原文,
19 Aug 2026 泊舟 企业真正缺的不是知识库,而是能自己把事办完的数字员工 本文作者:泊舟(@bozhou_ai)。版权归作者所有,未经授权禁止转载。 这两年我接触过不少企业 AI 项目。大家最先想到的,通常都是搭一个知识库机器人:上传几份文档,让员工或者客户直接提问。 这种应用做起来不难,演示效果也很直观,但真正上线后经常会卡在同一个地方 它能告诉你“故障报修需要提供地址和电话”,却不能接着把地址和电话收集完整; 它能解释某个套餐,却不会根据用户的实际需求做比较,更不会继续生成一张可以交给后续人员处理的工单。 企业愿意长期使用的,不只是一个会回答问题的聊天框,而是一个能理解任务、
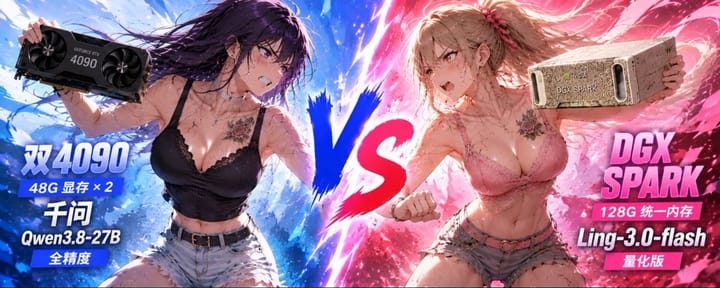
19 Aug 2026 实践哥MinLi 最强的矛与盾:本地部署到底该买什么 本文作者:实践哥MinLi(@MinLiBuilds)。版权归作者所有,未经授权禁止转载。 部署本地模型,是选 NVIDIA DGX Spark,还是选两张魔改 48G 的 RTX 4090? 这两台机器是极度的偏科生。一台内存大得离谱但带宽窄,一台带宽宽得离谱但显存要靠魔改。 选择模型的第一要素是,尽量压榨这两台机器的显存以及算力。因此,选的这两个都装不进一张卡。Qwen3.8-27B 全精度
19 Aug 2026 huangserva 测了2天,消耗大量tokens。10 个维度 50 项:8款前沿大模型能力横评 本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 目录:这篇文章会回答什么 1. 我们做了什么:8 款模型、两轮测试 2. 测试项目:D1–D10、50 个细项 3. 怎么计分:从 0–5 细项到
19 Aug 2026 sitin Codex 一干活就跑偏?先检查这 5 个容易忽略的设置 本文作者:sitin(@sitinme)。版权归作者所有,未经授权禁止转载。 不少人装好 Codex,先去研究模型,再去收藏提示词,最后一口气装十几个 Skill。 忙了一圈,使用体验还是别扭。 让它改一个小问题,它顺手碰了旁边几个文件。任务正在执行,临时补一句要求,不知道它会立刻改方向,还是等前面的工作结束。回复有时太长,有时又省掉了想看的解释。权限收得太紧,读文件、改代码、跑命令一路都在等确认。
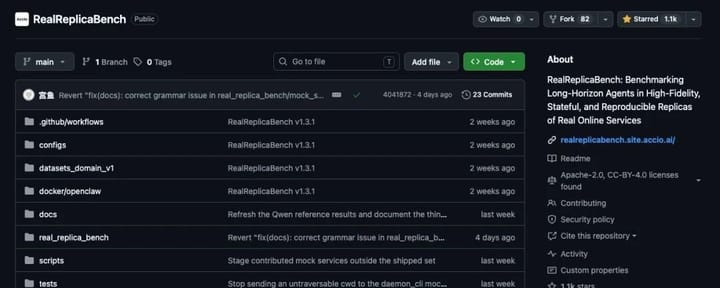
19 Aug 2026 数字生命卡兹克 说一个反常识的真相,Agent如今在真实工作场景的成功率依然很低。 本文作者:数字生命卡兹克(@Khazix0918)。版权归作者所有,未经授权禁止转载。 上周一,我发了自己做的AIHOT大模型排行榜。 有很多朋友感兴趣,在文章下面评论,最高赞的一条,是在问能不能有个分类测评,能够评估不同模型做不同任务的表现。 讲道理,这其实一直是我想做的,也是我觉得特别特别核心的痛点。 现在的大模型榜单很多,比如LiveBench、DeepSWE之类的,可以很快知道哪个模型在某一个能力维度上更强,像Coding、数学、浏览器操作等等。 但是有一类评测集,其实是最稀缺的。 就是模型在真实工作中的实际完成效果。
19 Aug 2026 实践哥MinLi 从发票 Skill到 Mail Agent 本文作者:实践哥MinLi(@MinLiBuilds)。版权归作者所有,未经授权禁止转载。 上半年,我花了2小时,给自己做了一个整理报销发票的 Skill。 它每个月会从几百封邮件里找发票、下载附件、去重、分类,最后生成一张报销表。以前每月要浪费两个小时的事,后来只用跟 AI 说拉一下发票。 那篇文章发出来以后,很多人问: 有没有一种办法,不装 Claude Code、不配