huangserva

huangserva 相关的中文 AI 教程、工具实践和高质量长文整理,来自 AI一起学的精选文章归档。

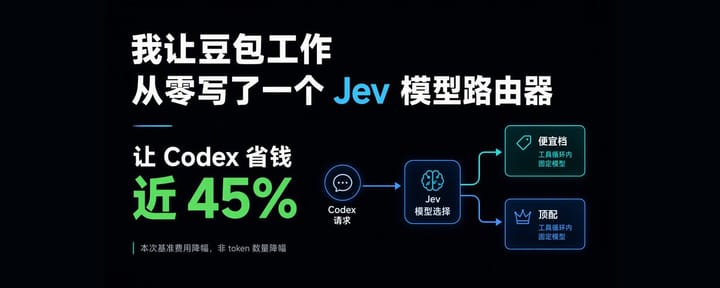
我让豆包工作从零写了一个 Jev 模型路由器,让 Codex 省钱近 45%

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 你有没有发现,Codex 越来越贵,用量越来越少? 用 Codex 的人最近应该都有同感:账单越来越贵,能用的量越来越少。以前一周够用的额度,现在一两天就见底;就算你是 20X 的用户,全程开着顶配模型,也根本顶不住。 我自己就是这样。花钱不是最难受的,最难受的是额度用完了活还没干完,
拿到 Jev,然后呢? Jev 到底能干什么:剔掉虚火之后的一份真实落地清单

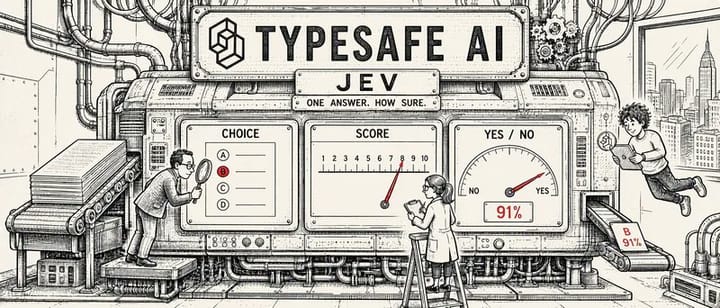
本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 为什么写这篇 Jev 发布不到一周,网上已经满是“快 200 倍”“永不出错”“LLM 要被取代”。我翻了大量帖子,也跑了一批用例,感受是:真把东西做出来的人不多,大多数是转发、观点和“我打算做一个……”。 这篇文章只做三件事:说清

一张废物矿渣卡,价格涨了几十倍:不用改硬件,8GB 显存解锁到 64GB。挖矿的卡,怎么跑上了大模型?

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 一张曾经按斤卖的卡 2022 年以太坊转向权益证明(PoS),挖矿彻底没了生意。一大批矿卡涌进二手市场,其中有一类最惨——不是游戏卡改的矿卡,而是 NVIDIA 专门为挖矿造的 CMP 系列。 CMP 170HX 是这批卡里的旗舰。它没风扇、没视频输出口,插上显示器也不亮;

显存就这么多,怎么把字吐得更快?——从 MoE、KV Cache 到 DFlash 的本地部署全景拆解

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 “一张 16GB 显卡,也能跑 27B 大模型。” 看到这句话,先别急着下载权重。 你还需要知道:用了什么量化?上下文开了多长?模型是否全部放在显存里?所谓“快”,指开始回答快,还是回答时每秒生成的 token 多? 这些条件不同,

GPT‑6 Astra + Blender:不会三维建模,怎么做出第一个自己的作品?

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 不会三维建模,也能做出第一个自己的作品! 兄弟们,Blender 下载了好几次,每次都停在甜甜圈教程? 我也一样。我对 Blender 根本不了解,但这两天让 GPT‑6 Astra 带着做,16 分钟做出一尊能旋转、放大看甲片和衣褶的兵马俑,30

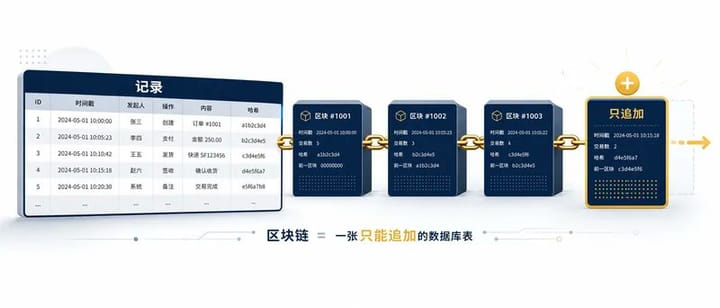
写了好几年代码,还是看不懂链上那套?换成数据库的语言,一篇讲透

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 写了好几年代码,可一翻链上的东西还是发懵?别急着怪自己。 币圈最爱讲金融黑话——HODL、Gas War、Rug Pull、TVL、AMM——绕来绕去,你真正缺的只是一个顺手的模型。把链上那套翻译成数据库的语言,你会发现它跟你天天维护的那张表,真没你以为的那么远。这篇就从底层往上讲,最后落到 OKX

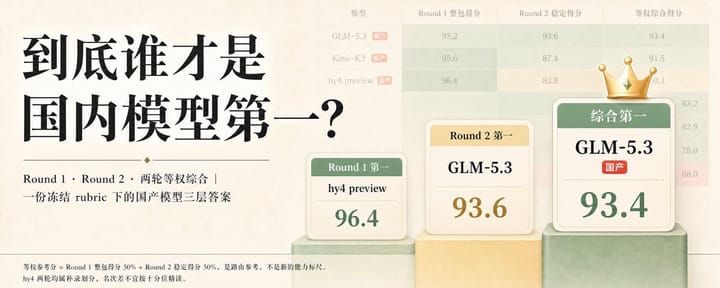
到底谁才是国内模型第一?

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 先说答案:国内模型综合第一,是 GLM-5.3,两轮等权参考分 93.4。 要一个既能整包交付、又经得起反复拆题委派的国产模型,现在的答案就是它。 但这个答案值得花十分钟读完推导过程,因为它不是一路领先赢下来的。 三周前,这个问题还只有一个答案:Kimi-K3——Round 1 超长整包

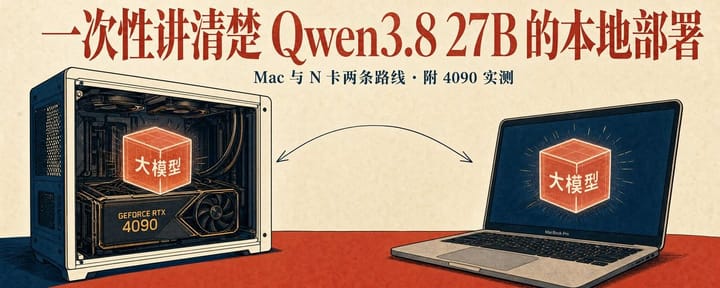
一次性讲清楚 Qwen3.8 27B 的本地部署

本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。 从零开始 · Mac 和 N 卡两条路线 · 附 4090 实测数据 先说一个我自己都没想到的实测结果: 一个 9.83GB 的压缩版模型,在我那 72 道短题上,跟 30GB 的版本打成了平手。
AI一起学
00:00:00 00:00:00