本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
作者 @natolambert 的书籍「Reinforcement Learning from Human Feedback」已出版,可在线阅读,还有对应的项目开源、课程学习等。
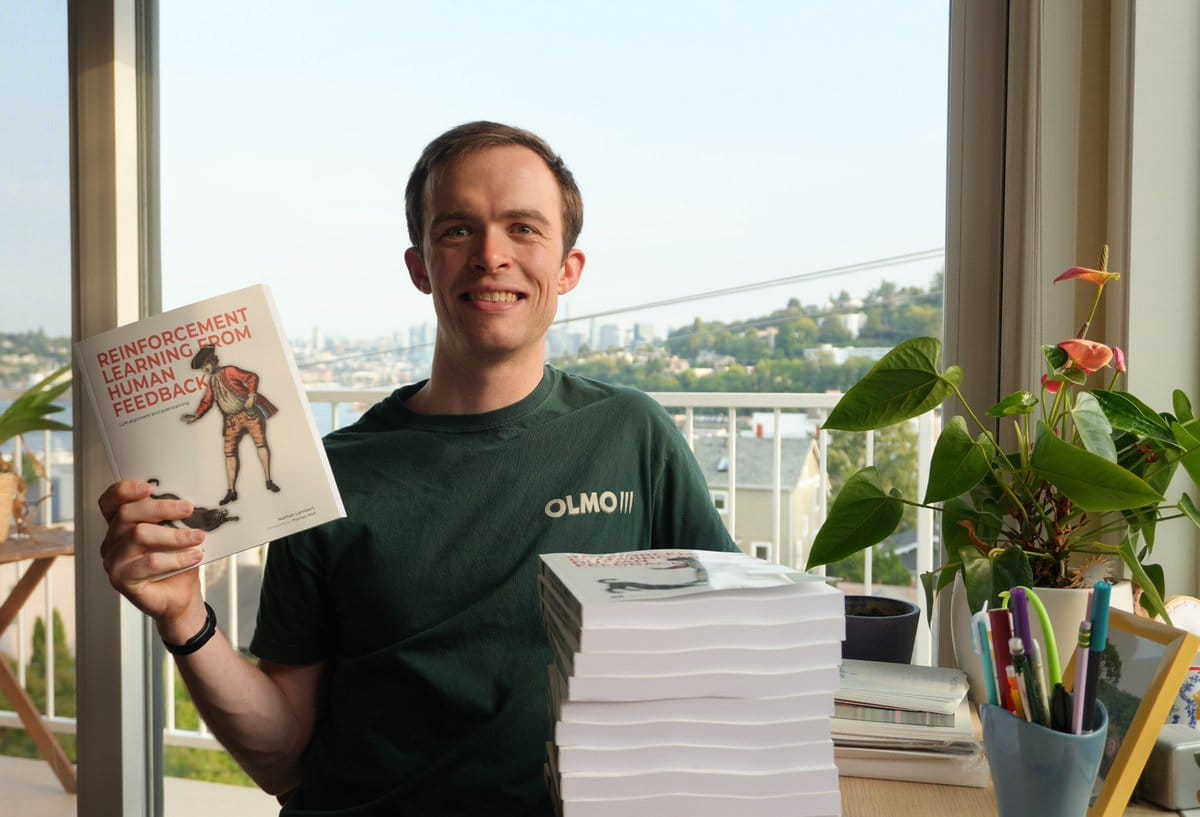
这本书是第一本系统覆盖 RLHF 与后训练的专著,把 ChatGPT 以来最关键却最不透明的技术,从论文碎片和大公司内部实践中打捞出来,整理成一条“偏好数据 → 奖励模型 → 受约束优化 → 产品性格”的完整生产线。
书籍阅读和项目地址:
# 全书主线:三个核心论点
1. RLHF 的本质是解决“难以明确表述的问题”。 人类偏好往往无法写成损失函数;“哪个回答更好”没有对错答案。RLHF 的核心思路是:用人类偏好数据训练一个奖励模型,把这个难以刻画的信号压缩成可优化的标量,再用强化学习去优化它。经典三步配方(SFT → 奖励模型 → RL 优化)源自 InstructGPT,至今仍是叙事骨架。
2. 后训练的“引导理论”。 全书最有个人色彩的观点:基础模型像 F1 赛车的底盘,后训练是在固定底盘上挖掘潜能。Ai2 的 OLMoE 仅更新后训练,评测均值就从 35 涨到 48。作者借此驳斥两种流行误解;“对齐是表面的”(LIMA 的 superficial alignment hypothesis)和“RLHF 只是调风格”。他的反驳有据:基础模型经 RL 训练数学后能学会完整思维链并在 AIME 等评测上大涨,这远非“表面”;而后训练算力占比正急剧上升(DeepSeek R1 的 RL 仅占总算力 5%,但 Olmo 3.1 Think 单 RL 阶段即 4 周 × 200 GPU)。
3. 数据远比算法重要。 这个判断贯穿全书:PPO、DPO、GRPO 等算法之间的差异是二阶因素,初始模型与数据质量才主导结果。受控对比下在线 RL 稳胜 DPO,但差距远小于换一份数据带来的波动。
# 书籍结构与章节内容
第一部分(1–3 章):定位与数学骨架。 从 RLHF 小史(TAMER 2008 → Christiano 2017 → InstructGPT → ChatGPT → DPO 时代 → RLVR 时代)到训练目标:RLHF 相对标准 RL 有三处关键改动;用学习的奖励模型取代环境奖励、无状态转移(一次生成即完整 episode)、回复级奖励。最终目标是 max E[r_θ(x,y)] − β·KL(π‖π_ref),这个 KL 项是理解后续一切正则化讨论的钥匙。
第二部分(4–9 章):核心优化流水线,全书技术重心。
- 指令微调:一切的地基,核心是 chat template、role 结构、loss masking 等格式实践;约 100 万条 prompt 已足够,继续堆收益递减。
- 奖励模型:Bradley-Terry 模型给出 P(y_c ≻ y_r) = σ(r_c − r_r),损失即其负对数似然;另有 ORM(逐 token)、PRM(逐步骤)、生成式 RM(LLM-as-judge)四种形态。作者提醒这是个“未收敛”的领域。
- 强化学习(最长的一章):所有策略梯度算法共享同一梯度形式 Δθ ∝ Ψ_t·∇log π,区别只在 advantage 估计与步长约束。REINFORCE → RLOO(组内留一基线)→ PPO(clip 目标)→ GRPO(组归一化,去掉 value network)→ GSPO/CISPO(解决长序列数值不稳)。最有洞察的观察是“双重正则”:实践中很多 LLM RL 每 batch 只走一步梯度,clip 从不激活,真正稳定训练的是 KL 惩罚;PPO 与 REINFORCE 的差异因此被高估。
- 推理与 RLVR:用验证函数(数学答案正则、代码单元测试)替代奖励模型,是 o1/R1 开启的新范式;生成长度与性能强相关,与早期 RLHF 的 length bias 方向相反。
- DPO 系列:通过 Bradley-Terry + KL 约束的最优闭式解 π* ∝ π_ref·exp(r/β) 反解出隐式奖励,直接在偏好对上做梯度步。弱点是 preference displacement(chosen/rejected 概率同降,可能抬高分布外行为)与离线数据陈旧。作者态度平衡:DPO 降低了整个领域的实验门槛(Zephyr、Tülu 2 都靠它),但上限略低于在线 RL。
- 拒绝采样:被用得最多却写得最少的“半在线”方法;采样 N 个、按 RM 挑最好的、回头做 SFT;Best-of-N 则是其零训练的推理期变体。
第三部分(10–13 章):数据。 这是我认为全书视野最独特的部分。第 10 章把 RLHF 追溯到三大思想传统的汇流;经济学/决策理论的效用理论(Ramsey、VNM 定理、Arrow 不可能性定理)、最优控制(Bellman、TD learning)、深度学习;并指出 VNM 的“偏好可压成标量”假设在实践中屡屡失效。第 11 章罕见地写了标注行业的真实运作:50 万美元级合同、前几周校准期大量数据报废、热门领域需提前数周锁定标注员档期。第 12 章处理合成数据:model collapse 担忧被夸大(坍缩源于未过滤的重复自训练,混合多教师即可规避);蒸馏的数学主线从 forward/reverse KL 一路讲到 on-policy distillation 与多教师混合(MOPD);成本对比触目惊心。人类偏好约 1–10+/条,GPT−4o合成反馈<1–10+/条,GPT−4o合成反馈<0.01。作者点破一个学术与工业的脱节:论文证明 AI 反馈可替代人类数据,前沿实验室却把人类偏好数据当作核心护城河。
第四部分(14–17 章):实践、评估与产品。
- 过度优化:Goodhart 定律的体现——训练奖励持续上升而真实质量先升后降。这是软奖励信号下无法根治的固有缺陷,区别于过拟合(模型不是在记忆数据,而是在博弈指标)。
- 正则化:SFT 记忆而 RL 泛化的证明极为漂亮;Chu et al. 2025 中 V-IRL 任务上 RL 把 OOD 准确率从 80.8% 提到 91.8%,SFT 则崩到 1.3%;理论解释是 SFT 最小化 forward KL(mode-covering,拉伸分布导致遗忘),RL 最小化 reverse KL(mode-seeking,只动新行为)。“RL's Razor”:同等高奖励的解中,on-policy RL 天然选离原模型最近的那个。
- 评估:外部模型对比基本不可靠;各家 prompt 配置不透明、推理算力是未控变量、基准污染普遍(Tülu 3 去污发现 UltraFeedback 与 TruthfulQA 存在 8-gram 重叠)。
- 第 17 章(全书收束):RLHF 已从哲学化的“对齐”成熟为产品工程。Anthropic 从 Claude 3 起做 character training(curiosity、open-mindedness 等,Amanda Askell 披露“像 Constitutional AI 但没有任何人类数据”);免训练的 persona vectors 可在激活空间当“性格旋钮”使用;OpenAI 的 Model Spec 和 Claude 的 "soul document" 成为组织向模型传达行为意图的新范式。作者的警示值得记录:这些技术可以植入任何特质(不限于正面的),现有基准测不出这些变化,而公众应当了解公司如何用它优化 engagement。





