本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
MIT 6.S950《Agency with AI》课程
6.S950: Agency with AI — Effective AI Use in Applied Machine-Learning Projects,MIT EECS 2026 秋季新开的本科课程(12 学分,Course 6 选修),由讲师 Shen Shen 开设。她是 MIT 资深教学讲师,长年主讲 6.390(机器学习导论),拿过 Kolokotrones 教育奖等多个 MIT 教学奖项。先修要求严格:6.390(机器学习)、6.101(编程)、6.121(算法),它默认你已具备扎实的 ML 与计算机科学基础,不教基础,只教 “如何在真实 ML 工程中正确地使用 AI”。
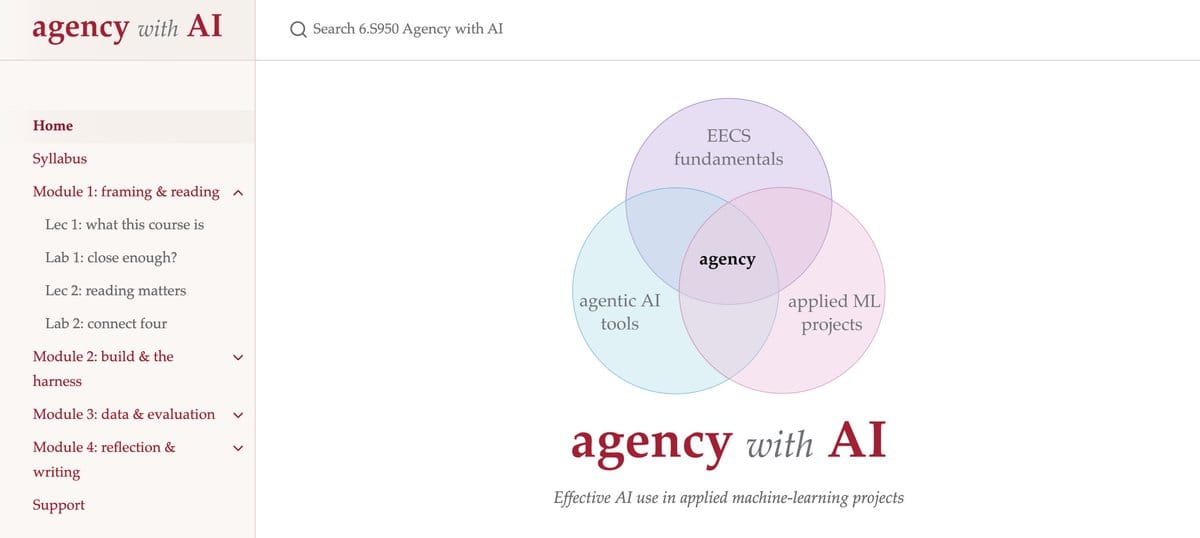
核心理念:课程名中的 "Agency" 才是主角
这门课教的不是“怎么用 AI 工具”,是一种判断力。官网的定义值得原样引述:
Agency, the judgment about what to delegate, what to verify, and what to keep for oneself to do. (代理权——关于什么该委托出去、什么该验证、什么该留给自己亲手做的判断。)
围绕这个核心,课程有一条清晰的学习目标递进链:会用工具 → 知道它为何有效 → 知道它为何“天生会失败”(fail by construction) → 能对每项工作做出委托/验证/重定向/保留的决策并说明理由。
方法论上,课程对每一个 AI 概念和实践都坚持问四个问题:
1.它解决了什么问题?(motivation)
2.提出的方案是什么?(solution)
3.哪些更老的 ideas 能解释它?(old idea)
4.它真正新在哪里?(delta)
这是一种“增量思维”(delta thinking),把 AI 工具放回计算机科学的思想谱系里审视,而不是把它当魔法。课程明确承诺:每个概念都锚定一个已有的 EECS 原理。
课程结构:沿一个真实 ML 项目的生命周期展开
12 讲分四个模块,对应应用 ML 项目(如 UROP、MEng 论文)的四个阶段:
| 模块 | 讲次 | 回答的问题 |
| --- | --- | --- |
| 一、定框与阅读 | 什么是本课 / 阅读为何重要 | AI 时代如何读文献 |
| 二、构建与 Harness | 为何仍要亲手构建 / spec 先于 prompt / git 带来差异 / 编程的抽象阶梯 | 如何与 agent 协作写代码 |
| 三、数据与评测 | 外包的数据 / vanilla transformer 之外的机器 / 评测即实验设计 / 审计制品与裁判 | 如何信任数据和结果 |
| 四、反思与写作 | 人类曾拥有什么 / 结案陈词 | 如何保住作者性 |
讲题起名很见功力,比如 "specs before prompts"(先写规格说明、再写提示词)、"evals as experimental design"(把评测当实验设计来做)、"auditing the artifact and the judge"(不仅审计产出物,还要审计评判者本身,包括 LLM-as-judge 和你自己)。
12 讲课程按模块划分
模块一:定框与阅读
Lec 1 · What this course is(9/15)
内容概述:课程立宪。定义核心概念 agency:对“什么委托、什么验证、什么留给自己”的判断力;确立贯穿全课的方法论:对每个 AI 概念问四问(解决什么问题 / 方案是什么 / 哪些老思想能解释它 / 真正新在哪);铺陈课程主线——沿一个真实 ML 项目走完阅读、构建、数据评测、写作四个阶段;宣布评分契约:AI 使用被默认,但无法说明理由的工作不得分。
解读:这一讲的本质是把一门工程课改写成一门“决策可辩护性”课程。它先立规则再教内容:先声明“我不考核你用不用 AI,只考核你能否为每个决定负责”,后续所有 Lab 的设计(先预测、再实测、留证据、答辩)都是这个契约的执行。四问法是全课的思维骨架:把 AI 现象还原进 EECS 思想谱系,消解新奇感,换取分析力。
Lec 2 · Reading matters(9/22)
内容概述:AI 时代的文献阅读。教四问阅读法如何用于论文:motivation / solution / old idea / delta;展示 AI 辅助阅读的典型失败,看似流畅实则错误的摘要、无法溯源的论断;教如何对照原文验证 AI 的说法(支持 / 矛盾 / 无法判定三种裁决);以及如何把多次 AI 辅助阅读汇编成一张领域地图(field map,学期项目的第一项交付物)。Lab 2 是它的直接实操:先无 AI 粗读留下困惑点,让 Claude 挑战你的理解,挑一个论断回原文验证,再精读对比三方答案。
解读:这一讲处理的是 AI 对研究者最直接的冲击,“读论文”这项技能是否还需要。课程的答案很明确:需要,但重心转移了。阅读的价值从“提取信息”变成“建立可验证的心智模型”,AI 能给你答案,但只有你自己读过原文,才有资格裁决 AI 对不对。Lab 2 里最精妙的设计是 3.3 步:对比自己粗读、精读、Claude 三方的答案,找出自己粗读错得最多的一问,把“AI 辅助阅读”从口号变成了可复盘的对照实验。
模块二:构建与 Harness(以下为基于课程框架的推断解读)
Lec 3 · Why still build(9/29)
推断内容:模块二的哲学开篇。AI 能生成代码,为什么还要亲手构建?预期论点:验证以理解为前提,你看不懂的代码就无法检查;Lab 1 的“close enough”问题在此升华:预测一致不等于行为等价;亲手构建培养的是调试与判断能力,委托会切断这条能力供应链;在 UROP/MEng 语境下,项目是你的,责任无法委托。
解读:“why still build”是整个 agency 问题最尖锐的形式。课程没有站在“AI 禁止”或“AI 万能”任一边,是要给出一个经济学的答案:构建的目的从产出代码转移到了产出验证能力。Lab 1 里那个细节是伏笔,让你先写下“预计 AI 会犯什么错、你是否会犯同样的错”,就是在训练对自己不可委托部分的自知。
Lec 4 · Specs before prompts(10/6)
推断内容:spec 驱动开发。写提示词之前先写规格说明:输入输出、边界条件、验收标准。对应的老思想是软件工程中的需求工程与形式化规格。论点:prompt 本质是一份欠规格的 spec,欠规格导致无法验证;有了 spec,agent 的产出才可检查,人也才能把“想要什么”和“怎么实现”解耦。Lab 1 已埋下伏笔,任务的规格就是 code/README.md,你的自检标准要在见到 AI 代码之前定好。
解读:这是全课最“工程正统”的一讲,也是把 agent 纳入软件工程传统的关键一步。它把“提示词工程”降格为“规格说明的口语化翻译”,你与 agent 的关系不是施法者与魔法,是甲方与承包商,而甲方最重要的文件永远是合同。标题的次序本身就是论点。
Lec 5 · Git makes a diff(10/20)
推断内容:版本控制作为人机协作的基础设施。git diff 让 AI 的每一步改动可审查、可回滚;provenance(出处)与版本历史让 AI 参与的工作保持可检查,这是大纲明列的学习目标;预计还会讲 git bisect 定位 AI 引入的 bug、用提交边界隔离“我写的”与“AI 写的”。
解读:标题是双关(“git 带来差异”/“git 生成 diff”)。在 AI 协作场景里,git 的角色从“备份工具”升级为问责工具,它回答的正是 agency 问题的证据侧:“你说这部分是你验证过的,证据呢?”当产出物由人和 AI 混合写成,版本历史就是责任划分的账本。这也是为什么它紧排在 specs 之后:spec 定义对错,diff 记录过程。
Lec 6 · The abstraction ladder (of programming)(10/27)
推断内容:编程的抽象阶梯,从晶体管、指令集、汇编、高级语言、库、框架,一直到今天的 LLM/agent。预计论点:agent 和 harness(脚手架工程:上下文管理、工具调用、技能封装)是阶梯上的新一层;每一层都靠隐藏下层复杂性换取效率,但 debugging 永远需要下探;上下文管理是这一层的“内存管理”。对应课程声明的主题 context management 与 harness engineering。
解读:这是全课最有历史纵深的一讲。把 LLM 放上抽象阶梯,是一个降维式的祛魅动作:它和编译器、操作系统一样,是“用可控的不透明换取生产力”的又一轮循环,而计算机科学六十年来应对不透明层的整套方法(分层调试、契约式设计、在层边界设检查点)全部可以直接迁移到 agent 上。学会了这讲,你就知道为什么前五讲的 spec、git、验证缺一不可。
模块三:数据与评测
Lec 7 · Outsourced data(11/3)
推断内容:审查外包数据。你不是数据的采集者时,如何信任它:来源与许可、采集协议、合成数据与污染(contamination)、分布漂移、标注质量。对应学期项目明列的组件“vetting of outsourced datasets”,也呼应 Lab 1 的剧情,两家公司合并后,对方的分类器输出能不能用?
解读:ML 课程传统上教“怎么用数据”,这一讲教“怎么不信数据”。在 agent 时代这个问题被放大了三倍:AI 能批量生成数据和标注,成本趋零意味着污染风险趋无穷。老原理是 garbage in, garbage out,但课程会指出新变化:以前垃圾是意外混入的,现在垃圾可以是自动化生产的。
Lec 8 · The machinery beyond vanilla transformers(11/10)
推断内容:全课技术含量最高的一讲。6.390 教的是 vanilla transformer,而现代 LLM 在其上叠加了大量机器:后训练(RLHF)、专家混合、长上下文、检索增强、工具调用、推理模型。预计逐层拆解这些机制,并论证每个机制如何在构造上(by construction)导致特定失败模式,对应学习目标“知道它们为何天生会失败”。
解读:这一讲是整门课的科础。它兑现课程的核心承诺:只有懂机制,才能预测失败,而不是靠玄学口诀。这也是先修要求卡死 6.390 的原因,不懂 attention 就无法理解长上下文的“中间迷失”,不懂优化就无法理解后训练的目标错位。"fail by construction"这个措辞很精确:失败不是 bug,是设计权衡的必然代价,知道机制你才知道代价清单。
Lec 9 · Evals as experimental design(11/17)
推断内容:把评测还原为实验设计。假设、对照、混淆变量、统计功效;基准设计的经典陷阱,过拟合基准、数据污染、Goodhart 定律(指标一旦成为目标就失效)。教如何为第 8 讲学到的失败模式设计能测出它们的评测。
解读:标题的括号里藏着立场:eval 不是“跑个 benchmark”,是统计学里做了百年的实验设计。LLM 评测的乱象(刷榜、模型见过考题)在心理测量学和 A/B 测试里都有百年前的对应物。课程在这里完成一次示范性的“delta 思维”:评测 LLM 这件看似全新的事,九成是实验设计原理的重新应用,真正新的只有一成,而那一成恰好是第 8 讲的机制决定的。
Lec 10 · Auditing the artifact and the judge(11/24)
推断内容:双重审计。审计制品(artifact):模型输出、代码、数据集的系统性检查;审计裁判(judge):当 LLM-as-judge 被用来评 LLM,裁判本身有偏,自我偏好、位置偏差、长度偏差;更深一层,人也是裁判,人审同样有偏。对应项目组件“auditing of artifacts and judges”。
解读:这是模块三的逻辑闭环,也是全课最认识论的一讲。第 9 讲教你怎么评,第 10 讲提醒你:你用来评的那个东西本身也需要被评。递归在这里出现,AI 生成、AI 评审、AI 仲裁的链条里,任何一环的偏差都会被下游放大。而把“人类判断”也放进被审计之列,是这门课一贯的诚实:它不把人设为金标准。
模块四:反思与写作
Lec 11 · What the human had(12/1)
推断内容:回顾 AI 之前人类研究者拥有什么:作者性、署名与责任、品味与问题意识、默会知识(tacit knowledge)、对错误的直觉。追问哪些可以委托、哪些委托了就会消失。
解读:这是全课的情感与哲学重心,标题用过去时 "had" 而非 "have",本身就是一个尖锐的判断。它不做怀旧演讲,是接着第 1 讲的 agency 问题给出最终账目:委托的隐性成本是能力的萎缩,你委托掉的每一种实践,都是你在放弃成为的那种人。对一门以“有效使用 AI”命名的课来说,这讲的存在说明它清楚自己在教一把双刃剑。
Lec 12 · Closing arguments(12/8)
推断内容:结课。预计包含:学生为自己的委托/验证/保留决策做总结辩护(呼应“closing arguments”的法庭隐喻);一页纸摘要(claim / evidence / limits)作为学术写作的终型;对课程自身论断的回顾,哪些被学生自己的实践支持、哪些被质疑(portfolio 要求的第三个组件正是“三个支持或挑战课程论断的 AI 使用案例”)。
解读:标题选得极好。整门课的评分哲学就是“可辩护性”,那么结课自然是一场结案陈词,你不是来交作业的,是来为自己一学期的每个决策当庭陈述的。而它要求学生的案例可以反驳课程自己,这是教学设计里罕见的自我怀疑条款,与第 10 讲“审计裁判”形成首尾呼应:连这门课自己的论断,也在被审计之列。
Lab 设计:这门课最精彩的部分
已发布的两个 Lab 展示了独特的教学法:每个环节都精确控制 AI 在场与否。
Lab 1 "Close Enough?":实现一个 kNN 分类器。第一步禁用 AI,先写下你的时间预估、AI 首次实现正确率的预估、预期它会犯什么错、你会用什么检查来判定“通过”;第二步才允许用 Claude 实现,跑自己的检查,导出对话作为证据;第三步对比另一家公司的现成实现,预测结果相同是否等于可互相替换?Checkoff 时必须不借助 AI、凭自己的笔记向助教答辩。这个 Lab 的巧妙之处:它把“委托决策”变成了实验对象本身,你先预测 AI 的行为,再实测,再复盘。
Lab 2 "Connect Four":用四问法精读论文对(如 Batch Norm → Layer Norm,或 Prompt-to-Prompt → InstructPix2Pix)。流程是:无 AI 粗读并留下困惑点 → 让 Claude 挑战你的理解、讲解卡壳处 → 挑出 Claude 的一个论断,回到原文验证(支持/矛盾/无法判定)→ 无 AI 精读两篇原文 → 三方对比(粗读 vs 精读 vs Claude 的答案),找出自己粗读错得最多的地方 → 带着改进策略去读第三篇论文。这本质上是把“AI 辅助阅读”变成可复盘、可迭代的实验。
考核:评分标准本身就是课程宣言
• 30% Lab checkoff:答辩制,必须能解释自己的工作;
• 40% 学期项目:可复用现有 UROP/MEng 项目,按“一页摘要(claim / evidence / limits)+ 代码仓库”评分;
• 30% 个人资产库(portfolio):从自己工作流中提炼的三份 SKILL.md(可复用的 AI 工作流),加上三个自己实际使用 AI 的案例,且案例需支持或质疑课程中的某个论断。
最重要的一条政策:AI 使用被默认且不按数量评分,但任何你无法说明理由的工作,无论多精美,都不得分。
我对这门课的感受
这门课的意义在于它是 MIT 对“AI 时代工程教育”的一次系统回答,有三个鲜明立场:
1. 不是又一门工具课,是判断力课。 它把教学的重心从“产出”移到“决策的可辩护性”,每个环节都要求你留下证据链(导出的对话、版本历史、原文引用、时间预估 vs 实测),让 AI 参与的工作保持可检查(inspectable)。
2. 技术深度没有被牺牲。 第 8 讲直接进入 transformer 之后的机制层面去解释 LLM 的失败模式,Lab 2 要求真的读懂 Batch Norm 的 batch 依赖性这类细节。它的立场是:只有懂机制,才能预测失败,这正好呼应先修要求里的 6.390。
3.把“人性化的部分”课程化了。 第 11 讲 "what the human had"(人类曾拥有什么)和写作模块明确处理作者性、署名与责任这些多数工程课程回避的问题。