本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
台大李宏毅机器学习 2026 课程
台湾大学电机系李宏毅(Hung-yi Lee)教授的机器学习课程,2026 春季学期版(3 月初开课,6 月初结束,共约十一个授课周)。这门课在全球中文机器学习社区中地位特殊:李宏毅的授课录像从 2016 年起每年公开在 YouTube 上,以其中文母语讲解、紧跟前沿的选题和自嘲幽默的风格,成为几代中文学习者入门深度学习的事实标准教材。2026 春季这一版,标志着这门课完成了从“经典机器学习课”到“大模型时代前沿课”的彻底转型,课纲里已经找不到 regression、SVM、CNN、RNN 这些传统主角,取而代之的是 AI Agent、推理加速、模型自我进化等主题。
课程主页 https://speech.ee.ntu.edu.tw/~hylee/ml/2026-spring.php
视频列表 https://www.youtube.com/playlist?list=PLJV_el3uVTsMOzDAUQ0cj9oLqEnqTSBkl
课程主线:一条清晰的四幕叙事
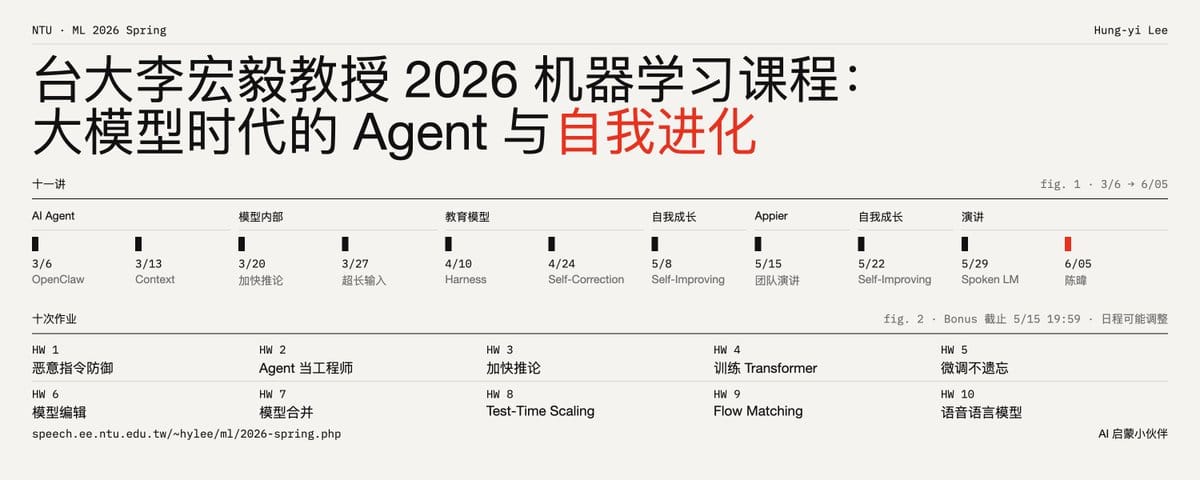
如果把十一次授课排开,会发现它不是主题的简单罗列,是一条精心设计的叙事线,“用模型 → 懂模型 → 教模型 → 让模型自己长大”。
第一幕:AI Agent(3/6、3/13)
课程以 Agent 开场而非以神经网络开场,这本身就是个强烈的信号。第一讲以开源项目 OpenClaw 为例讲解 Agent 的运作原理;第二讲进入 Context Engineering(上下文工程)与多 Agent 互动,并讨论 Agent 对学术研究范式的冲击。
值得注意的是"Context Engineering"这个术语,它是 2025 年流行起来的概念,指的不再是如何写好单条 prompt(Prompt Engineering),是如何系统性设计 Agent 所处的信息环境:记忆管理、工具结果的组织、多轮对话的状态设计。课程还专门讨论 Agent 对学术研究的冲击,这暗示李宏毅认为 Agent 不是众多应用之一,是会改变研究本身的基础设施。
第二幕:深入模型内部架构(3/20、3/27)
两讲分别回答两个工程核心问题:
•如何加快推理速度:讲 Flash Attention 与 KV Cache。前者是 GPU 显存带宽受限下对注意力计算的 IO 感知重排(如今所有主流推理框架的地基),后者是大模型自回归解码时缓存历史键值、避免重复计算的技术。没有这两项技术,就没有今天可用的 LLM 服务。
•如何处理超长输入:讲 Positional Embedding(位置编码)。从绝对位置到 RoPE 及其外推/插值变体,这是长上下文能力的理论核心。
这一幕的定位很明确:不是让你从零推导 Transformer,是让已经会用 LLM 的人理解系统的性能瓶颈和能力边界从何而来,这决定了你能否诊断“为什么慢”“为什么长文档中间的内容模型看不见”。
第三幕:如何教育模型(4/10、4/24)
标题用了“教育”而非“训练”,非常耐人寻味。两讲分别是:
•Harness Engineering:不改动模型权重,是通过精心设计的运行环境、工具接口和反馈回路让同一个模型表现更好。这是 2025–2026 年新兴的术语,与第一幕的 Context Engineering 呼应,改善模型的路径从“改数据再训练”转向“改环境即改善”。
•Self-Correction(自我修正):让模型发现自己错误并修正,包括推理阶段的自我审查与验证机制。
这一幕代表了一种范式转移的认知:模型能力的提升,未必来自梯度下降,而可以来自“教养方式”的改变。
第四幕:模型的自我成长(5/8、5/22)
这是全课程最前沿的部分,甚至延伸到了研究界尚未定型的领域:
•Self-Improving:模型通过自身生成的数据和反馈循环来提升自己,摆脱对人工标注数据的依赖。
•Self-Evololving Agent(自我进化智能体):Agent 在执行任务的过程中积累经验、自我改进,这是 2025 年底至 2026 年最活跃的研究方向之一。
从第三幕到第四幕的递进关系很清楚:第三幕是“人来教育模型”,第四幕是“模型自己教育自己”。这也是课程叙事的终点,从人类手把手教,到模型自主成长。
收尾与客座内容(5/15、5/29、6/5)
穿插了三场客座演讲:Appier Research 产业界团队(广告科技中的 ML 应用)、两位同学关于 Spoken LM(语音语言模型)的演讲、以及陳暐教授的专题。Spoken LM 同时也是最后一次正式作业的主题,说明语音-语言一体化建模被视为值得学生动手实践的方向。
作业体系:与课程主线严格同构
十次作业(外加一个 Bonus 竞赛和一次工具教程)几乎逐周对应授课主题,且选题相当“硬核”:
| 作业 | 主题 | 对应授课 |
| --- | --- | --- |
| HW1 | LLM 恶意指令防御 | LLM 安全 |
| HW2 | AI Agent 当 AI 工程师 | Agent 篇 |
| HW3 | LLM 快速推理 | Flash Attention / KV Cache |
| HW4 | 训练 Transformer | 模型内部机制 |
| HW5 | 不遗忘的微调(Finetuning without Forgetting) | 模型教育 |
| HW6 | 模型编辑(Model Editing) | 模型教育 |
| HW7 | 模型合并(Model Merging) | 模型成长 |
| HW8 | 测试时扩展(Test-Time Scaling) | 推理与自我修正 |
| HW9 | Flow Matching | 生成模型新范式 |
| HW10 | 口语语言模型(Spoken LM) | 收尾专题 |
几个值得展开的观察:
1.HW2「AI Agent as an AI Engineer」极具象征意义,让学生搭建一个能自己做机器学习工程的 Agent,这等于把课程第一幕的主题直接变成考核内容,也呼应了“Agent 冲击学术研究”的课堂讨论。
2.HW5–HW7 构成一个“后训练三部曲”:微调如何不灾难性遗忘旧能力 → 如何精准编辑模型中的具体知识 → 如何把多个各有所长的模型合并成一个。这是当前开源模型社区(合并模型、LoRA 生态)的核心工程问题。
3.HW8 Test-Time Scaling 对应让模型在推理阶段花更多算力换取更好答案(o1/R1 式推理范式的技术基础),HW9 Flow Matching 则是扩散模型之后新一代生成建模框架,说明课程虽以语言模型为主轴,但没有放弃生成模型。
4.每次作业都配套视频讲解、PDF 讲义和 Colab 代码,提交走 NTUCOOL(台大教学平台)、Kaggle 或系上评测平台,作业即完整的上手机器学习工程流水线,而非纸面推导。
学术诚信规则
课程的规定延续了李宏毅历年风格,其中一条措辞颇为著名:禁止与 "any living creatures"(任何活着的生物)分享代码或预测结果,即不限于同学,向任何人(包括在网上求助)泄露代码都在禁止之列。使用外部资料必须引用;手改预测文件视为违规。首次违规该次作业零分且总成绩打九折,一学期再犯直接 F。这套规则的实际语义是:鼓励你查资料、读文档、用一切公开知识,但代码和结果必须是你自己产出的。
页面未公布具体的成绩配比(历年通常以作业为主,具体以 NTUCOOL 公告为准),且课纲标注"tentative and subject to change"(暂定,可能调整)。
这门课透露的学科趋势(个人解读)
把 2016 到 2026 十年的课纲连起来看,这门课的演变就是整个领域的演变史:2016–2019 讲的是从回归到 GAN 的经典深度学习;2020–2023 转向自监督学习与 Transformer 一统;2024–2025 出现 LLM 微调、RLHF;而 2026 春季这一版,完成了最后一次转身,课程的重心从“如何训练一个模型”变成了“如何与一个强大的模型共处、理解它、教养它、并让它自我进化”。
具体来说,2026 版课纲隐含三个判断:
1.Agent 是新的应用层范式,以至于值得占据开篇两讲加多次作业;
2.系统级工程能力(推理加速、长上下文)与算法能力同等重要,理解 Flash Attention 和 KV Cache 已经是“懂 LLM”的一部分;
3.后训练(post-training)时代的重心正在从“喂更多数据”移向“设计更好的环境与反馈回路”,最终指向模型自我进化这一前沿。
换句话说,这门课教的对象,正在从“未来的算法研究员”扩展为“未来所有需要驾驭大模型的工程师与研究者”。
给学习者的建议
•适合谁:已具备深度学习基础(至少了解 Transformer 基本结构)的学习者。纯零基础者建议先看李宏毅 2025 年的导论课程,课纲中它正是作为先修材料被列入的。
•最佳使用方式:视频 + 讲义 + 作业三者并行。这门课的价值有相当一部分在作业里,十次作业覆盖了 LLM 安全、Agent 搭建、推理优化、后训练的完整技能面,光看不练等于只读了一半。
•预期收获:学完后你应当能够看懂 2025–2026 年 LLM 领域绝大多数论文的动机与方法章节,并具备动手做推理加速、微调、模型合并、Agent 系统的工程起点。
•时效性:李宏毅的课程录像历来在学期结束后完整公开于 YouTube,往届(2016–2025)课程也都可以在他官网找到,可以对照观看,感受领域变迁。