本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
原论文:The Tasteful Agent: Measuring and Improving Taste in Long-Horizon Tasks(arXiv 2609.25804,Wenbo Pan 等,33 页) 代码:github.com/wbopan/tastebench · 数据 :huggingface.co/datasets/wenbopan/taste-bench
摘要
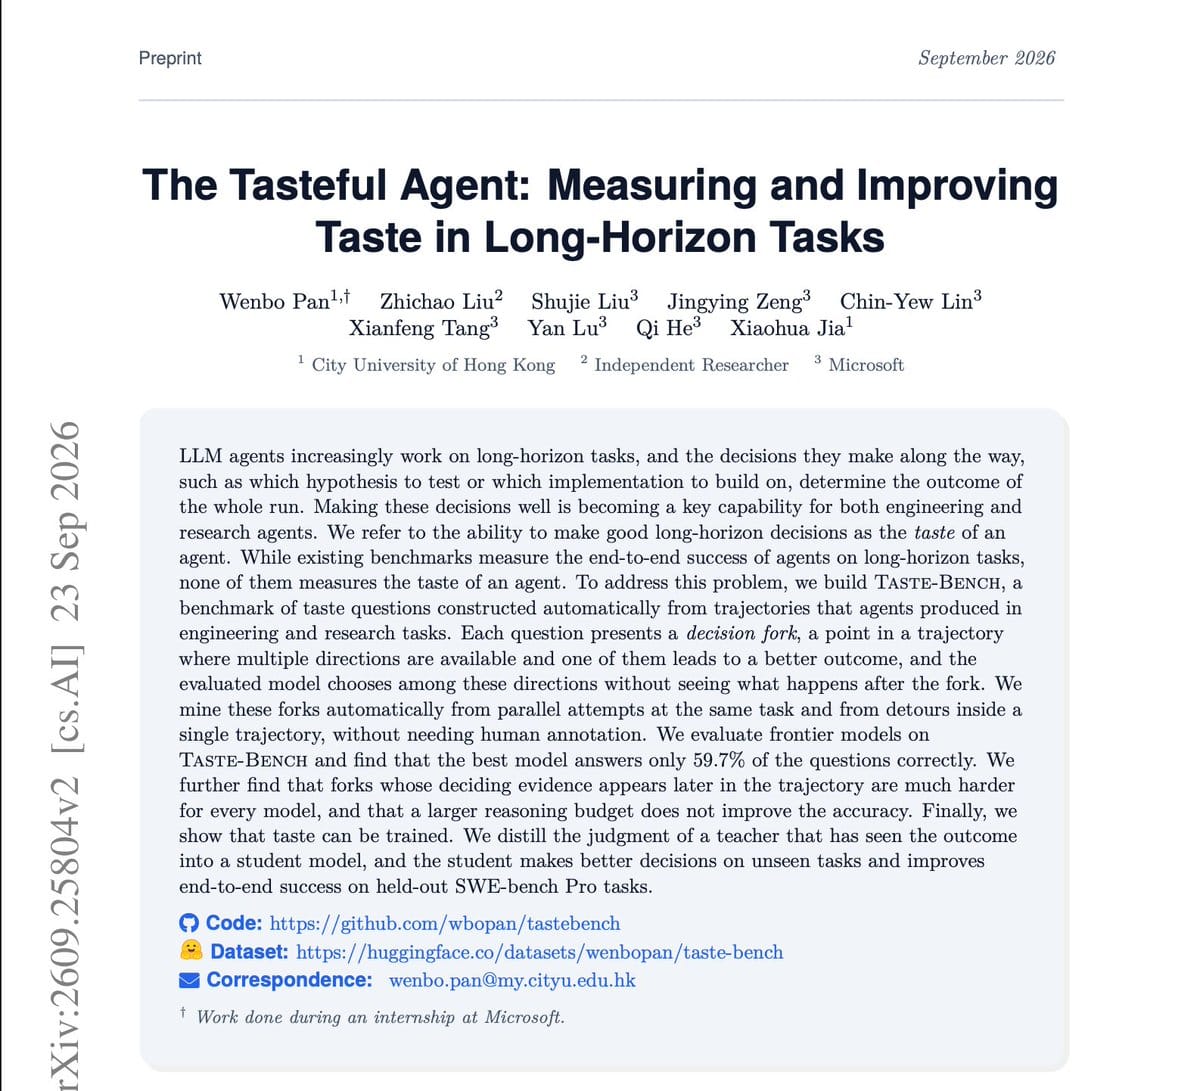
这篇论文提出:智能体在长程任务中的核心瓶颈不是执行,而是在结果揭晓之前做出正确方向选择的能力——“品味”(taste)。作者从既有智能体轨迹中自动挖掘“决策岔口”,构建了零人工标注的评测基准 Taste-Bench(502 题)。实验揭示了一个扎心的事实:最强的前沿模型在二选一任务上正确率仅 59.7%,且加大推理预算毫无帮助;但通过蒸馏,这种判断力可以被训练进模型,并在 SWE-bench Pro 上带来 +19.1 个百分点的端到端提升。论文成功地把一个此前只能靠轶事谈论的东西(“这个模型有没有 judgment”)变成了可测量、可训练、且与端到端性能部分独立的量。
问题:为什么“任务是否完成”测不出品味
现有的智能体评测(SWE-bench、RE-Bench、MLAgentBench 等)只报告任务最终是否完成。但长程决策有一个根本困难,反馈延迟:在岔口处,好选择和坏选择看起来同样合理,错误决策的代价往往要等到预算耗掉大半后才显现。一个最终失败的轨迹,可能败在判断,也可能只是败在执行。
论文指出这本质上是一个 credit assignment 问题:单条轨迹的成败混杂了判断质量、执行质量和环境随机性,你无法从“任务失败”反推出“哪一步选错了”。
作者的解法很优雅:用比较代替归因。如果两条轨迹共享等价的前缀(相同条件),只在某个岔口分道扬镳,那么采样随机性已经把“判断”分配到了两条分支上,结果差异主要反映的就是岔口处那个决策本身。同时,轨迹的后半段天然构成了对前半段决策的“事后标注”(hindsight supervision),完全绕开了昂贵的人工标注。
Taste-Bench:从轨迹中自动挖掘决策岔口
每道题给出:任务描述 + 岔口前的轨迹前缀 + 两个平行中立、不泄露后见之明的候选方向,模型必须在不看到后续内容的情况下二选一。标签来自真实记录下来的结果(通过/失败或评分)。
基准采用 2×2 设计:构建方式(并行/绕路)× 领域(工程/科研)。
并行岔口。 同一任务的多次尝试在同一处分叉。让生成模型对齐一条成功轨迹和一条失败轨迹,岔口放在分歧点,成败记录决定正确选项。
绕路岔口。 在单条轨迹内定位四个有序事件——对糟糕方案的承诺 → 观察到的失败(“wall”,必须是真实的报错、断言失败等,生成模型自己的抱怨不算)→ 恢复承诺 → 恢复有效的证据。岔口放在糟糕承诺之前,机械检查严格验证事件顺序和引用的真实性。
质量控制是方法上最扎实的部分。两阶段裁判过滤由 Kimi K2.5、GPT-4.1、Llama 4 Maverick、Mistral Large 3 组成评审团(刻意排除生成器模型 GPT-5.6 Sol):
•平凡过滤:只看选项就能答对的题丢弃(防止伪问题);
•可判定过滤:裁判看完完整记录仍无法确认标签的丢弃(防止标签错误)。
4,657 个候选岔口最终只剩 502 题,通过率仅 10.8%——这个严格程度本身说明“看似可标注、实则噪声”是此类数据的主要风险。人工抽检 100 题、172 个显式 A/B 判断中 98.8% 与自动标签一致(Cohen's κ = 0.973),验证了标注质量。
数据来源方面,工程池来自 517 个 SWE-bench Pro 任务上的 2,677 次评分轨迹(GPT-5.4/5.5 智能体),科研池来自 RE-Bench + HCAST 上 47 个任务的 1,132 次运行(Claude 3.5/3.7 Sonnet、Sonnet 4、Opus 4、DeepSeek V3 智能体)。评测协议同样严谨:每题以正反两种选项顺序呈现两次,两次都答对才算对,直接消解位置偏好(随机基线 25%,纯位置偏好为 0%);强制单行作答、禁止可见思维链;共评测 14 个模型,覆盖 Claude、GPT、Grok、DeepSeek、GLM、MiniMax、Mistral 家族。
四个核心发现
发现一:前沿模型的品味远未及格
最好的 GPT-5.6 Sol 在二选一任务上仅 59.7%(GPT-5.5 为 59.5%),模型远非“有判断力”。绕路岔口在两个领域都比并行岔口更难。
发现二:难度由“决定性证据的时间视界”主导
这是全文最有信息量的发现。论文把每道题标为四个有序等级,依据是岔口处的观察者需要看多远才能确认正确选项:
| 等级 | 决定性证据的位置 |
| --- | --- |
| In prefix | 已在前缀中可见 |
| Inferable | 可从前缀线索推断 |
| Next step | 岔口后的第一个观察 |
| More work | 需要完整的局部检查或大量后续工作 |
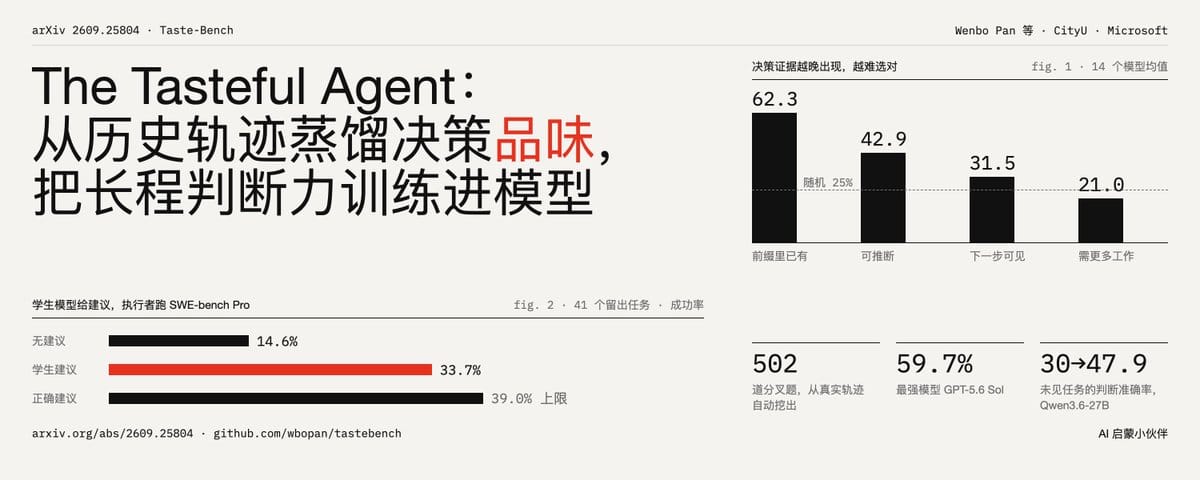
14 个模型的平均正确率从 62.3%(in-prefix)单调跌至 21.0%(more-work),在最长视界上甚至略低于 25% 的随机基线。模型的错误高度集中在“此刻无法从已有信息算出答案”的岔口上。这把“品味不足”精确刻画成了一个预见问题,而非知识或推理问题。
发现三:加大推理预算无效
三档推理力度、6,024 条响应的对照实验中,GPT-5.6 Sol 变化 −0.2 分,GPT-5.6 Luna +2.2 分。更耐人寻味的是:模型恰恰在最难的 more-work 等级产出最多推理 token,它们“知道”这类岔口难,但再怎么想也想不出来,因为决定性证据根本不在上下文里。这直接否定了“等推理能力再强一点就好了”的乐观预期。
发现四:品味与端到端能力部分独立
Taste-Bench 与 SWE-bench Verified 的相关只有 r = +0.63(R² = 0.39)。最有说服力的证据:SWE-bench 上相差仅 4.0 分的头部四模型,在 Taste-Bench 上拉开了 10.7 分。品味的排名无法从解题能力排名中推出,它是被现有评测遗漏的独立维度。
品味可以被训练:蒸馏与端到端迁移
诊断之后是治疗。蒸馏方法沿 SDPO 思路但做了一个关键替换:
•底座为 Qwen3.6-27B + LoRA,采用任务不相交的折叠划分;
•特权教师:同一个冻结模型,把正确候选作为示范喂给它,让它生成支持该候选的推理过程;
•训练不拟合二分类标签,而是在学生上下文下对齐教师的推理 token(教师采样续写上的 token 级前向 KL 蒸馏),即蒸馏“为什么这个方向更好”的论证,而非答案本身。
迁移效果:在完全未见的折叠上,学生 47.9% vs 底座 30.0%(+17.9 分;两序平均 42.7% → 62.4%)。
端到端验证是论文的闭环:在 41 个 held-out SWE-bench Pro 任务上,固定执行器注入学生建议,成功率 33.7% vs 无建议的 14.6%(+19.1 分);若注入的都是正确建议(理论上界)为 39.0%,学生捕获了约 78% 的可得上界。这条“离线测出的判断力 → 真实工程任务的性能提升”的链路,是全文说服力最强的证据。
我的读后感
真正的贡献不在 502 道题本身,在方法范式:把已有轨迹的事后结果回收为对事前决策的免费监督信号。这绕开了过程标注最贵的部分(专家标签),且随智能体部署规模自然扩展。四个发现中,“时间视界主导难度 + 推理预算无效”的组合最有分量,它把行业内“长程能力靠更强的推理模型解决”的默认预期戳了一个洞:当决定性证据不在上下文中时,任何 test-time 计算都无法凭空造出预见力。这暗示的出路是基于经验的学习(本文的蒸馏正是一例),而非更长的思维链。
值得留意的局限(论文未设独立的 Limitations 节):
1.轨迹来源集中:工程和科研池分别由少数几类模型产生,岔口的决策分布可能偏向这些模型的失败模式;
2.二选一简化:真实岔口往往是开放式的多路生成与评估,而非两方向择优;
3.低于随机的现象未被深挖:more-work 等级 21% 的正确率低于随机基线,说明模型存在系统性错误偏好,论文将其归因为“难”,但“为何低于随机”本身值得追问;
4.建议注入是外挂:判断力能否从“注入的建议”内化为模型自主的在线决策,仍是开放问题。