本文作者:Berryxia.AI(@berryxia)。版权归作者所有,未经授权禁止转载。
申明:部分内容是有AI协助完成,如你对AI敏感,请立即退出,以免引起不适谢谢。
今天在 X 上刷到一个帖子,感觉又一个国产之光来了。我发了一个帖子,有人叫好,有人也表示质疑? 原贴如下:
官方介绍里各项指标都拉满,非常牛逼。
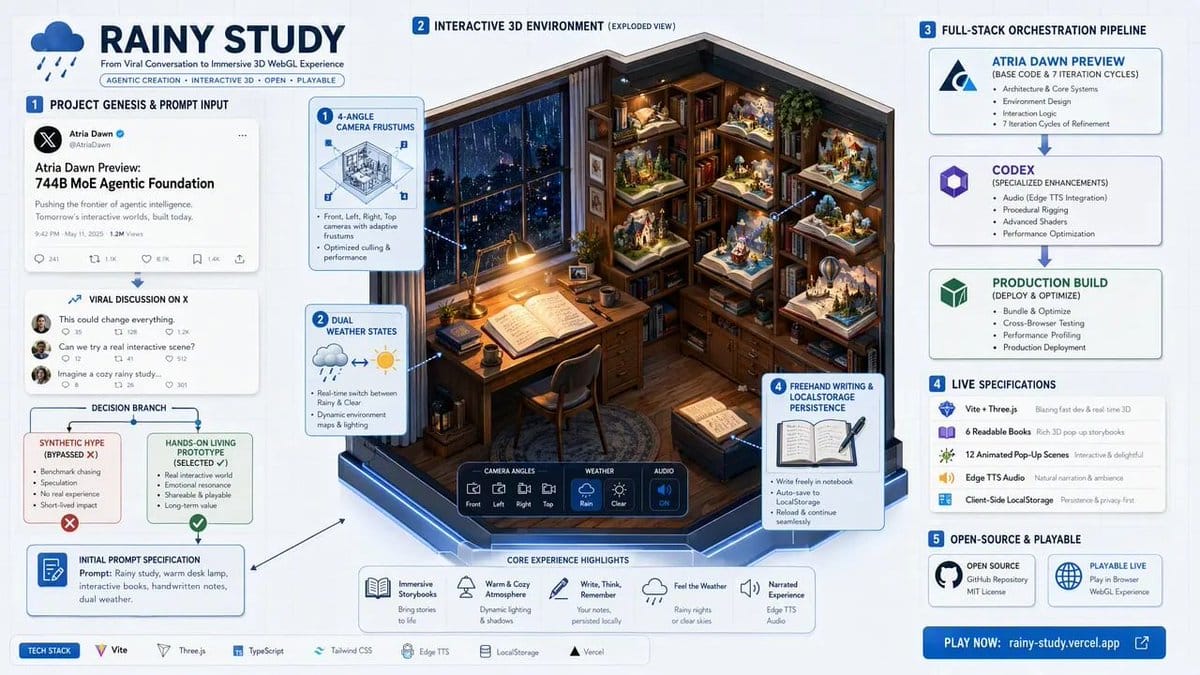
说实话,这种场面我今年见得太多了。新模型一出,跑分截图先飞一圈,对标表贴一墙,至于拿到手上能干啥?没人细说。
这回我不想跟着喊“掀桌子”。我想自己把它拉过来,安排一件实实在在的活儿,看看它到底能交出什么东西。
最近满屏都是 GPT-6 Astra 玩 Three.js、搞 3D 建模,各种能转能动能交互的东西,手痒得不行。Atria Dawn Preview 自己也把交互应用和软件构建列在体验方向里。那好,交给它一个具体场景,看它能走到哪一步。
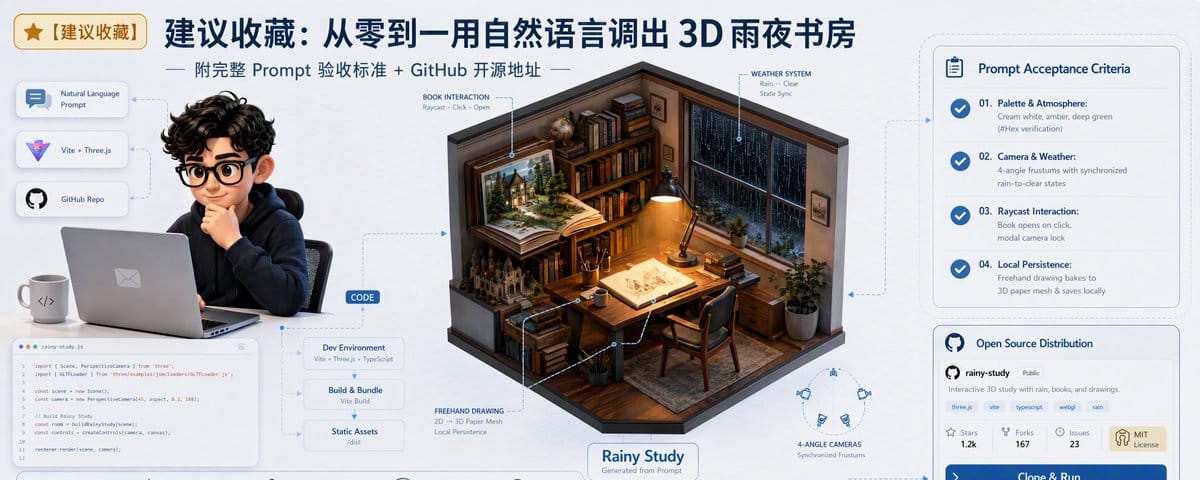
题目是这样的:做一间雨夜书房。窗外下雨,桌上点灯,书架上的书能拿下来读,桌子上的纸笔可以书写。 我习惯拿自己想用的东西当考题,要求不复杂但也不含糊:要能观察、能阅读、能留下内容,碰到问题还能继续改。
围绕这个起点一路实测、修改、加手写、加立体绘本,最后就有了现在这个项目。代码已经开源,在线版可以直接玩。
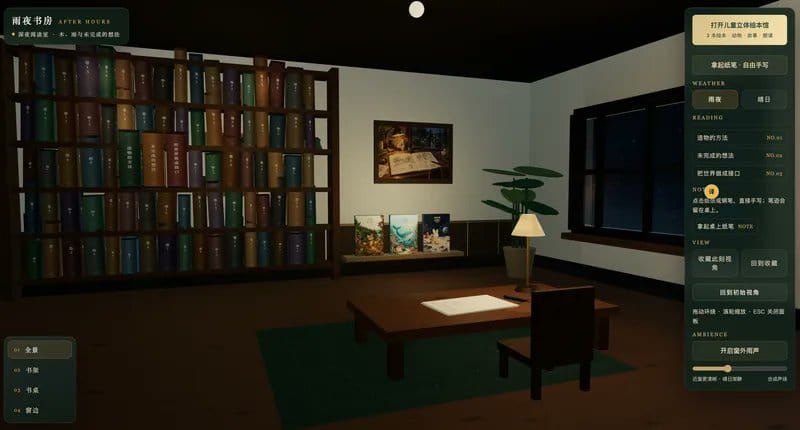
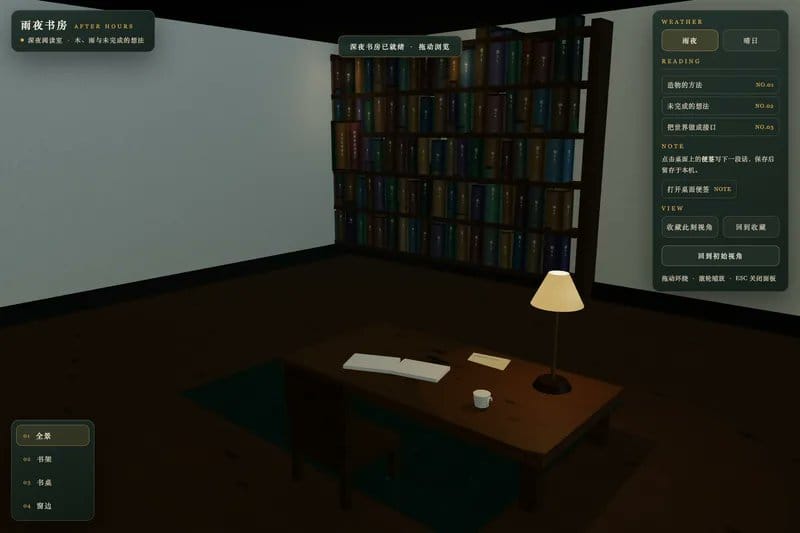
窗外下着雨,桌上亮着暖灯。书架上的书可以拿下来翻,桌上的纸笔能直接写画,笔迹保存后下次打开还在。翻开一本儿童绘本,小狐狸、鲸鱼和月兔会从纸页里立起来,带着故事、动画和中文朗读。
想逛就进去逛,想改就把代码拿走,换上自己的故事,改成自己的房间。
这间书房怎么来的?我先用 Atria Dawn Preview 的 API 生成书房主体,运行中碰到问题就反馈回去让它改;手写、立体绘本和后面的动态场景,交给 Codex 接着做。比起先聊参数,我更想直接带你走进这个项目:一段自然语言描述,到底能变成多少你可以亲手操作的东西?
一间 AI 做出来的书房,最容易记住的大概是窗外的雨和桌上的灯。但我更在意另外两件事:书架上的书,点得开吗?桌上写下一句话,下次回来还在不在?
从一幅让人想待一会儿的画面,到一个交互体验过得去的可运行软件,中间隔的东西比想象中多。这次实测,就从推开这扇门开始。
项目地址
- 在线体验:进入雨夜书房
- 开源地址:GitHub · andyhuo520/rainy-study
- 官方网站:https://atria-asi.ai
- API 体验:https://api.atria-asi.ai 据说送1亿的免费token额度,这还不爽!
为什么用一间书房,测试一个专业任务模型?
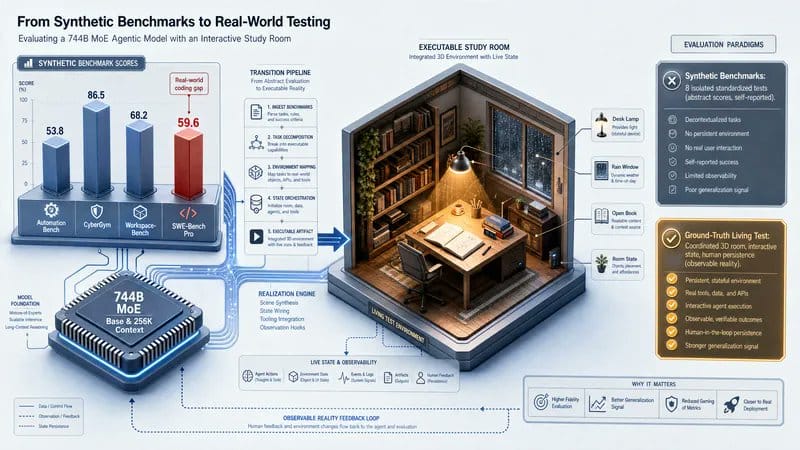
Atria Dawn Preview 的目标用户是科研工作者、开发者和专业知识工作者。
项目介绍翻来覆去就一个意思:拿到一个开放问题,把它推到能执行、能检查、能交付的地步。
背后的团队也值得看一眼:复旦、中科院软件所、哈工大等机构的研究力量,但更扎眼的是——**96 名主要成员里有 65 名在校生,占了差不多三分之二。**一支以学生为主力的队伍,做出来的 agentic 模型,到底在实际项目里能撑到什么程度?
智能体模型:围绕目标理解问题、选择行动,拿到反馈后继续推进任务。你可以想象成一位需要看现场情况随时调做法的助手。评估的时候,不光看它说了什么,更要看任务推到了哪里、结果能不能验。
这跟我平时用 AI 写代码的期待差不多:读懂需求,给出实现,碰到错误接着改。代码编译通过只说明程序跨过了一道最低门槛,用起来顺不顺手,得把每个操作老老实实走一遍才知道。
官方 GitHub 写的是,Atria Dawn Preview 基于 744B 参数 MoE 基座训练,接口上下文长度 256K。这次我通过 API 调用,电脑负责跑生成出来的网页项目,没有在本地部署模型权重。
MoE 与上下文长度:MoE 是混合专家架构,像一个分工明确的小组,每次计算不用所有人一起上。上下文长度则是模型面前的工作台能摆多少材料。744B 描述基座规模,256K 描述一次能处理的篇幅,两个数字不能直接换算成成品质量。
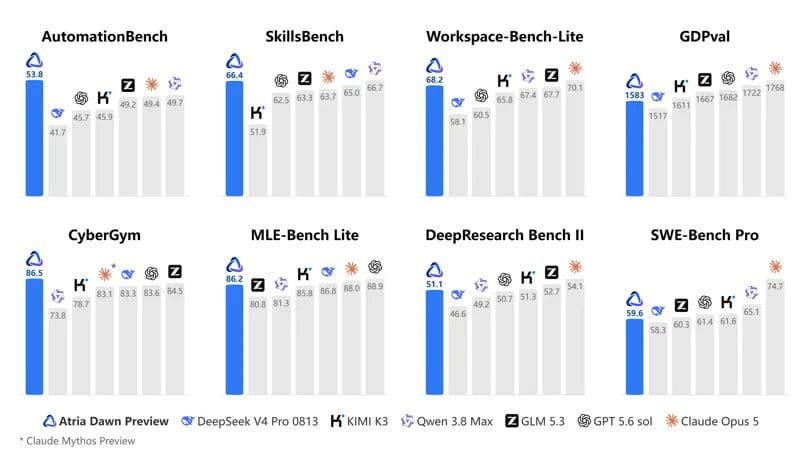
评测成绩也公开了,挑几个和这次任务沾边的,看看它在同表里排什么位置。
| 评测项目 | Atria Dawn Preview | 仓库同表位置 |
| --- | --- | --- |
| AutomationBench | **53.8** | 7 个有值模型中第 1 |
| BFCL v4 | **77.0** | 4 个有值模型中第 1 |
| Workspace-Bench-Lite | **68.2** | 7 个有值模型中第 2 |
| Terminal-Bench 2.1 | **78.3** | 6 个有值模型中第 6 |
| SWE-bench Pro | **59.6** | 7 个有值模型中第 6 |
数据摘自项目方 GitHub,查阅于 2026 年 9 月 13 日。“同表位置”按每行已公布数值排序,模型版本以原表表头为准,不代表全球排名。这些评测我没有自己复跑,README 也没在表旁列出完整运行配置。完整评测表
这张表说明的问题很直接:有几项跑在前面,有几项明显落后。一个分数漂亮不代表什么,光看一张表,我也没法判断它到底适不适合自己的活儿。
为什么选书房?交互应用和软件构建本来就在项目给出的体验方向里;书房又足够日常,书能不能读、纸能不能写、晴天切过去雨停不停,不需要学编程就能下结论。
提示词里的形容词,得在画面里找到位置
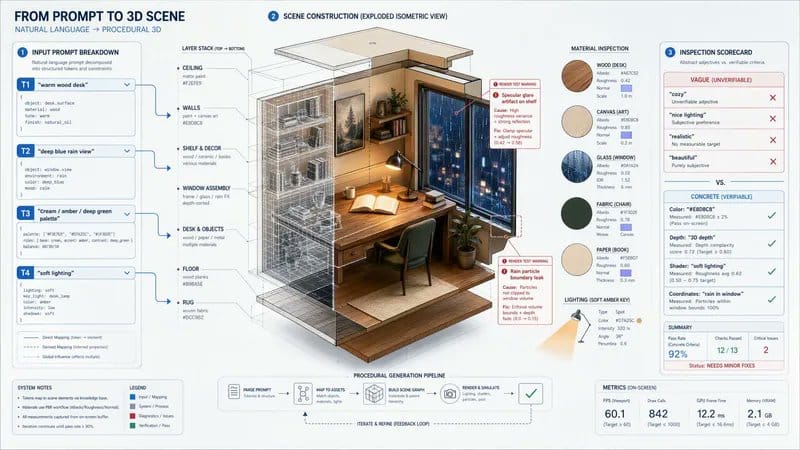
给 Atria 的初始提示词,写了这么一段:
希望效果是暖色木质室内、深蓝雨夜窗景、有空间层次的书架与书桌,克制高级的中文编辑设计 UI,主色奶油白、琥珀、深墨绿,非霓虹科技风。用程序化几何与 canvas 纹理构造书本、木纹、地毯、窗框、台灯等细节,灯光柔和、可见的三维深度、阴影、合理视角。
这是实际初始提示词,标点做了整理。初版限制外部素材和新增依赖,要求在预装的 Vite + Three.js 环境里交付可运行文件。
提示词与程序化场景:提示词是交给模型的任务描述;程序化场景由代码计算物体形状、摆放和纹理。像把装修要求交给施工方,写得越具体,越容易对照验收。Three.js 负责浏览器里的三维画面,Vite 负责项目构建。
“高级”“温馨”这种词谁都会写,但拿它当验收标准,根本没法打勾打叉。换成木桌、暖灯、深蓝窗景,换成奶油白、琥珀、深墨绿——每一条都能对着屏幕检查。
初版交上来的东西确实把这些条件组织成了一间有空间关系的房间。书架和桌面各就各位,室内暖色和窗外冷色形成对照,中文控件的配色也跟着走。
颜色、空间、氛围这三件事它都接住了,大方向没跑偏。
但同一个画面也暴露了毛糙的地方。早期夜景太暗,书架有刺眼光斑,雨点甚至飘进了室内。框架搭得住,细节还得继续磨。
这轮下来我有一个很实际的判断:**提示词里的每个重要要求,都应该能在成品里指着说“在这儿”。**写了“柔和灯光”就得查高光,写了“雨夜”就得确认雨落在窗外。提示词写成什么样,验收就按什么标准来。
这次实际工程用的是 Three.js,没有测试 Atria 操作 TouchDesigner,也没有生成 TouchDesigner 工程文件。边界说在前面,别往外延伸。
机位和天气:变化能不能连得上
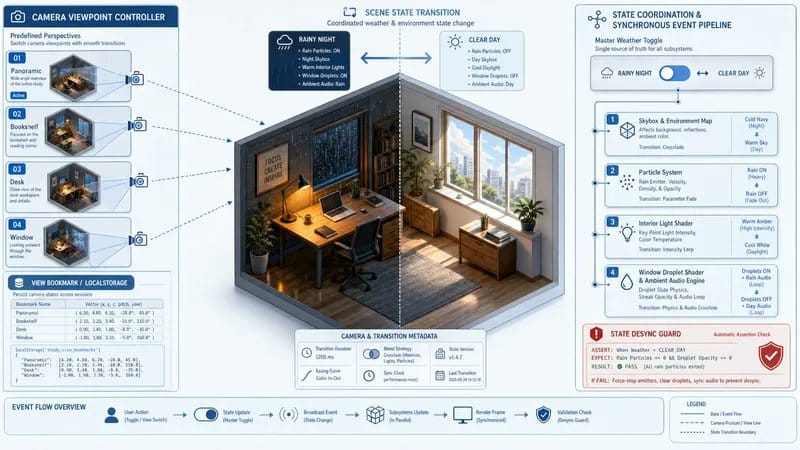
进书房以后有四个预设视角——全景、书架、书桌、窗边,也可以拖拽和滚轮缩放。
靠近书架,书脊占满视野;转向窗边,室内外明暗的落差一下就出来了。换个角度,遮挡关系和纵深感跟着变,空间立不立得住,比截一张图看得清楚得多。
我加了一个常用需求:收藏当前视角。调到满意的构图存下来,刷新后一键恢复,不用重新摆。这个功能是在 Atria 根据反馈修改的阶段加进去的,验过,确实能恢复。
天气切换把问题往深推了一步。
提示词要求“雨夜 / 晴日”切换时,窗外背景、雨粒子和室内照明同步变。晴天要更亮,雨得消失;切回雨夜,暖灯和冷色的对比得重新出现。
同一个本地项目的两种天气状态,图中是初版经反馈修改后的实际运行画面。
状态联动:一个操作发生后,所有相关部分跟着更新。像按下家里的“离家”开关,灯、空调、门锁各自进入该有的状态。书房里的天气按钮也是这个逻辑——文字标签、画面、雨的出没,要说的是同一件事。
用的人才不管你后面分了几个函数。他就看一件事:明明选了晴天,为什么还在下雨?
后来 Codex 又加了玻璃水珠和雨声。水珠沿窗户滑,声音给窗边多了一层“下雨”的感觉。
不过水珠是程序模拟,雨声也是合成的,离真实雨景的质感还有一截。
这段体验下来,边界变得很清楚。Atria 搭场景、跑状态切换没什么问题。空间遮挡、材质高光、声音质感——这些事得在实际运行里一个个对,不是跑通就算完。
一本能打开的书,一张能留下笔迹的纸
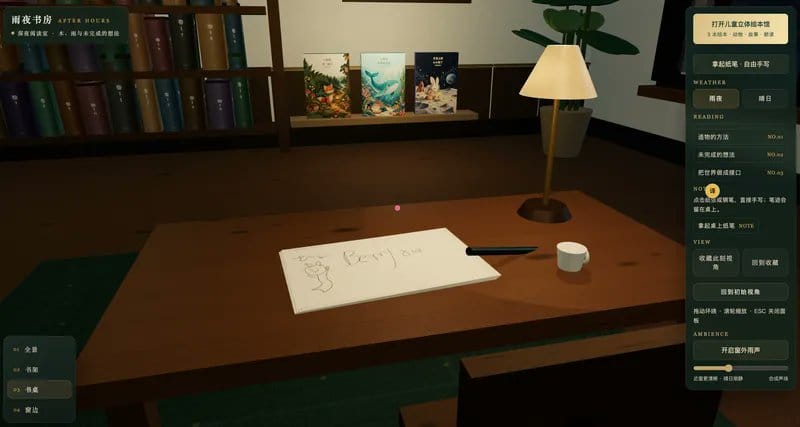
书架上摆了三本书:《造物的方法》《未完成的想法》《把世界做成接口》。提示词要求点击三维书本能打开对应中文内容,同时保留文字入口。
听起来简单。动手做了才知道,后面拖着一串细节。
点哪本就得打开哪本。阅读的时候镜头不能跟着误拖。合上面板,房间得能继续操作。手机上没键盘,也得有个能点到的关闭按钮。
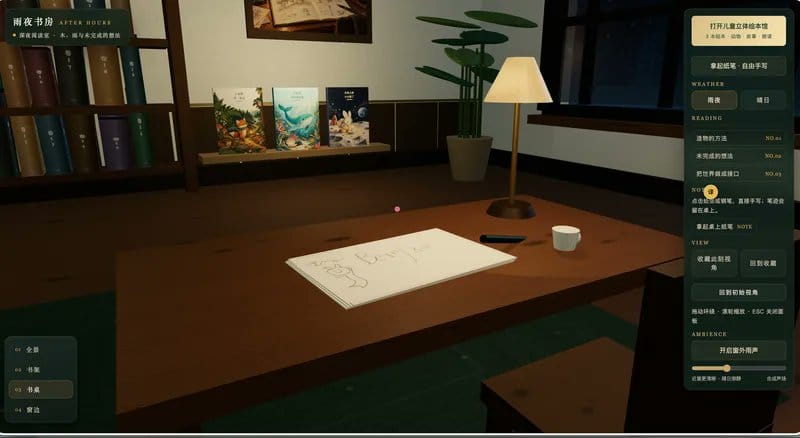
这些零碎细节加在一起,决定了一个人能不能安心读完一段话。但凡有一处脱节,用的人就得停下来猜:刚才那个操作,到底生效了没有?
Atria 初版就给了点击阅读和便签保存。测试完我又把面板互斥、背景拖拽限制、移动端关闭入口这些问题丢回去,它也确实返回了修改代码。
我对这个模型的判断慢慢具体了起来——它能把好几条自然语言要求组织成一个能点能用的原型,碰到运行反馈也能回头改。想让整条体验流畅,还得有人检查和收尾。
书房能用了以后,我想再往前走一步:让阅读动作和房间里的书真正连起来。
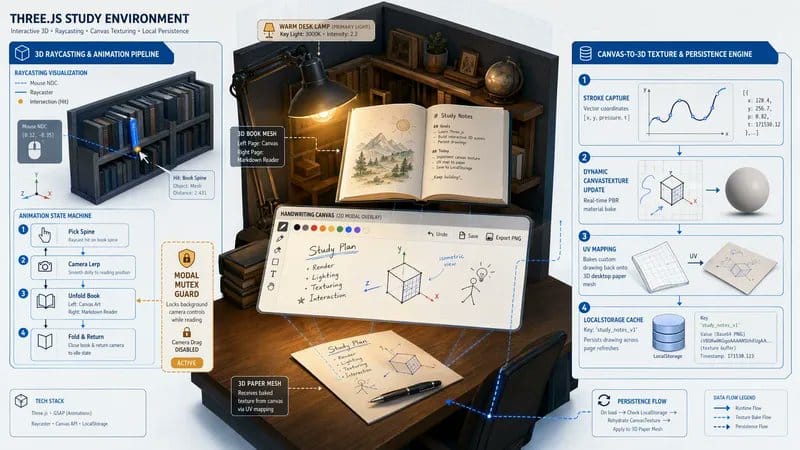
后续增强版里,点书脊,书从架上移到眼前。展开后左页插图、右页正文,能继续翻章节。读完合上,书放回去。
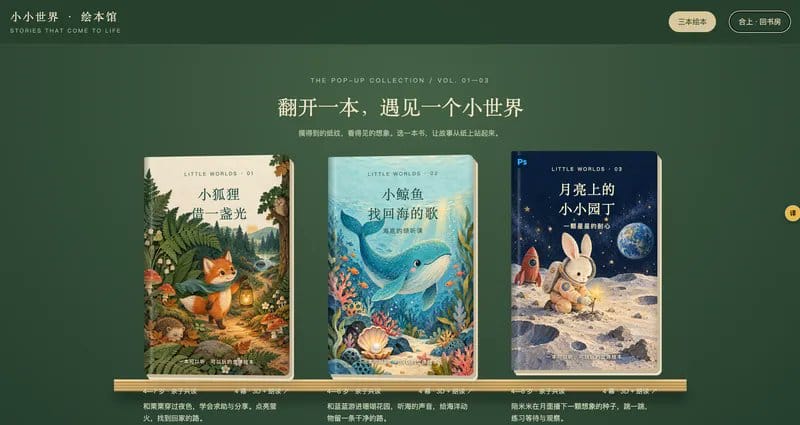
取放阅读、手写、立体绘本这些后续功能由 Codex 接着做,插图来自 Image,儿童朗读用的 Edge TTS。这部分用来展示书房项目的完整体验;Atria 的能力判断,只看它实际返回的代码和补丁。
取出、阅读、放回——动画给内容加上了位置感,关闭面板也不用猜了。
桌上的纸笔也是同一个逻辑。
初版便签能输入文字、能保存。我后来觉得,桌上都摆着笔了,干脆让人能画两笔。现在点纸张或钢笔就能打开手写页面,笔迹跟着鼠标或手指走。
颜色粗细都能调,画错了能撤销,完成后能存也能导出图片。把纸放回桌面,画过的线也出现在三维纸张上,刷新后还在。
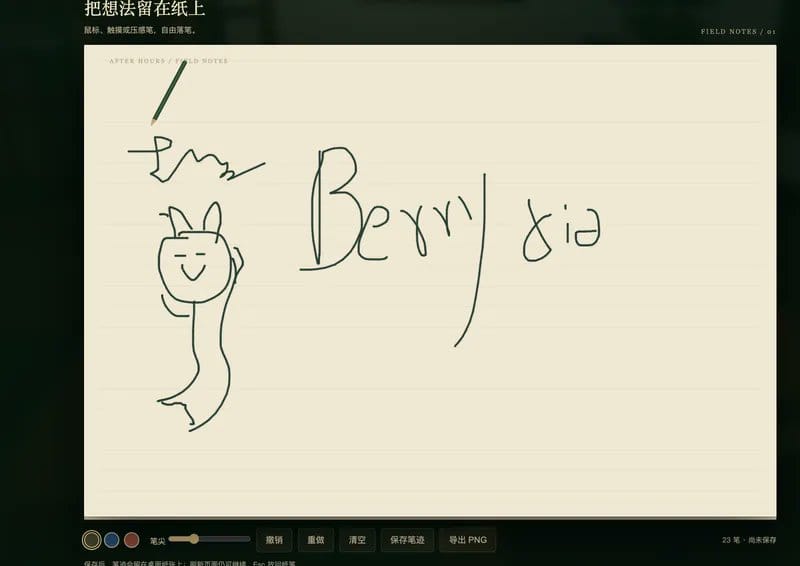
本地保存:内容留在当前浏览器里,像在书房放了个小抽屉,下次打开还能找到。便签、笔迹、收藏机位都靠这个延续,但暂时不会同步到其他设备。
这是我觉得书房开始“有点用”的时刻。逛一间房间和在里面留下自己的东西,感觉完全不同。一个人愿意第二次打开这个页面,可能就因为上面还有一笔没画完。
翻过一页,故事从纸面站起来。
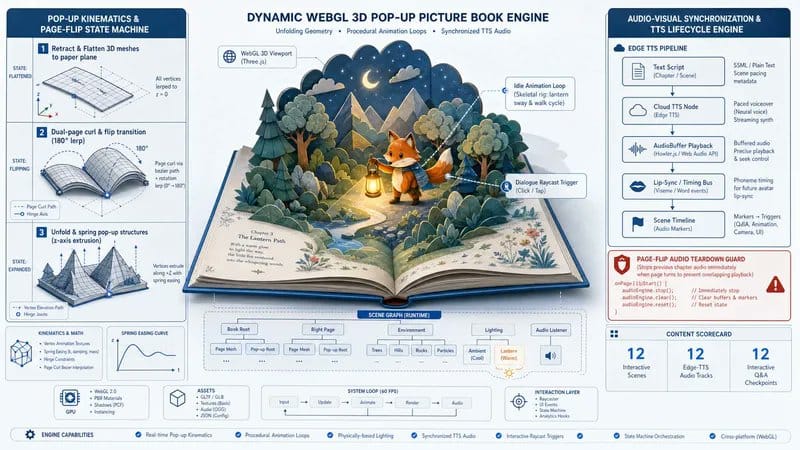
儿童绘本是后来加的一道题。小时候翻立体书,最让人期待的不是故事本身,是翻开那一下——纸页撑开,树木和小动物慢慢立起来,你忍不住想看下一页会出现什么。
书架里现在有三本小故事,每本四幕。森林、海底、月球,场景不同,运动节奏也不一样。
《小狐狸借一盏光》里,栗栗要穿过夜色给刺猬奶奶送面包。打开书,灯笼、树木、蘑菇、萤火从纸面升起来,左边的故事卡讲着它正在经历的事。
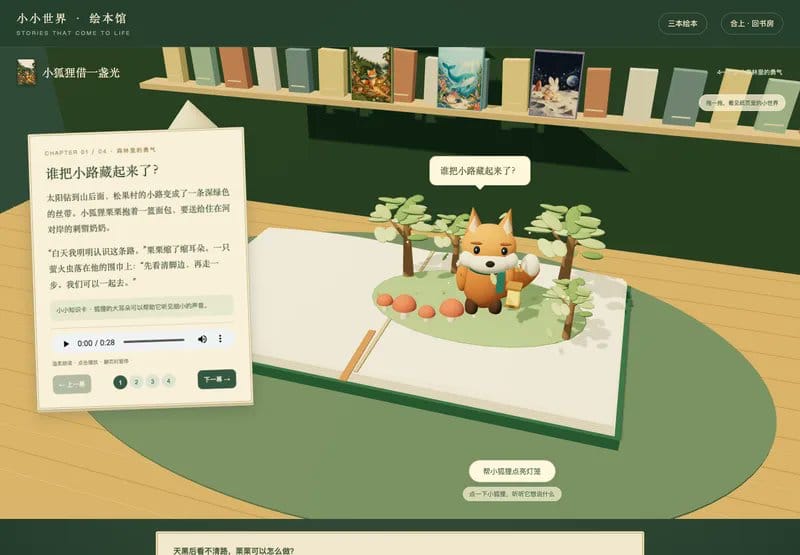
狐狸一打开就在走路,尾巴和灯笼晃着,枝叶也跟着摆。点一下角色,弹出当前章节的对白。你看到一个正在发生的场景,也能主动让角色做出回应。
翻页的时候,立体物件先收回纸面,纸翻过去,下一幕再立起来。跟小剧场换景一个道理:上一幕退场,布景换了,下一幕角色登场。知道故事在往前走,就不用猜自己看到了哪里。
这个顺序也帮提示词写得更精确。把“翻书要真实”拆成一串动作——角色什么时候收起、书页什么时候转、下一幕什么时候出现——检查起来就有了依据。
《小鲸鱼找回海的歌》节奏不一样。鲸鱼慢慢游,小鱼绕行,气泡上升,海草轻摆。到了海龟所在的水道和重逢结尾,配角和场景效果也跟着换。
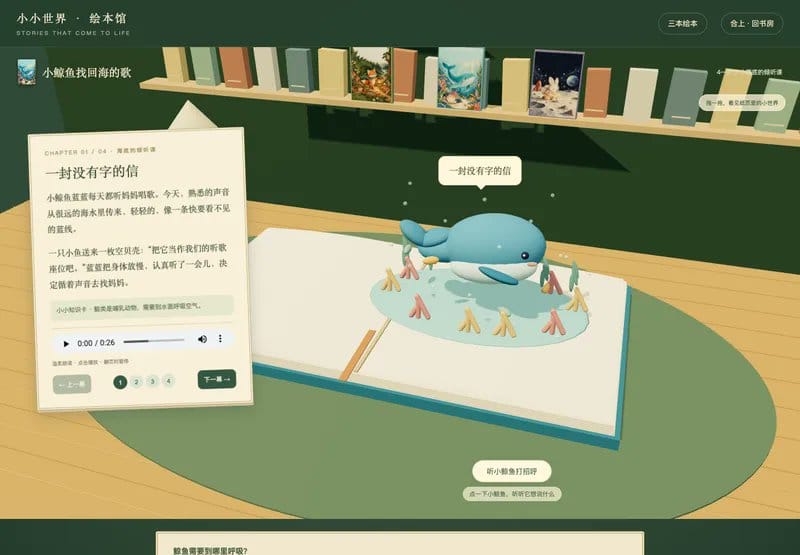
月兔的故事更轻:《月亮上的小小园丁》里,米米练跳跃、照顾一颗童话种子,火箭升空、浇水、星光花园把四幕串在一起。
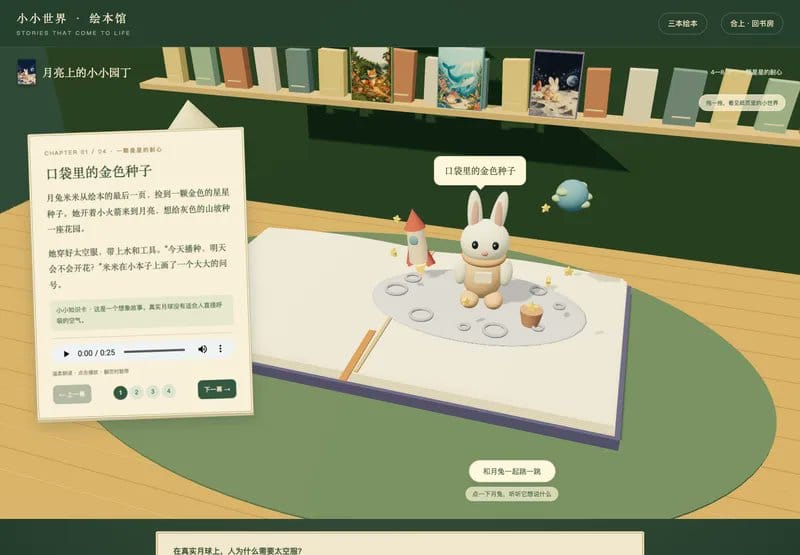
三本绘本加起来,12 幕故事、12 段中文朗读、12 个互动提问。原来三本普通书也扩成了每本三章,整个书房里有六本书可以读。
声音这块折腾了一阵。早期朗读效果不行,后来换成 Edge 云端 TTS 的晓晓声音,语速调慢了一档。翻到下一幕,上一段声音会自动停掉,画面和耳朵里的故事才能对上。
TTS:文字合成语音。像给绘本配个朗读者,声音、速度和停顿都影响阅读感受。这个项目用的是预先生成的音频,没有在阅读时实时生成新内容。
做到这里,封面、动画、角色、文字、声音算是连上了。这些环节配合得越自然,你就越不会注意到它们的存在——注意力直接放在故事上。
当前的限制说清楚:这是浏览器里的立体绘本,没用摄像头和空间定位,不算完整的 AR。动物是程序化 3D 模型,细节精度也没到参考视频的水准。
作为一个原型,它已经能让人完整走完打开、翻阅、听故事、互动回应的流程。做到哪儿了,还差什么,都清楚。
模型能力这件事,得回到使用结果上说。
这次用下来,Atria 有两个地方给我留下了比较实的印象。
第一,它能把视觉和行为要求组织成一个应用的骨架。书房空间、天气状态、镜头切换、三本书、持久化便签——这些东西在初始需求里都有对应,它确实给交出来了。
第二,它能接着具体反馈往下改。雨点位置不对、手机面板有问题、镜头收藏功能缺失——把问题丢回去,模型确实返回了代码层面的修正。
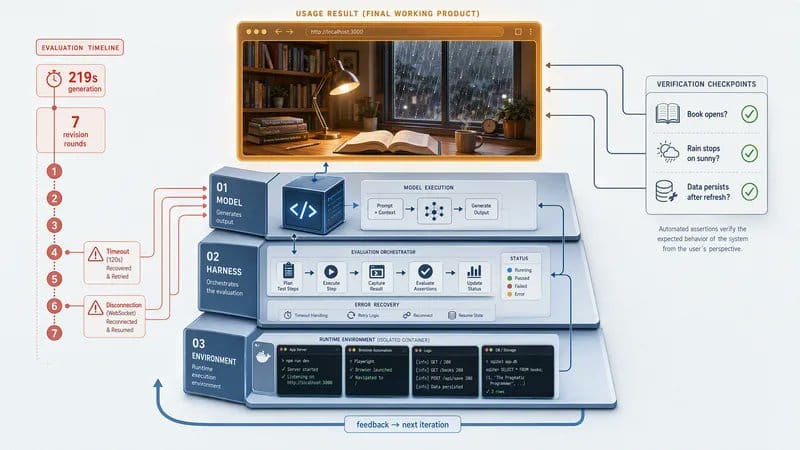
不过整个过程远没有“一次生成搞定”那么轻松。主体生成请求跑了约 219 秒,后面还有 7 轮返修,中间碰到超时、连接中断、主动中止等待等状况。219 秒只是那一次主体生成的时间,不能当整个项目的交付耗时来理解。
墙体渲染、事件选择器之类的收尾工作,最后是 Codex 直接补上的。这部分成本不能省略,不然读者看到的只有成功生成的一面。
还有一件事要分清楚。**这次的运行方式是:Codex 组织流程、检查和反馈,Atria 通过 API 返回代码。**我验证的是这套配合下的代码生成与修正能力,还没有单独验证 Atria 自己从头到尾调工具跑完全程的表现。
Harness:围绕模型运行的一套组织机制,管目标、管状态、管上下文、管出错恢复。像厨房里安排流程的人,帮厨师按顺序把菜做完。模型怎么想的、流程怎么跑的、灶台上到底发生了什么——三件事得分开看。
判断做没做完,标准其实很朴素。点书能不能打开对应内容?晴天雨停了没有?保存后刷新东西还在不在?这些事不用看模型自己说的“已完成”,打开页面一试就知道。
对我这种平时习惯拿 AI coding 做小工具和交互原型的人来说,**Atria 这次给了一个能跑、能继续改的起点。**但想把它变成一个拿得出手的成品,运行检查、审美判断、手动修正——一样都省不了。
回到开头提的那两个问题。书架上的书已经能打开,纸上写的东西也留下了。
我愿意留着这间书房,是因为它开始装得下使用者的痕迹。模型能力真正进入日常生活,往往就是这样一个不起眼的变化:一段文字有人读完了,一张纸有人写过了,下次回来,还能从上次停下的地方接着来。