本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
哥伦比亚大学 Agentic Engineering 课程
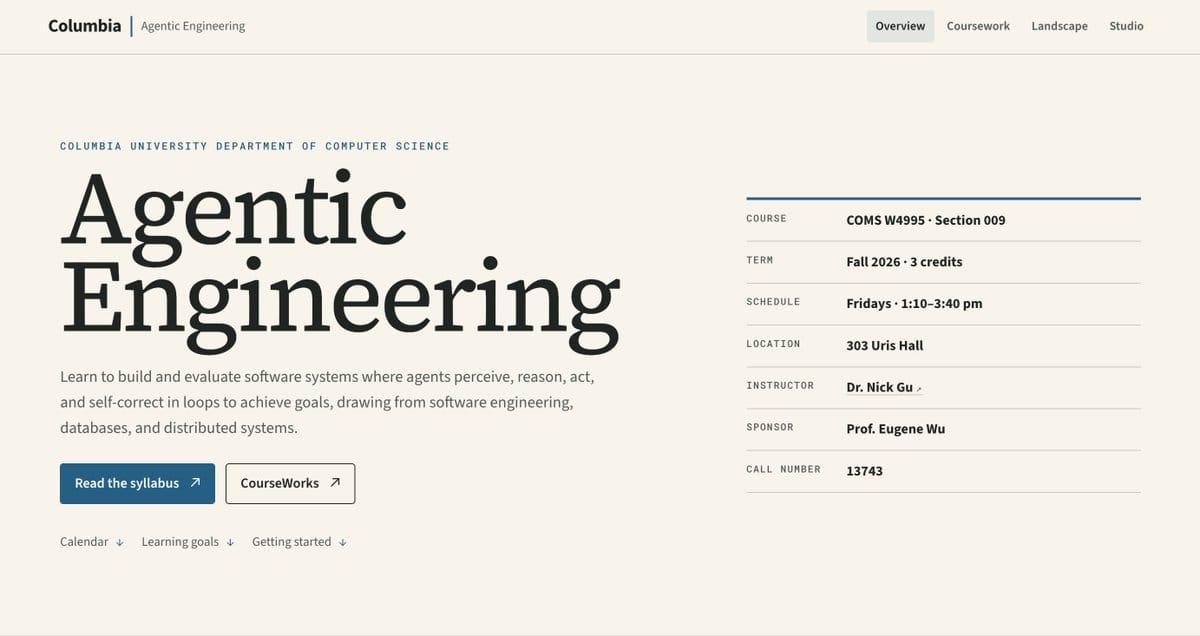
哥伦比亚大学 COMS W4995-009 · Agentic Engineering,2026 秋季学期,3 学分。授课教师为 Dr. Nick Gu,由数据库领域知名教授 Eugene Wu 担任课程 sponsor,这个组合本身就说明了课程的学术定位:从软件工程、数据库和分布式系统的视角来研究 AI Agent,而不从机器学习模型的视角。
课程的自我定义值得关注:
学习构建和评估这样一类软件系统:其中 Agent 通过感知、推理、行动、自我纠正的循环来达成目标。
关键词是“软件系统”和“循环”。这门课的立场非常明确:Agent 的本质不是模型,而是包裹模型的软件工程。模型 API 只是被调用的组件,真正决定 Agent 好坏的是执行循环、工具接入、上下文管理、权限控制和评估体系,课程把这套包裹层称为 harness,这是全课程的核心概念。
课程结构:四个模块,十三次课
课程被组织成清晰的递进结构,从概念到架构到生产化:
模块一:Foundations(基础,第 1–4 讲)
1.What Is an Agent, and What Isn't:第一讲就先划边界,不给 Agent 下营销式的定义,而是教学生区分“真正的 Agent 循环”和“被包装成 Agent 的单次调用”
2.What the Agent Can See, and What It Remembers:上下文窗口即 Agent 的“工作记忆”
3.Writing the Agent Loop:动手写循环
4.客座讲座(Yan Wang 与 Yuzheng Sun)
模块二:Architecture(架构,第 5–8 讲)
5.What Tools Does an Agent Actually Need?
6.Components of an Agent Harness
7.Designing Your Multi-Agent Harness
8.Architecture Review 或客座讲座
模块三:Design and Production(设计与生产化,第 9–11 讲)
9.How Do We Know It's Better?:评估方法
10.Going to Production
11.Running Agents in Production
模块四:Final Project(第 12–13 讲)
12.Open Studio & Adversarial Testing(对抗性测试)
13.Final Demonstrations
这个结构透露出两个鲜明的取向:其一,评估(第 9 讲)被放在生产化之前,先证明“更好”再上线,这是实验科学的纪律;其二,倒数第二讲是对抗性测试的开放式 Studio,让学生互相攻击彼此的系统,说明课程把鲁棒性当作一等公民而非附加章节。
六大学习目标:一份 Agent 工程师的能力地图
首页列出的六个目标,实际上构成了 Agent 工程师的完整技能清单,每一条都对应传统软件工程中成熟的纪律在 Agent 场景的移植:
| 目标 | 实质 |
| --- | --- |
| Harness 构建 | 管理执行循环、工具访问、系统状态,以及独立于 Agent 输出的校验检查 |
| 上下文工程 | 编写、筛选、压缩、隔离关键上下文——“管理 Agent 看到什么” |
| 子 Agent 隔离 | 创建隔离的子 Agent,规定返回格式、严格检查后才合并输出 |
| 安全的委托 | 用明确的结果检查、行动证据、检查点、纠错和升级路径来管理委托 |
| 评估 | 评估单次 episode 和整体系统,平衡能力上限与行为一致性 |
| 生产接口与治理 | 基于证据部署 CLI/API、追踪恢复、监控、运行预算;最小权限、防提示注入、明确的人类问责 |
特别值得注意的是“独立于 Agent 输出的校验”和“最小权限(least agency)”,这两条是当前 Agent 工程实践中最容易缺失、也最容易出事故的环节,课程把它们放进了教学目标的核心位置。
Studio 实践体系:课程最重的部分
这门课的分量不在讲座,而在每周 75 分钟的 Studio。它的基础设施设计本身就值得一读:
工作流设计:学生运行 bootstrap.sh,自动 fork 出一个私有仓库(agentic-engineering-private),邀请教师和 TA 为协作者。课程-owned 的文件(instruction/、docs/、评分标准等)每日通过 GitHub Action 自动同步进学生仓库,学生只能在自己的 submission/<team>/ 目录工作。仓库根目录的 AGENTS.md 同时约束人和 AI,里面明确写着“编码 Agent 的规则”:必须先读 Studio 指导书、只许写自己团队的目录、执行真实 API 调用前必须获得人类对模型供应商的明确确认。把“学生如何使用 AI”本身纳入课程契约,这是非常前沿的教学设计。
三个 Studio 构成一条精心设计的实验曲线:
Studio 01:委托与第一次可观测运行
学生填写一张“委托卡”(Delegation Card),只有四栏:任务、上下文、成功标准、限制。然后把自己定义的一个有界任务真正委托给本地 Codex 或 Claude Code 执行,检视输出和执行轨迹,再改变一个条件(缺失输入、检查失败、权限边界)观察影响。这张朴素的卡片其实是在训练人类侧的核心技能:把模糊的愿望翻译成可验收的委托。还要求每人单独手写一份不含 AI 文字的解释文件。
Studio 02:上下文压力测试与记忆架构(全课程最精彩的设计)
这个 Studio 让学生亲手测量长上下文的退化,然后亲手修复它,分三部:
•Part A(压力测试):用 BABILong qa1 基准,在 256K/512K/768K 真实输入 token 下单次调用测试。参考证据中的实测数据非常有说服力:准确率从 32K 的 85% 一路降到 768K 的 45%,而且课程诚实标注了偏差(768K 桶由 1M 桶截断而来,结构上偏容易,“它显示的下滑已经是低估”)。连教师自己跑实验时的簿记 bug 及其恢复过程(--recover 从原始事件流重解析,未重复花费)都原样保留在证据里,这种把失败和修正记录在案的做法本身就是课程要教的方法论。
•Part B(隔离与压缩):把长文档切成约 96K 的块,对比两种缓解策略。实测结果是全课程最好的一课:在 768K 桶上,“子 Agent 隔离 + 汇总”把准确率从 45% 拉回 85%,同时成本减半($7.67 → $3.86);而“每块压成 200 token 摘要”反而崩到 35%,有损压缩丢掉了针尖信息,隔离则没有。一个实验同时证明了“上下文要隔离”和“摘要是有损的”两条原理,比任何讲义都有力。
•Part C(文件记忆):跑三个独立的无状态 session,要求 Agent 维护 decisions.md。第三个 session 的回忆测试中,有记忆版三项决策全部答对,无记忆基线全部丢失。用最小实验演示“文件即跨会话记忆”。
Studio 03:Agent 循环与受控对比
学生从约百行的脚手架出发,自己实现一个最小 OpenAI Responses API 循环(含检查点、停止条件、一条升级路径、Bash 子进程执行 Tavily CLI),然后在完全相同的代码、问题、工具、预算下对比两种运行方式:直接 ReAct vs 先生成计划再交给同一个循环。固定研究问题本身也很讲究,“Codex CLI 和 OpenClaw 的 compaction 机制如何工作”,学生研究的就是他们正在经历的上下文压缩问题。报告要求用 trace 事件和 call ID 支撑结论,区分“发生了什么”和“证明谁更优”(“一对运行描述了你的运行中发生了什么;它不确立一般性的赢家”),并把不可得的指标标为 unknown 而非 0。这是把科学写作的严谨性下沉到了本科作业。
/studio 交互页面:浏览器里的 Agent 实验台
网站还有一个登录后才能用的 Studio 交互环境,内置 Ace 代码编辑器的浏览器沙箱,标注为“Lesson 03 · Interactive Walkthrough: Build your first agent loop”。它能运行代码、逐事件展示执行轨迹、显示工作区文件、统计 input/output tokens、模型调用数、compaction 调用数和估算成本。相当于课程自建了一个微型 Agent 可观测性平台,让没有本地环境的学生也能完成课堂演示。
Landscape:一份 Agent 生产栈的分类学
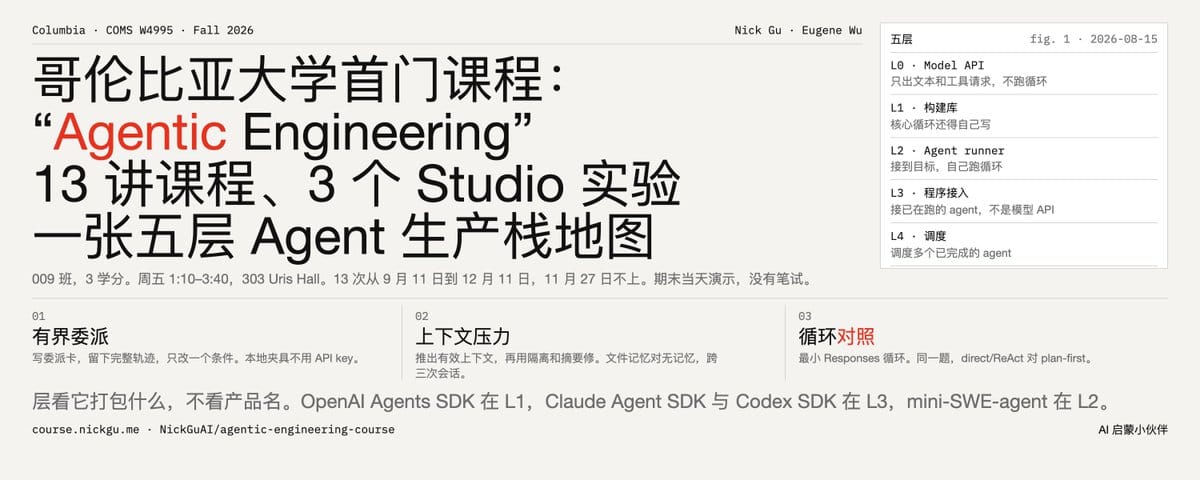
课程的 Landscape 页面(标题为 "Agent Production Stack · August 2026")可能是目前对 Agent 生态最清晰的一份分层地图,其核心方法论是两个问题:
1.这个产品包装/控制的是什么?(一个模型接口、一个完整 Agent、还是多个完整 Agent?)
2.谁在用它?(Agent 构建者、人/应用程序、还是协调 Agent 的系统?)
由此得出五层分类:
•L0 模型 API:只产生文本和工具调用请求(Responses/Messages API、tool-call 原语、结构化输出)
•L1 构建库:提供组件让你搭 Agent,但核心逻辑仍由开发者设计(Microsoft Agent Framework、OpenHands SDK)
•L2 完整 Agent Runner:接收目标、自管执行循环(mini-SWE-agent,“虽小仍是 L2,因为它自己管理循环”)
•L3 程序化接口:把已构建好的 Agent 直连给程序/编辑器(Claude Agent SDK、Codex SDK、OpenCode SDK)
•L4 协调系统:把多个运行中的 Agent 当作可互换的助手来调度(LiteLLM Agent Control Plane 等)
配套的辨析同样精彩:交互界面不等于层次(Claude Code 无论通过终端、IDE、网页还是 SDK 访问,都是 L2);七项能力(运行代码、用工具、管信息、暂停恢复、观测、测试、控权限)是贯穿所有层开发者职责,不是层;工作流插件和通用基础设施(K8s、Docker)不属于这个栈。在工具选型上,课程给出一个非常实用的立场:MCP 有其位置(跨应用的标准化工具发现),但当 Agent 能直接用命令行工具时,MCP 是个糟糕的默认选择,CLI 隐藏状态更少、结果可复现。
这个 Landscape 本质上是在教“如何看穿产品营销”:当所有产品都自称 "agent platform" 时,用“它包装的单元是什么”这个客观标准就能立刻定位。
期末项目
默认项目是 Agentic Code Reviewer:系统接收一个 GitHub PR URL,进行结构化审查、给出修复建议、校准置信度、生成审计轨迹,并按需追加 commit 完成 PR。注意这些要求(置信度校准、审计轨迹)正是课程六大目标中“评估”与“生产化”的综合应用。
替代方案是算法锦标赛:各队用 Agent 系统开发自动博弈/模拟交易算法,多赛道对抗积分(灵感来自 MIT 的 Battlecode)。这等于把“Agent 作为开发者”和“竞争性评估”合二为一。
我自己的感受
这门课有几个在同类课程中罕见的特点:
1.它是一门实验科学课,伪装成工程课。 每个 Studio 都要求留下证据(results.json、trace、图表),评分标准是“证据存在且脚本跑完”加“解释写清”,而参考证据里连教师的 bug 和数据偏差都诚实标注。它教的不是“如何使用 Agent”,而是如何知道你的 Agent 是否变好了。
2.它对行业炒作免疫。 第一讲就叫 "What Is an Agent, and What Isn't";五层分类法给了学生看穿营销话语的透镜;“MCP 不应是默认选择”、“产品名不告诉你它在哪一层”这些论断都有明确理由。
3.基础设施即教学。 私有仓库同步、AGENTS.md 同时约束人类与 AI 协作者、secret 扫描、成本预算、浏览器沙箱、结构化脱敏的 evidence 采集,这套体系本身就是一个生产级 multi-agent 工程的活教材。
4.它假设的先修背景很说明问题:Python、Git、一台笔记本,不需要 GPU,不需要机器学习背景。这印证了课程的根本判断,Agent 工程是软件工程的延伸,而不是深度学习的延伸。
一句话总结:这门课把当下喧闹的 “AI Agent” 话题还原成了一门可以严肃讲授的工程学科,模型是引擎,课程教的是造车、装仪表盘、做碰撞测试。对于想系统掌握 Agent 工程的从业者,它的三个 Studio 实验设计(长上下文退化的实测、隔离 vs 压缩的对照、文件记忆的跨会话验证)和五层生产栈分类法,即使不选课也值得完整读一遍——前者给出的是可复现的证据,后者给出的是清晰的思考框架。
附:主要材料来源——课程网站 course.nickgu.me(首页 / Coursework / Landscape / Studio 四个板块)和 GitHub 课程仓库(Studio 指导书、评分标准、参考证据等 60 个文件)。官方大纲 PDF(/syllabus-revised.pdf)和 CourseWorks 需要相应权限,未在本次解读范围内。