本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
Fireworks AI @FireworksAI_HQ 官方文档中 Training API Cookbook 系列的一篇实战教程,主题是用强化学习训练 LoRA 适配器。整篇教程回答了一个核心问题:如何用 RL(非 SFT)来微调一个开源模型,而且全程不需要本地 GPU。
它把两样东西拼接起来:
- HUD:一个用于定义 RL 任务的开源框架。你只需要写一个小的 Python 环境模块,声明“给模型什么提示、如何给回答打分”。
- Fireworks Serverless Training API:Fireworks 托管的训练基础设施。你在本地写普通的 Python 训练循环,梯度的前向/反向传播和优化器步进都在 Fireworks 的共享 GPU 池上执行,按 token 计费。
分工非常清晰:你负责任务和评分标准(HUD),训练循环由 cookbook 仓库代劳。教程的示例任务是“四位数乘法”,让 Qwen3.8-27B(基座为 qwen3p8-27b)做 a × b,每个 rollout 采样一条回答。
这个看似简单的任务其实是 RL 微文的经典“Hello World”:答案对错可以机器精确判定(reward 二值),难度可通过操作数范围调节,且基座模型本来就不太会,正是 RL 能发挥作用的区间。
二、核心概念:环境、模板、评分器
HUD 环境就是一个 Python 模块,包含一个 Environment 类和若干任务模板。每个模板的生命周期是三段式的:
- 产出提示(yield prompt):例如 multiply(a, b) 模板要求模型计算乘积,并把最终整数单独放在最后一行;
- 接收回答:模型的输出返回给模板;
- 产出评分(yield grade):交给评分器。
评分器 grade_final_integer 的逻辑值得注意:它只解析最后一个非空行,用正则匹配整数(容忍千分位逗号格式),匹配 a * b 则 reward 为 1.0,否则为 0.0。也就是说:答错、没写答案、输出被截断,统统得 0 分。这个设计把“格式合规”和“计算正确”压缩进同一个标量信号里,简单但对后文的实验结果有直接影响(见第五节)。
三、工作流程四步解读
第 1 步:安装与配置
环境要求 Git、Python 3.11/3.12、uv 包管理器和 FIREWORKS_API_KEY。克隆 hud-python 仓库后进入 cookbooks/fireworks-rl-training 目录执行 uv sync。
几个有信息量的默认值:
- 提示渲染在客户端完成(--renderer qwen3_8_disable_thinking),默认关闭 Qwen3 的思考模式再渲染提示。这决定了“什么算 prompt token、什么算生成 token”的边界由本地控制。
- tokenizer 使用 Qwen/Qwen3.8-27B。
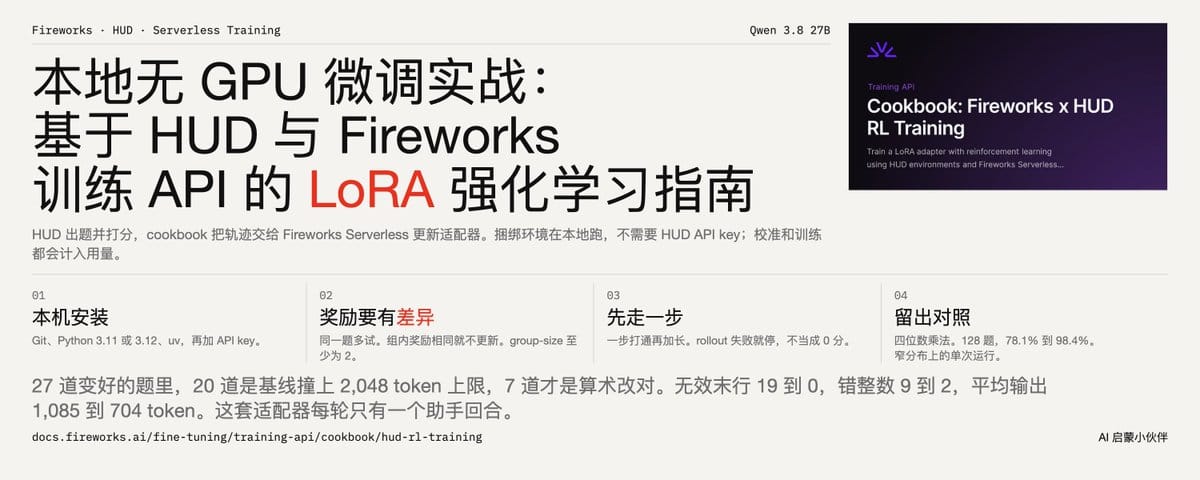
第 2 步:校准(Calibration),最容易被忽视但最重要的一步
命令形如:
--calibrate --tasks-per-step 6 --group-size 4 --max-tokens 2048 --debug-samples 4这会收集 6 × 4 = 24 次采样运行,产出两个关键指标:
- reward_mean:正确率。
- within_group_reward_std:同一任务多次尝试之间 reward 的组内标准差。
第二个指标是精髓所在。这套训练流程(GRPO 风格,见第四节)只有在同一任务的不同尝试得到不同 reward 时才会产生梯度更新,全对或全错的组没有任何学习信号。所以 --group-size 必须 ≥ 2,而校准的目的就是确认你选的任务难度落在“有时对有时错”的区间:
- 如果 reward_mean 接近 0:任务太难,用 --min-a / --max-a 等参数缩小操作数范围;
- 如果接近 1:任务太简单,扩大范围;
- 如果超时截断太多:调 --max-tokens。
文档还明确了采样温度约定:训练时 temperature 1.0(保证组内多样性,制造学习信号),评估时 temperature 0(确定性比较)。这是 RL 训练中非常标准的做法。
第 3 步:单步训练,先跑通最小闭环
--steps 1 --tasks-per-step 2 --group-size 4 --eval-tasks 4 --require_update一次运行会:执行一次优化器更新、保存 checkpoint、打印留出集(held-out)上的 reward。输出指标包括 kept_groups(保留了几个有效组)、datums(生成的训练数据条数)、updated(是否真的发生了更新),--require_update 保证了没有学习信号时不会静默通过,而是让你知道。
细节数据记录在 runs/fireworks-serverless/metrics.jsonl。还有一个值得称道的工程决策:失败的 rollout 会直接中止脚本,而不是记 0 分。这避免了把“基础设施故障”混入“模型答错”的信号,二者的 reward 同为 0,但语义完全不同。
第 4 步:长跑的默认规模
默认配置是 8 个任务对 × 30 步 × 每步每任务 8 次运行 = 1,920 次训练采样 + 16 次评估采样,token 上限 2048,每 5 步存一次 checkpoint。文档明确提醒:校准和训练都会产生真实费用,并发默认限制在 4(--max-concurrent)。
四、训练机制:这篇文档技术密度最高的部分
逐条拆解原文描述的机制:
- 快照隔离(snapshot isolation):每个任务开始前,先保存当前 adapter,然后打开一个绑定到该快照的 Fireworks 采样器。这保证 rollout 期间策略是冻结的,采样不会看到训练中途的权重,这是 on-policy RL 正确性的前提。
- Trace 的价值:FireworksAgent 采样一个 assistant 回合时,会记录提示 token、输出 token 和每个 token 的对数概率。这套 trace 被转换为训练 datum。“精确到 token ID 的 logprob”正是 serverless 架构的杀手锏,本地没有 GPU 也能拿到计算重要性比值所需的全部量。
- Loss masking:prompt token 被 mask 掉不参与损失,只对生成的 token 计算梯度。这是与 SFT 共享的标准做法。
- 组内优势归一化:advantage 在任务组内归一化,这正是 GRPO(Group Relative Policy Optimization)的核心:不用维护独立的 value/critic 网络,而是用同一任务多次采样的 reward 均值和标准差来定义基线。这也回扣了第 2 步:组内 reward 无方差 ⇒ advantage 为零 ⇒ 无更新。
- 三种损失函数(--loss-fn 可选):importance_sampling(默认):朴素的 IS 加权策略梯度; ppo:带裁剪的 PPO 目标; cispo:裁剪 IS 损失的变体(与近年来若干“无 critic、裁剪重要性权重”的 RL 算法一脉相承)。
- 调用模式:构建 datums → forward_backward(datums, "importance_sampling") → optim_step(adam)。这正是 Fireworks Training API 的原语设计,前向反向在远端 GPU 上跑内置损失,梯度的应用(optimizer step)作为独立调用,天然支持跨步梯度累积。
五、Before/After 实验结果:怎么读,以及不该怎么读
教程给了一组量化对比(512 次训练、256 次评估,使用 --eval-before):
| 指标 | 训练前 | 训练后 |
| --- | --- | --- |
| 留出集准确率 | 78.1%(100/128) | 98.4%(126/128) |
| 末行格式无效 | 19 | 0 |
| 整数算错 | 9 | 2 |
| 触发 token 上限 | 20 | 0 |
| 平均输出 token | 1,085 | 704 |
解读这个结果的关键在于归因:收益的最大来源不是“模型变聪明了”,而是“模型学会在预算内收尾了”。token 超限从 20 降到 0、平均输出从 1,085 降到 704、格式无效从 19 降到 0,这三项合起来基本解释了准确率提升的大部分。真正算错的整数只从 9 降到 2,改善相对有限。也就是说,RL 主要优化的是行为格式和自我节制(简洁作答、按时结束、把答案放在正确的位置),而不是深层算术能力。这与 RLHF/RL 微调文献中的普遍观察一致:RL 最擅长塑造“输出分布的形状”,而非注入新知识。
文档自身的措辞也很克制,明确声明这是单一一次运行、狭窄分布上的结果,不能证明泛化的收益。这种自我限定在官方教程里是加分项,读者应当照单全收。
六、Checkpoint 语义:一个实操上重要的坑
两种 checkpoint 的区分必须记住:
- 采样器 checkpoint(policy-*、final):只含 adapter 权重,用于推理或提升(promote)为正式模型。它们是会话作用域的,会话结束后就没了,必须在会话结束前 promote。
- 训练 checkpoint(state-*、final-state):权重 + 优化器状态,用于断点续训:--resume-from "<account>/<run-id>/final-state"。
另一个硬约束:换基座模型必须开新 run,无法在旧 run 上迁移。
七、扩展到其他任务
- 本地自定义任务:--tasks-file + --env-path 指向自己的 HUD 环境。
- 托管任务:设置 HUD_API_KEY 后用 --taskset 直接引用 HUD 平台上托管的任务集。
- 校准需要至少 --tasks-per-step 个任务;训练需要训练集和评估集(互不相交的子集)。
- 多轮对话 / 工具调用任务不在此篇范围内,需要自定义 adapter,文档指向了专门的 Agentic RL cookbook。
八、教程亮点
这篇教程几个突出优点:
- 渐进式验证闭环:校准 → 单步 → 长跑,每一步都有明确的退出判据(组内方差、require_update),不是“一键梭哈”式教程。
- 信号与噪声的严格分离:失败 rollout 中止而非记零分、训练/评估任务不相交、温度约定明确。
- 对成本的坦诚:明确告知会产生费用、给出并发上限、报告实验结果时刻意强调局限性。
对读者的适用性建议:如果你想在无本地 GPU 的条件下实验 GRPO 风式的 LoRA RL 训练,这篇是相当完整的入门路径;但要注意它的示例任务(单轮、二值 reward、格式化输出)恰好是 RL 微调最“好喂”的场景,迁移到模糊 reward、多轮交互或需要长链条推理的任务时,难度会显著上升,那就需要进入它指向的 Agentic RL 进阶内容了。
进一步深入可以接着读文档末尾给出的三个延伸方向:Serverless Training API 主文档(理解 forward_backward 的底层语义)、cookbook 的 GitHub 源码(训练循环实现)、以及 HUD 关于“如何设计能产生训练信号的任务”的指南。





