本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
来自 @HamelHusain 和 @sh_reya 的 AI Evals 课程「AI Evals For Engineers & PMs」,Hamel 也为这门课程编写了内容含量极高的 blog 和 faq:
工程笔记 blog
方法论 faq
核心理念:先看数据,再写评测
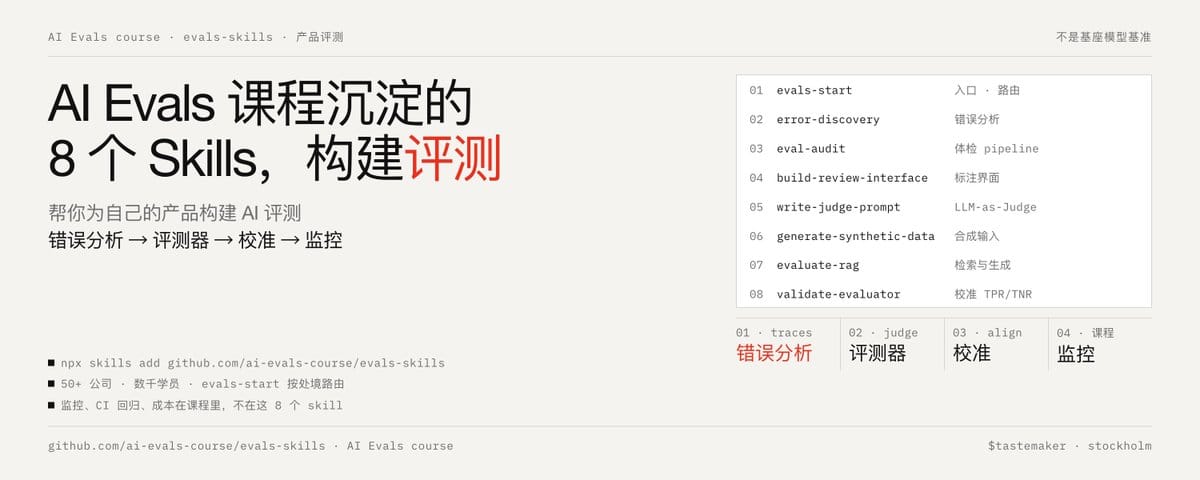
整个项目只反对一件事——没做过错误分析就开始堆指标。它的方法论链条是:定性看 trace → 发现失败模式 → 针对每个失败模式建评测器 → 用人工标注校准。8 个 skill 正好覆盖这条链路的每一步。
8 个 Skills
| Skill | 职责 |
| --- | --- |
| evals-start | 入口路由,按你的处境分发到对应 skill |
| error-discovery | 旗舰技能:交互式错误分析,发现失败模式 |
| eval-audit | 审计现有评测流水线,按影响排序出修复报告 |
| generate-synthetic-data | 没有数据时,用"维度×元组"法生成多样测试输入 |
| write-judge-prompt | 为单个主观失败模式写 LLM-as-Judge |
| validate-evaluator | 用人工标注校准 judge 的可信度 |
| evaluate-rag | RAG 的检索与生成分开评测 |
| build-review-interface | 构建本地标注界面 |
贯穿全局的方法论
- 错误分析优先:只有先定性看 trace、发现失败模式,才有资格写评测。"Metrics before reading traces" 是反模式。
- 二值评判:Pass/Fail,禁用 Likert 量表(标注者分不清 3 分和 4 分);若需细分严重度,拆成多个二值 judge。
- 一个 judge 只测一个失败模式,不做整体"好不好"评分。
- 先穷尽代码手段(正则、schema、执行测试),很多"主观"问题其实是关键词检查。
- judge 必须校准:约 100 条人工标注(50 Pass / 50 Fail),train/dev/test 划分,用 TPR/TNR(不用 accuracy),目标 >90%,测试集只跑一次。
- 偏差修正(Rogan-Gladen):θ̂ = (p_obs + TNR − 1) / (TPR + TNR − 1);报告必须带 bootstrap 95% CI。
- 锁定模型版本(带日期快照),prompt/模型变更后重新校准。
各 Skill 关键细节
error-discovery(五阶段)
- 理解领域与数据:通读 5–10 条记录,识别内容维度与变化维度
- 设计视觉编码:颜色=类别(禁用于数值)、透明度=冗余、间距=层级、等宽=代码;格式塔原则
- 构建评审界面:Python 标准库 http.server 零依赖;三视图(内容/PCA-UMAP 散点地图/进度+失败模式 treemap);行内标注+批注;仅自由文本笔记,不要表单
- 聚类选样:KMeans 6–10 簇,15–25 条样本(60–70% 簇中心代表 + 30–40% 随机),多样性优先于频率估计
- 交互评审循环(review-loop.md)
eval-audit(六检查区)
① 错误分析是否基于真实 trace(观察到的失败类别 vs 拍脑袋的研究标签)
② 评测器设计(二值?针对性?避免 ROUGE/BERTScore 当主评测)
③ judge 校准(TPR/TNR、无 few-shot 泄漏)
④ 人工评审(领域专家、看全 trace、自然格式展示)
⑤ 标注数据量(~100 条错误分析饱和;judge 校准 50+50)
⑥ 流程卫生(变更后重跑、定期重校准) 结论三态:存在问题 / OK / 无法判断;按对产品的影响排序。
generate-synthetic-data(维度元组法)
3 个维度起 → 与用户共同起草 20 个元组 → LLM 扩展元组 → 单独的 prompt 把元组转成自然语言查询(单步生成会重复)→ 质量过滤(真实感 1–5 分,<3 弃)→ 跑过流水线拿完整 trace,目标 ~100 条。 真实数据抽样用分层抽样(小数据人工分组,大数据 embedding+K-means),不要随机抽样。 反模式:无结构的"给我一些测试问题"、任意维度、没人能判断真实感的领域(法律/医疗)、低资源语言。
write-judge-prompt(四要素)
① 任务与判据(单一失败模式)
② Pass/Fail 定义(源自错误分析,含具体例子)
③ Few-shot(≥1 Pass + 1 Fail + 1 边界例;边界例最有价值;2–4 个够;只能取自 train split,防泄漏)
④ 结构化输出(critique 必须在 verdict 之前,强制先推理)。
模型选最强的起步;judge 可与主任务同模型(裁判是更窄的任务)。 规范失败先改 prompt 加指令,judge 作为回归守卫——顺序不能反。
validate-evaluator
- 数据划分:train 10–20%(few-shot)/ dev 40–45%(迭代)/ test 40–45%(最终只跑一次)
- 只看 TPR/TNR,不用 accuracy/precision/recall/Kappa(Kappa 只用于两个人类标注者间一致性)
- 90% 目标,80% 底线;卡住就换强模型、拆判据、补定向 few-shot
- Rogan-Gladen 偏差修正 + bootstrap 95% CI,拒绝点估计
- TPR 越高 CI 越窄;标注 <60 条 CI 显著变宽
evaluate-rag
- 先看 trace 定位:检索问题还是生成问题,或两者
- 检索指标:首轮检索用 Recall@k(LLM 无法凭空生成缺失内容);重排用 Precision@k;单事实查找用 MRR;NDCG 有"多个弱相关压过一个强相关"的坑,需配 Recall@k
- k 取值:事实查找 1–2,综合类 5–10;multi-hop 用两跳 Recall@k 并分类失败(hop1 miss / hop2 miss / 排名出圈)
- 合成 QA:每 chunk 提事实→写只能由该事实回答的问题;对抗性问题:用嵌入检索找干扰 chunk 借用其术语
- chunking 当超参数网格搜索(size × overlap),自然边界 + 前置文档标题/章节标题
- 生成评测:忠实性(幻觉/遗漏/曲解)与相关性分开;诊断模式:高上下文相关+低答案相关→生成器关注错段落;低忠实性→幻觉;低上下文相关→检索问题
- 反模式:单一端到端指标、ROUGE/BERTScore/余弦相似度当主评测
build-review-interface
- HTML 逐条展示 trace,Pass/Fail 按钮 + 自由笔记 + Defer,自动保存到本地(CSV/SQLite/JSON)
- 数据按原生可读格式渲染(markdown/代码高亮/pretty JSON),折叠重复内容但保持全 trace 可达
- 键盘快捷键 1=Pass 2=Fail D=Defer U=Undo;初版不加预定义失败标签(等错误分析建立类别后再加)
- 安全:消毒 LLM 输出(去原始 HTML、禁图片防跟踪像素)
- 用 Playwright 截图 + 功能测试验证





