本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
MS&E 319《Efficient Generative Language Models》
斯坦福大学 2026 年秋季开设的一门研究生课程,核心问题是:在算力预算有限的约束下,训练目标、模型架构和推理算法应该如何选择? 它不是一门"如何使用大模型"的课,是一门把"效率"当作设计科学来研究的课,研究每一项让大模型变快的算法创新"如何工作、代价是什么"。
课程基本信息
MS&E 319: Efficient Generative Language Models
https://web.stanford.edu/class/msande319/
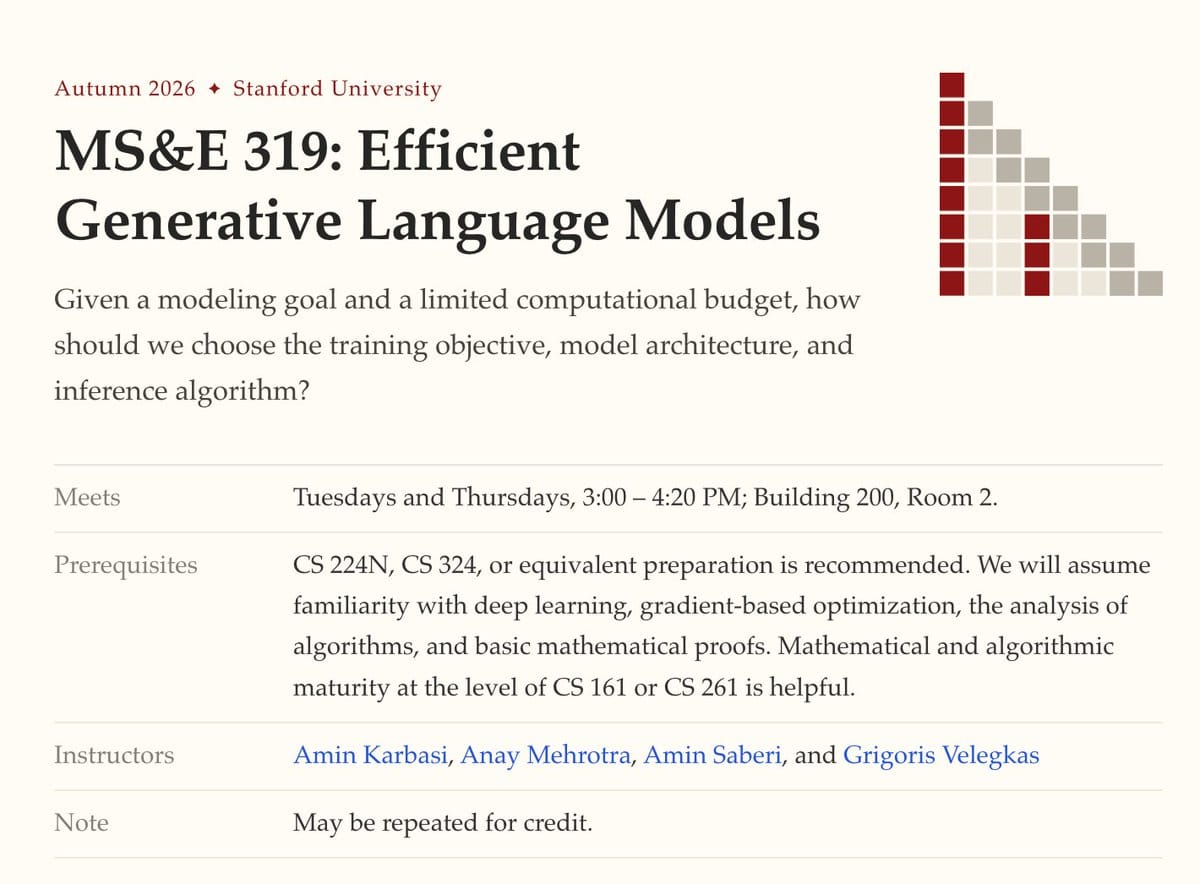
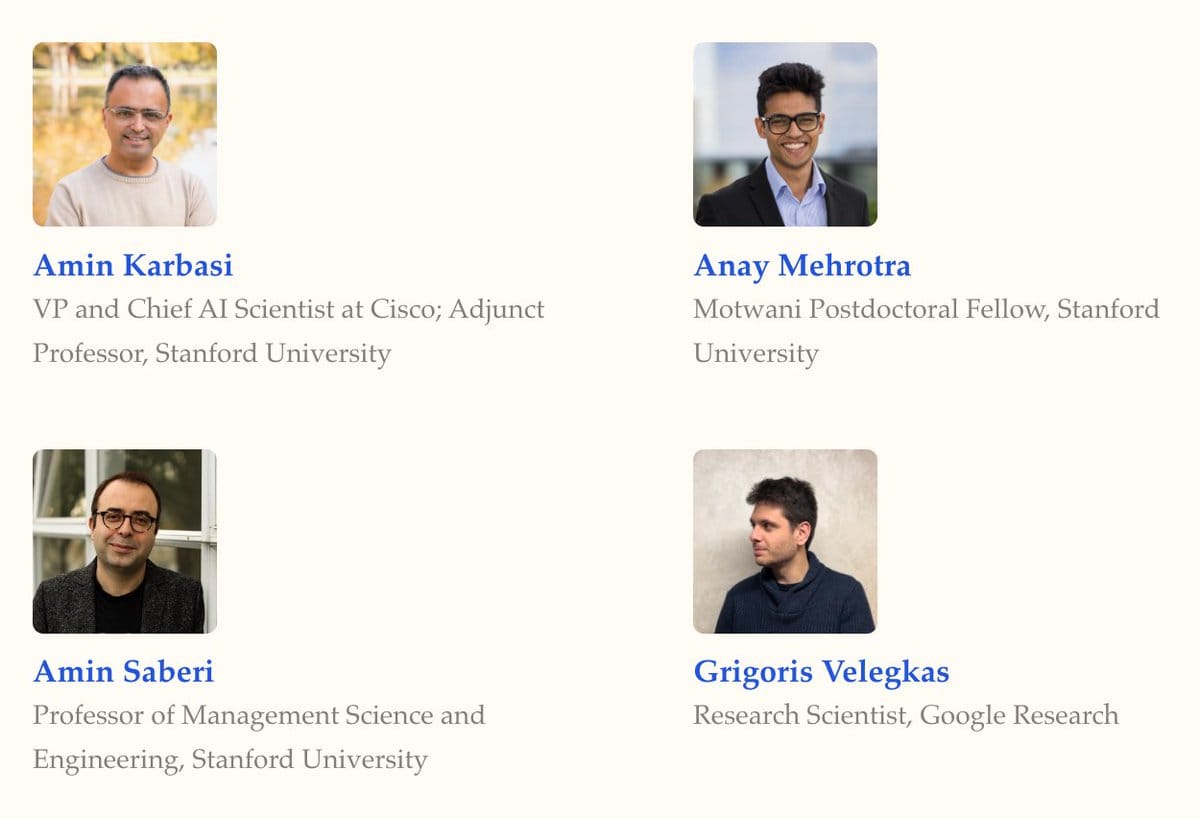
隶属于管理科学与工程系(Management Science & Engineering),2026 年秋季学期,授课教师为四位:Amin Karbasi @aminkarbasi、Anay Mehrotra @AnayMehrotra、Amin Saberi、Grigoris Velegkas @gvelegkas
先修要求建议为 CS 224N 或 CS 324 或同等准备,并明确假定学生熟悉深度学习、基于梯度的优化、算法分析和基本数学证明,达到 CS 161 或 CS 261 水平的数学与算法素养会有帮助。课程页注明"可重复修读学分",这一点很能说明问题:这门课的内容每年随领域演进而大幅更新,学校允许学生每年重修。
核心命题:把"效率"当作一门设计科学
课程概述只有两段话,但信息密度很高。第一段指出,现代语言模型的能力来自两方面:规模(scale)和精心设计(careful design),而这门课讲的是第二方面。第二段说明课程研究让生成式语言模型更高效的算法创新,混合专家(MoE)、稀疏注意力、量化、投机解码,并强调"我们将考察这些想法如何工作,以及它们的代价是什么"。
这个"如何工作、代价是什么"的框架,是理解整门课的钥匙。课程中每一项技术本质上都是一次权衡:MoE 用显存和系统复杂度换取"总参数量大但每 token 计算量小";稀疏注意力用近似性换取速度;量化用精度换取显存带宽;投机解码用草稿模型的计算换取解码延迟;蒸馏用一部分能力换取更小的模型。课程的明线是技术清单,暗线是在约束下做选择的品味,这正对应课程首页那句设问:给定一个建模目标和有限的算力预算,你该如何选?
课程结构:一条贯穿 LLM 全生命周期的主线
教学大纲共 14 讲,分为六个单元。表面看是专题罗列,实际编排有一条清晰的内在逻辑,即沿着大模型的生命周期走一遍:
单元讲次对应阶段课程概览第 1 讲—预训练的创新第 2–3 讲训练阶段模型架构的创新第 4–6 讲架构设计高效推理的创新第 7–8 讲部署/推理阶段后训练的创新第 9–11 讲对齐与适配阶段风险与漏洞第 12–13 讲安全面展望第 14 讲开放问题
第 2 讲是架构与训练的复习(训练目标、因果掩码、优化器、缩放定律),随后迅速进入前沿。这个安排暗示了课程的自我定位:它假定你已经"会训模型",要教的是"怎么训得更省"。
逐单元深度解读
预训练(第 2–3 讲)。 第 3 讲"Making Compute Go Further"有两个主题:多 token 预测(multi-token prediction)和矩阵感知优化器(以 Muon 为代表)。这两个选题非常前沿;多 token 预测来自 Meta 2024 年的工作,已被 DeepSeek-V3 用作推测解码的草稿头;Muon 则是在 nanoGPT 竞速和 Kimi 等模型训练中走红的优化器,代表了一种新趋势:连优化器本身都要为算力预算重新设计,而不再默认沿用 Adam。这个单元传递的信息是:算力的浪费不仅发生在架构里,也发生在目标和优化器里。
架构(第 4–6 讲)。 这是全课最重的部分,三讲分别对应三种截然不同的效率哲学。
- 第 4 讲混合专家:从经典 MoE、GShard 到 Switch Transformer,再到专家专业化(共享专家、细粒度专家)和负载均衡(辅助损失法与无辅助损失法)。这几乎是在逐条拆解 DeepSeek-V3 等前沿模型的实际设计。MoE 的精髓在于解耦;总参数量与单 token 计算量脱钩,从而以可控的算力获得更大的模型容量,代价是显存、通信和路由复杂性。
- 第 5 讲高效注意力:稀疏注意力(近似路线)、线性注意力(用循环状态更新改写过去的摘要,即换一种数学形式)、FlashAttention(精确但 IO 感知)。这里有个极好的教学点:FlashAttention 没有减少任何浮点运算,它赢在尊重 GPU 的显存层级结构;分块计算、不落盘注意力矩阵。它教会学生的是"硬件感知的算法设计"这一整个思想范式。
- 第 6 讲压缩 KV 缓存:从多头注意力的 KV 缓存瓶颈讲到多头潜在注意力(MLA)。在长上下文推理中,真正的瓶颈往往不是算力,是 KV 缓存的容量与带宽,这一讲正是架构设计与推理效率的交汇点。
推理(第 7–8 讲)。 第 7 讲量化:预训练模型的量化、量化模型的继续预训练、KV 缓存量化,覆盖了从 GPTQ/AWQ 式的训练后量化到量化感知继续训练的完整光谱。第 8 讲投机解码与学习式 KV 压缩:投机解码是"无损加速"的典范,小模型起草、大模型并行验证、按拒绝采样接受,从而在数学上严格保持目标模型的输出分布;研究问题在于如何把草稿做得更好(而这正好回接第 3 讲的多 token 预测),以及如何像 Cartridges 那样把上下文"蒸馏"进一小段 KV 向量。
后训练(第 9–11 讲)。 后训练流水线与监督微调、LoRA,然后是 RLHF 与 DPO,最后是蒸馏、自蒸馏与"递归自我改进"的可能性与极限。把后训练放进一门效率课,本身就是一种判断:后训练是用相对很小的算力换取巨大能力的最划算环节,而 LoRA 代表参数效率、DPO 代表去掉奖励模型的流水线简化,都属于广义的效率创新。第 11 讲涉及"递归自我改进"这样偏开放、偏研究的问题,说明课程不回避尚无定论的前沿争论。
风险与漏洞(第 12–13 讲)。 这个单元在一门效率课里出现,初看意外,细想合理。内容涵盖越狱攻击(GCG、PAIR、TAP、对抗性推理)、通过 API 窃取生产级模型的部分能力、文本水印。它与效率主题的关联在于:模型的每一次压缩、量化和缓存复用都可能改变其被攻击和被盗取的面;而"通过 API 访问窃取模型"这个选题,恰好说明当模型以服务形式交付时,API 就是攻击面。值得一提的是,PAIR/TAP 等工作出自本课程教师本人(Anay Mehrotra 是 TAP 论文的第一作者), syllabus 与讲者的研究工作高度重合,这是课程内容前沿性的直接证据。
展望(第 14 讲)。 "Where Do We Go from Here?" 以开放问题收尾,是典型的研究型课程的收束方式。
这门课为什么重要?
第一,算力是当下这个领域最硬的约束,而效率研究正是单位算力产出的主要来源。今天任何一个前沿模型的能力背后,都是 MoE、注意力优化、KV 缓存管理、低精度、投机解码、蒸馏这些技术的叠加。理解了它们,才真正理解现代大模型是如何被造出来的。
第二,它填补了教育生态中的一个真实空位。斯坦福已有的课程各有分工:CS 224N 讲应用,CS 324 讲能力与评估,CS 336 讲从零构建、偏系统工程,CS 236 讲生成模型理论。MS&E 319 提供的是第四个切面:用效率这条线索,把预训练、架构、推理、后训练贯穿起来做取舍分析。它与 CS 336 互补,后者教你搭出流水线,前者教你把每一段都做省。
第三,内容的前沿性几乎与领域同步。大纲中出现的无辅助损失负载均衡、MLA、Cartridges 等,都是刚刚出现不久的工作,而且页面明示"主题和顺序可能随课程发展而调整"。课程网页上那几幅内嵌示意图,包括块稀疏因果掩码、FlashAttention 的 SRAM 分块、分页 KV 缓存、MoE 路由、量化网格、序列 packing 等一一对应讲课主题,也能看出教学团队在表达上的用心。
结语
MS&E 319 是一门定位清晰、目标明确的课程:它不教"怎么用大模型",教"大模型为什么是现在这样造的"。它以效率为统一视角,把预训练、架构、推理、后训练四个阶段的方法论串成一条主线,用理论 rigor 处理最新的工程实践,并以一场重量级的数学考试来检验学生是否真正理解了每种技术背后的取舍。对于任何想进入高效生成式建模研究的大家来说,这门课提供的正是公开资料中最难系统获取的那部分知识,前沿技术背后的推导、代价判断和研究问题意识。
相关课程资源推荐
- CS 336: Language Modeling from Scratch
- CS 324: Large Language Models
- CS 236: Deep Generative Models
- CS 25: Transformers United
- REFORM
- CS 395T: Foundations of Modern Generative AI (UT Austin)





