本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
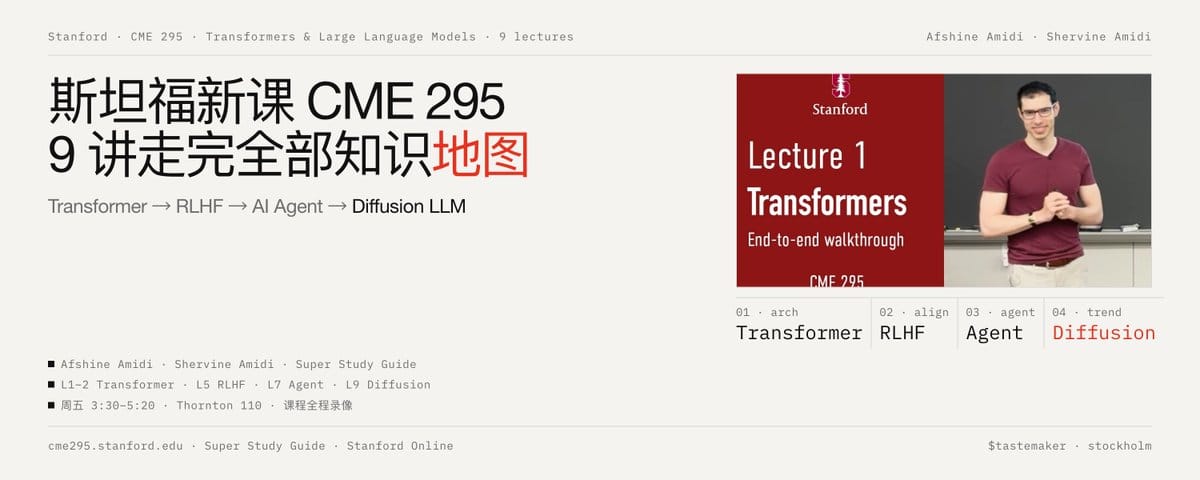
斯坦福大学 @stanfordnlp 双胞胎兄弟(Afshine & Shervine Amidi @afshinea @shervinea,CS 229/230 速查表的知名作者)开设的 LLM 全景式课程:用 9 次讲座走完从 Transformer 基础到 AI Agent、扩散语言模型、RL 训练的前沿,属于 "密集的知识地图" 课程,很适合重新梳理 LLM 全局理论基础。
课程分四个板块,层层递进
板块一:基础(第 1–2 周) 从 NLP 演进(Word2vec → RNN/LSTM → Attention)讲到完整 Transformer 架构,再进入现代 LLM 设计,MoE 混合专家、MHA/MQA/GQA 注意力变体、RoPE 位置编码、采样策略与温度。这是"从零到读懂现代模型架构"的路径。
板块二:训练(第 3–4 周) 覆盖完整的训练栈:预训练 → SFT → LoRA → RLHF/DPO 偏好调优,再到推理能力(Reasoning)。第 4 周单独用一讲讲强化学习与 LLM 的结合,PPO、GRPO、RLVR、在线策略蒸馏(OPD),这部分正是当前推理模型(如 o1/R1 类)的核心技术,紧跟前沿。
板块三:系统与工程(第 6–7 周) 期中之后的重头戏:分布式训练、KV 缓存、投机解码、Flash Attention、硬件权衡等推理优化,然后是 AI Agent,工具调用、MCP 协议、记忆与检索、编程智能体。这两讲是"把 LLM 用起来"的工程视角,与前面"训练出来"形成闭环。
板块四:评估与前沿(第 8–10 周) LLM-as-a-judge 的最佳实践与偏差陷阱、智能体评估与基准测试,最后以扩散语言模型(Diffusion LLM,一个新兴的非自回归生成方向)和多模态趋势收尾。
这门课的独特之处
1. 知识密度极高、节奏极快:平均一讲塞进一个完整子领域(如整个 RLHF/GRPO 只有一讲),适合建立全局认知,不适合追求手写实现的深度学习者。
2. 评估方式罕见:零作业、两次考试,把学习压力全部压在讲座内容本身的理解上,更像一门"概念课"而非"项目课"。
3. 前沿覆盖度好:GRPO、RLVR、MCP、投机解码、Diffusion LLM 都是近一两年才成熟的话题,更新速度快于多数大学课程。
4. 配套资源质量有保障:Amidi 兄弟以制作精良的图解速查表闻名(CS 229/230 cheatsheet 被全球广泛使用),本课的 Study Guide 和 15 语言速查表延续了这一风格,且公开可获取。
5. 自我定位清晰:FAQ 明确说了适合"已懂基础 ML、想系统理解 Transformer 原理和 LLM 最新趋势"的人,不预设深度研究背景。
速查表资源
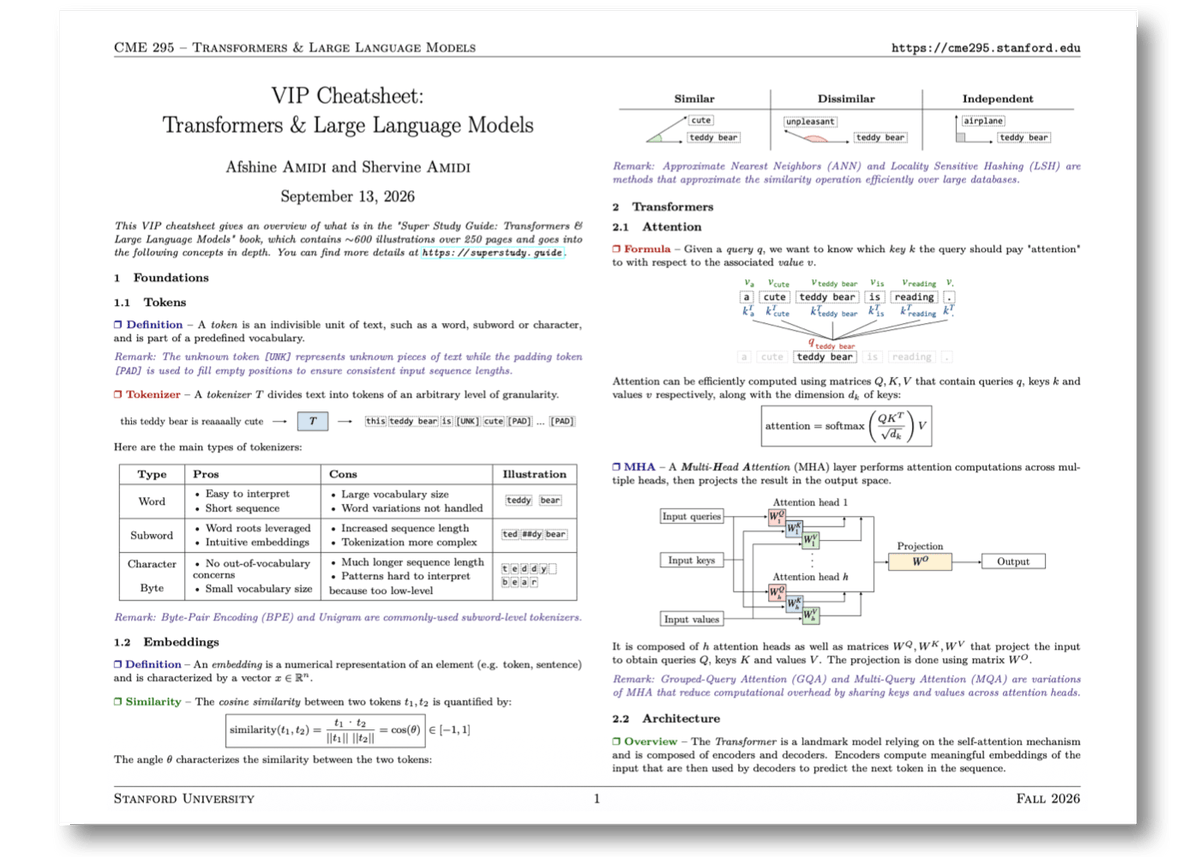
CME295 速查表
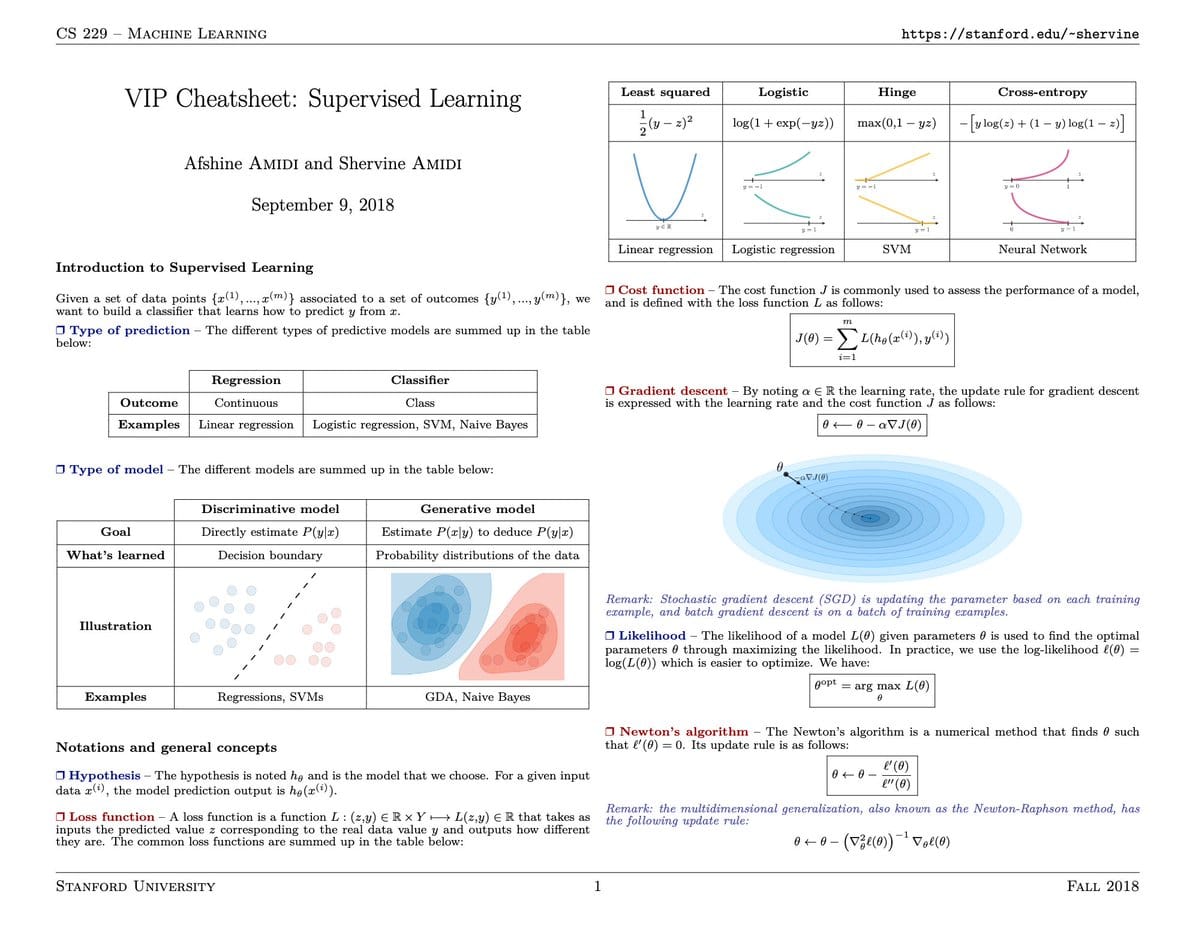
CS 229 机器学习速查表
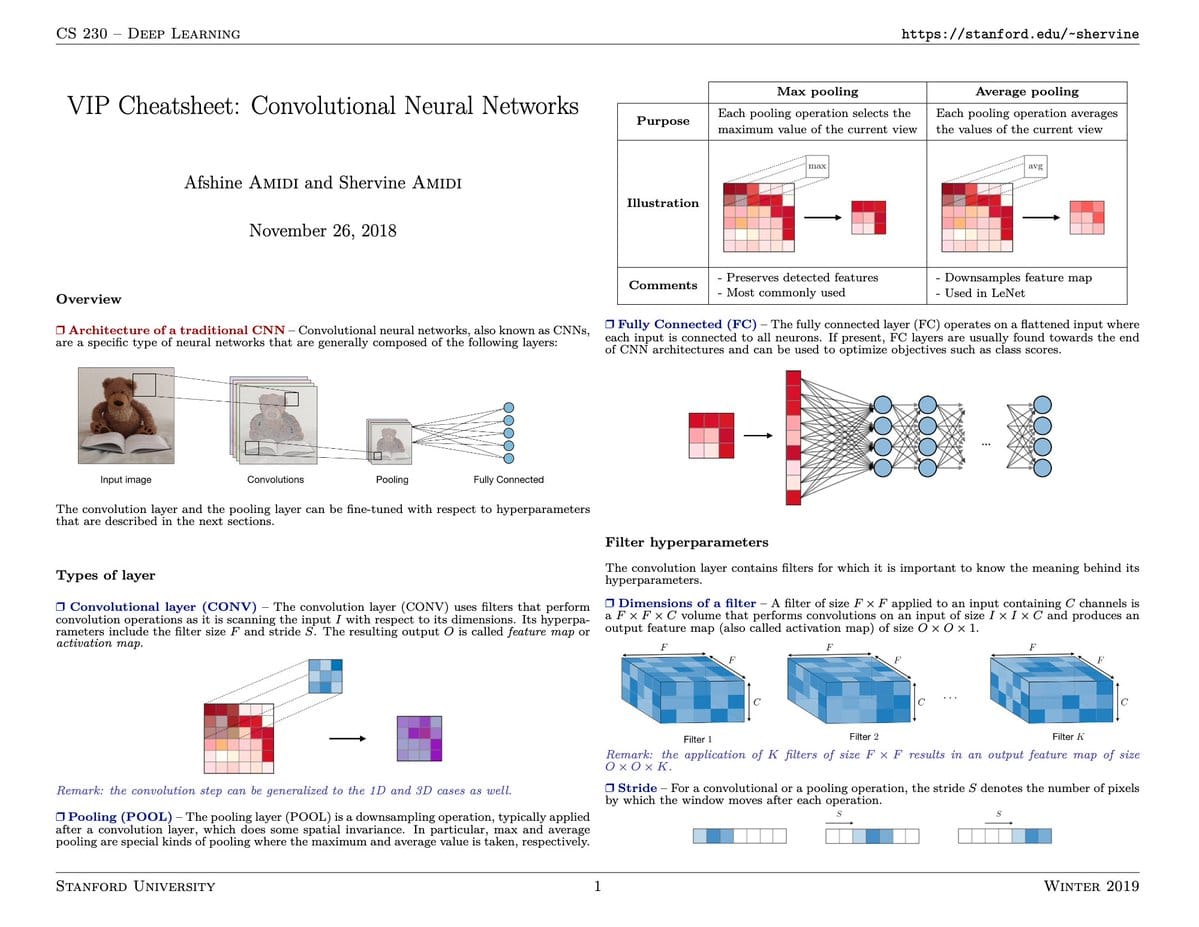
CS 230 深度学习速查表