本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
How to Build Great Evals
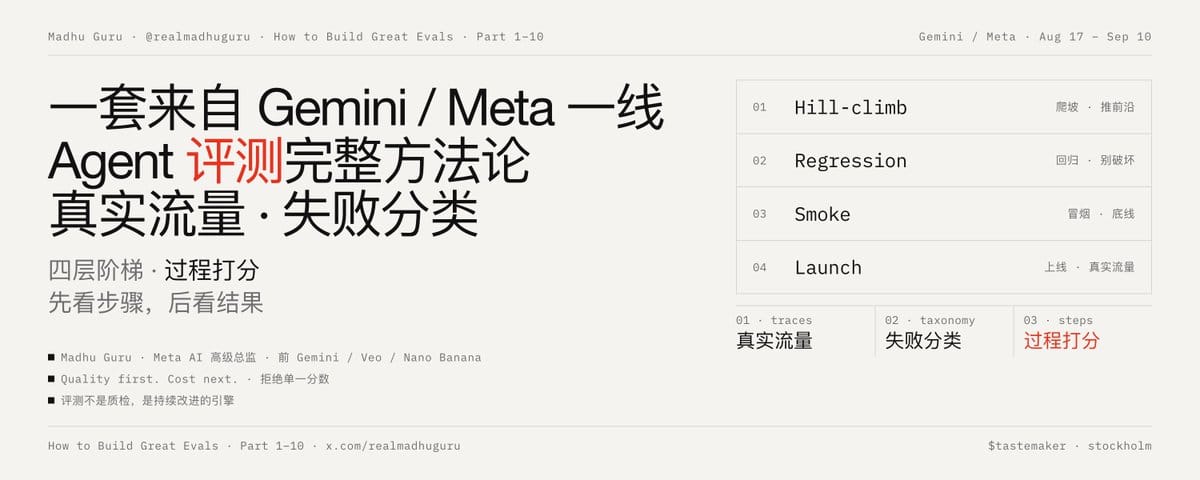
Madhu Guru @realmadhuguru 现任 Meta AI 高级总监,此前在 Google 领导 Gemini、Veo、Nano Banana 等相关工作。「How to Build Great Evals」系列共 10 篇,从 2026 年 8 月 17 日到 9 月 10 日以日更的形式发布,是一套面向 AI 产品团队的评测工程实践方法论。它的立场非常鲜明:评测不是上线前的质检环节,是驱动 AI 产品持续改进的核心引擎。
整体脉络:一条清晰的递进线索
十篇文章可以读成一个完整的操作路径——从“怎么上手”到“怎么度量”再到“怎么长期运营”:
入门与基础 (Part 1–3) → 策略与组织 (Part 4–5) → 迭代方法 (Part 6–8) → 长期演进 (Part 9–10)
Part1 - Part10
Part 1: 从你熟悉的领域上手(Aug 17)
入门方式很务实:不要从抽象的评测理论开始,而是挑一个自己深度理解的工作流,把“质量”变成可度量的东西。具体做法是研究真实用户的 prompt 序列(生产 trace),定义每一步和整体结果各自“好”是什么样;把产品出问题的地方(混乱的工具调用返回、缺失上下文等)做成测试用例;然后自动化、反复运行,并随用户行为变化持续更新。这一篇定下了全系列的基调:评测必须锚定真实流量,而不是实验室里的想象。
Part 2: 先质量,后成本(Aug 19)
借用前沿模型的思路——“先确立质量上限,再沿成本曲线往下走”。团队最容易犯的错是一开始就图便宜:用小模型当裁判、省人工标注。正确顺序是:先写清楚 rubric(评分标准),选择人类、LLM 裁判或自动验证中最可信的度量方式,前期舍得花钱拿到可信信号;等评测确实能区分好坏之后,再通过自动化、小裁判模型、采样和确定性检查来降成本。核心原则一句话:Quality first. Cost next. 一个不可信的便宜评测,价值为零。
Part 3: 失败模式分类学(Aug 20)
有了 v1 评测后,第一优先级是建立失败分类。方法:挖掘最近 500–1000 条真实交互,找出失败案例,聚类并精确命名。“回答不好”这种笼统标签没有用,要细到“检索到了错误文档”“文档对了但引用了无关段落”“没有基于上下文导致幻觉”“该拒答时硬编”“问题有歧义却不追问而做了错误假设”。不同失败对应不同修法,命名精确之后才能针对性地设计测试去捕获它——这是从评测到改进飞轮的桥梁。
Part 4: 阶梯式评测策略(Aug 21)
企业 AI 做不好,多数是缺评测策略而非缺模型。他给出四层结构,沿“成本—真实度”光谱排布:
| 层级 | 作用 |
| --- | --- |
| Hill-climb(爬坡)评测 | 推动产品能力前沿,需持续刷新 |
| Regression(回归)评测 | 确保爬坡过程中没有破坏已有功能 |
| Smoke test(冒烟)评测 | 安全与底线(如产品身份),绝对不能挂 |
| Launch(上线)评测 | 最接近真实流量的在线验证,控制力最弱但信号最真 |
Part 5: 平均数的暴政(Aug 21)
全系列传播最广的一篇(5 万+ 浏览)。核心主张:不要把复杂评测体系压缩成一个分数。他举了自己在 Gemini 时期的例子——高管要求一个简化数字,而“AI 系统的质量不存在单一维度”。典型场景:一个模型迭代后,简单摘要 85%→89%,事实问答 80%→85%,但复杂金融分析 70%→63%——取平均会完全掩盖最难、最前沿场景的退化。他连加权综合分也明确反对:权重本质是主观判断,“你只是给一个判断套上了虚假的数学外衣”。替代方案是维护一份按优先级排序的评测清单,配备愿意看细节的人,做整体判断而非数字崇拜。
Part 6: 在评测上爬坡(Aug 22)
“爬坡”说白了就是:选定一个真正重要的维度去优化。可以是提升现有功能质量、扩展相邻用例,或降低成本与延迟;手段包括 prompt/上下文工程、记忆、后训练和确定性代码。Part 3 的失败分类在这里充当罗盘——比如工具调用失败最多,分析后发现任务只需 3–5 个工具却往上下文里塞了 20 个,修法就是上下文工程。成本优化的正确姿势也在此:上线先用最好的模型把质量做上去,用户满意后再用同样的方法爬向“更小更便宜更快的模型达到同等质量”。
Part 7: 金发姑娘原则(Goldilocks Principle)(Aug 24)
评测粒度“不太粗、不太细、刚刚好”。常见错误是只建一套“标准答案”检查最终输出。以金融分析代理为例:最终产出是股票推荐,但之前有客户理解、证据收集、数据分析等中间任务,每个阶段都该有自己的评测。这样做换来的是诊断能力:客户理解 92%、证据提取 92%、数据分析 70%、推荐 75%——一眼看出该去哪里挖。粒度过细则维护成本失控,过粗则无法定位问题。Part 7 和 Part 10 是同一主题的两面。
Part 8: 评测的区分度(Aug 25)
一个好(爬坡)评测必须能把能力真正不同的系统分开。反例:五个系统得分 92–95 挤在一起,但你明确知道 A、C 远强于 D、E——这个评测没有区分度,等于给博士生做小学五年级数学,人人满分,什么也测不出来。但也别为了区分度把题出得难过头,那样人人挂科,同样偏离了系统的真实用途。甜蜜点公式:真实 + 有难度 + 对能力差异敏感。结尾留了一个真实问题:随着模型进步,好评测必然饱和,怎么办?读者给出的答案(保留饱和评测做回归、新建前沿评测、扩充度量范围)恰好呼应了 Part 9。
Part 9: 评测路线图问题(Aug 26)
多数评测失败的深层原因:团队把评测当静态工件,而用户行为在演进。金融研究代理的例子:用户最初只让它总结 5 页财报,三周后要求对比 5 份财报讲增长故事,两个月后要求从 15 份文件构建投资论点,最终期望它监控组合、论点变化时主动告警。评测必须同步迁移:短上下文→长上下文、单轮问答→多轮、段落引用→文档级引用、简单 QA→复杂综合、被动响应→主动代理。落伍的评测不会报警,但会体现在产品和流失率指标上。行动路径:预判使用演进的维度→按重要性排序→和用户交流、挖生产 trace→为下一阶段用量建 P0 评测→跑评测、找失败模式、爬坡。
Part 10: 度量步骤,而非只看结果(Sep 10)
压轴篇回到一个教育隐喻:高中数学给步骤分,不只看最终答案。两条轨迹都算出 42,一条检索了正确的源、4 次干净的工具调用;另一条 17 次调用、同一搜索重复三次、靠两次纠错才爬回来——高下立判。落地四步:定义完整工作流→定义每步任务→决定每步怎么测(独立评测或大切片的切片)→在评测中体现中等难度和高难度任务。结论:审查评测结果时,先看步骤,后看结果。
值得注意,评论区出现了对全系列最有力的质疑(@Offscript):给步骤打分可能奖励“你想象中的那条轨迹”,而惩罚找到了更短正确路径的模型。这和 Part 7 的粒度问题一样,本质是“过程评测”与“结果评测”的权衡。
整体评价:这套方法论的骨架与取舍
贯穿全系的几条主线:
- 真实流量是一切的源头。 Part 1 从真实 trace 起步,Part 3 挖生产交互建失败分类,Part 9 用生产数据侦测用量漂移——评测的有效性始终锚定在“是否反映真实世界”,而非覆盖率或题量。
- 评测的目的是诊断,不是打分。 这是 Part 3(精确命名失败)、Part 5(拒绝单一分数)、Part 7(分阶段评分)共同指向的立场:评测的价值在于告诉你“去哪里修”,而不是给你一个可以汇报的数字。作者对管理层的“简化冲动”有明显的、来自一线经验的警惕。
- 评测体系要像产品一样运营。 四层阶梯(Part 4)是结构上的运营,爬坡方法(Part 6)是迭代上的运营,路线图(Part 9)和区分度/饱和问题(Part 8)是生命周期上的运营。评测不是一次性交付物,而是有演进节奏的活系统。
- 成本观克制而清晰。 “先贵后便宜”(Part 2)与“先好模型后小模型”(Part 6)逻辑一致:先用最可信的方式建立真信号,信号可信之后,降本的每一步都有据可依。
这套方法也有局限:
- 这是经验法则的沉淀,不是可复现的实证方法。没有讨论标注一致性、评测方差、统计显著性等测量学基础问题(仅有一条回复提到评分者间一致性),对 LLM 裁判自身的偏差与漂移也几乎未涉及。
- 过程评测(Part 7/10)与结果评测之间的张力没有被正面处理。 Part 10 评论区那条“惩罚更短正确路径”的质疑是真实风险,作者在正文中没有给出缓解方案。
- 大量例子(金融)是构造性的,我们需要判断在自己领域里“500–1000 条 trace”这样的处方是否适用。
- 全系列隐含一个前提:你有生产流量可挖。对冷启动的 0→1 产品,Part 1 的“从熟悉工作流入手”是唯一给出的路径,着墨不多。
一句话总结:这是一套从 Google/Meta 一线沉淀下来的、以“诊断驱动的持续改进”为核心的评测工程观——先建立可信的质量信号,精确命名失败,分层组织评测,拒绝单一分数,度量过程而非只看结果,并让评测体系随用户行为的演进而同步进化。对于正在搭建 AI 产品评测体系的团队,它是一份诚实的经验路线图;但要把它落成严谨的工程实践,测量统计、裁判校准和过程/结果权衡这三块,需要读者自己补课。





