本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
CMU 11-768: AI Agents
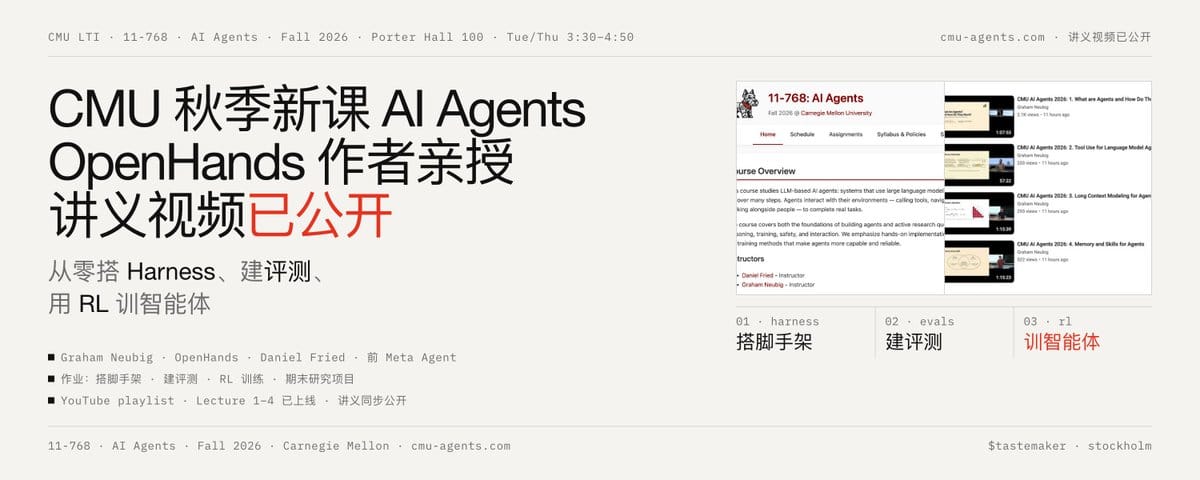
CMU 语言技术研究所(LTI)2026 年秋季新开的研究生课程,由 Graham Neubig @gneubig 和 Daniel Fried @dan_fried 两位教授共同讲授。课程定义为:研究 LLM-based AI agents,让 LLM 在多步交互中感知、推理、规划并作用于环境的系统。智能体通过调用工具、操作界面、编写代码、与人协作来完成真实任务。
它的定位很明确:不是一门"介绍 Agent 概念"的科普课,是强调动手建造 + 训练 + 研究导向的系统课程。
课程地址:https://www.cmu-agents.com/
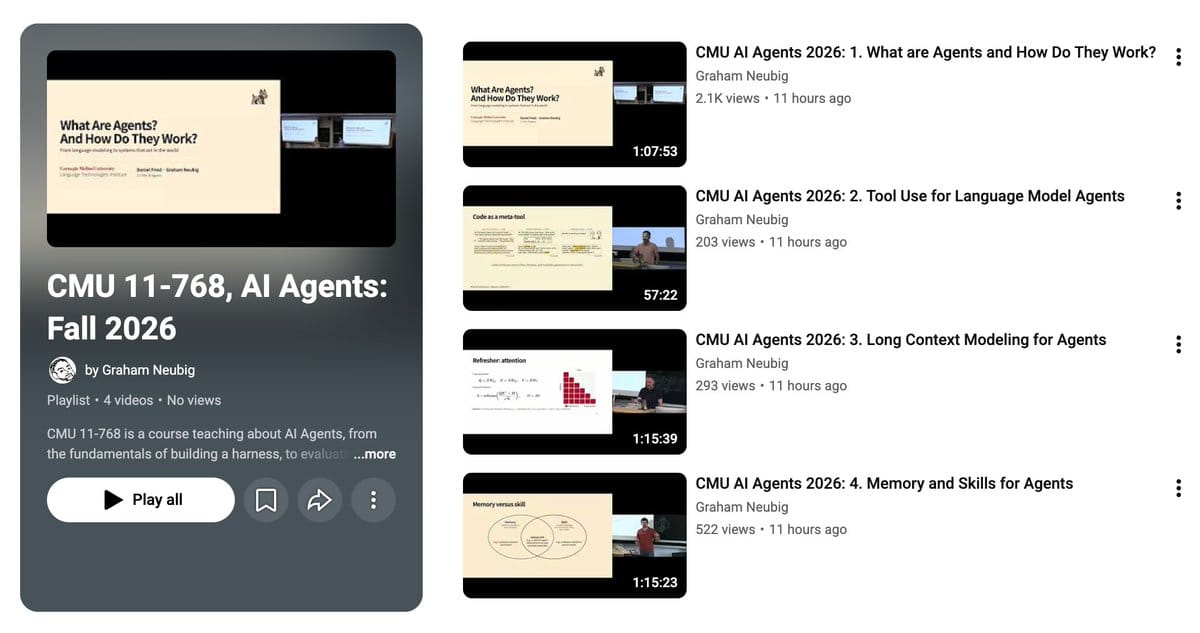
Youtube 视频也开始更新了
两位主讲人的背景本身也很符合课程的方向:
- Graham Neubig:CMU 教授,开源 Agent 框架 OpenHands(前 OpenDevin)的核心开发者。这门课的工程审美——"从零写 harness 而不是调 API"——直接来自他的框架开发经验。
- Daniel Fried:CMU 教授,曾在 Meta 的 agent 团队任职,研究方向涵盖代码生成、语言 grounding 与人机交互。
一句话概括课程目标:学生学完能在一个开源 LLM 之上从零实现一个 Agent,为多步任务设计评测,用 SFT 和 RL 把它训强,并独立推进一个开放研究问题。
课程设计哲学:一条完整的"造 Agent"流水线
这门课最值得注意的地方是它的结构设计。整个学期是一条隐喻的流水线:搭骨架(harness)→ 建标尺(eval)→ 训模型(training)→ 做研究(project)。前半学期个人作业打通前三步,后半学期团队研究项目推向开放问题。作业一(Harness,9/14 截止)→ 作业二(Eval,9/24)→ 作业三(Training,10/22)的时间线与讲课题目严格咬合:作业一只在 RL 讲完之前,作业三恰好在 RL Systems 课之后截止。
这个设计呼应了当前 Agent 研究界的共识:Agent 能力 = 模型能力 × 环境接口(harness)× 评测信号(eval),而 RL 是把三者闭环的引擎。课程没有把"prompt 工程"当作重点,而是把 Agent 当作一个可训练、可评测的完整系统来教——这在同类课程中相当少见。
教学日程:六个模块的递进逻辑
课程从 8 月 25 日到 12 月 3 日,周二/周四上课,共约 28 次课。模块编排如下:
1. Agent 能力(第 1–5 讲,8 月底–9 月初)——先把一个 Agent 的"器官"逐个拆开讲:
- 什么是 Agent(首讲,阅读材料是 Toolformer、ReAct、Mini-SWE-Agent)
- 工具调用(阅读 What Are Tools Anyway?、CodeAct;参考 Berkeley Function-Calling Leaderboard——注意课程把"约束解码"级别的工程细节如 XGrammar 也纳入了)
- 长上下文管理(43 篇参考文献,覆盖 Needle in a Haystack、Longformer、线性注意力等——为后面的 context compaction 作业铺路)
- 技能与记忆(MemGPT、Agent Workflow Memory、ReasoningBank、SkillsBench,还有 OpenHands 官方的技能工程博客——直接衔接作业一里的 Agent Skills 协议)
- 规划、任务分解与多智能体协同(Least-to-Most、Decomposed Prompting、Code as Policies、SayCan、Plan-and-Act 等,也纳入了 Cursor 的 Plan Mode 这样的工业实践)
2. 应用领域(第 6、7、9 讲):Coding Agent(SWE-Bench 一脉)、GUI Agent(由 Koh Guanlin/JY Koh 主讲,他是 GUI Agent 综述与 OSWorld 系列工作的作者)、深度研究 Agent(由 Akari Asai 主讲,她是 WebWalker、长上下文 RAG 方向的重要研究者)。
3. 训练方法(第 8、10–12 讲):SFT(TA Yueqi Song 主讲)→ RL 基础 → 高级 RL 算法 → RL Systems(Apurva Gandhi 主讲,讲训练系统工程)。把"RL 系统"单独设一讲、并由有 vLLM/SGLang 类系统经验的 TA 讲,说明课程对"训练 Agent 是一项系统工程"有清醒认识——rollout 沙箱、异步执行、吞吐这些才是 RL for agents 的真实瓶颈。
4. 安全(第 13、16 讲):沙箱与凭证管理、可观测性与监控(Eric Wallace 主讲)。注意"沙箱"放在安全模块讲,而作业里学生已经真实使用 Modal 远程沙箱执行模型生成的代码——安全课是有实物支撑的。
5. 框架(第 14、15 讲):分别由 OpenHands 和 LangGraph 团队方向的人讲两大框架,属于"业界实践"环节。
6. 交互、搜索与进阶(第 17–24 讲,11 月):Agent 与工作的未来(Zora Wang,她做过大规模劳动力市场与 AI 曝露度研究)、多智能体交互、人机交互(Valerie Chen)、搜索与推理两讲(reranking/critic 模型、树搜索,后者由 JY Koh 再讲)。压轴是两场客座演讲:普林斯顿的 Karthik Narasimhan(LLM+规划/树搜索方向的奠基者之一)和康奈尔的 Sasha Rush。11 月上旬还专门安排两次"Project hours",把课堂时间还给学生的研究项目。
值得注意的是,大量讲座由客座学者和 TA 主讲,每位都对应其研究专长——这门课实际上是 CMU LTI 及合作者 Agent 研究力量的一次整体亮相。
作业体系:Assignment 1 的细节最能说明课程的水准
作业一"Build an Agent Harness"的完整题目已经公开在 GitHub(cmu-agents/assignment-1),它足以说明这门课的工程深度:
学生要在一个开源 LLM(默认 deepseek-v4-flash,另测 gpt-oss)之上,用 ReAct 框架实现一个可复用的 Agent 循环,分三部分:
- Part 1(Coding Agent):实现消息构造、ReAct 主循环、工具调用分发、以及符合 Agent Skills 协议(agentskills.io)的技能系统(渐进式披露:系统提示只放技能目录,完整内容按需加载)。最终 Agent 要在 SWE-Bench 式的任务里修好一个有 bug 的国际象棋应用,产出 fix.patch。模型生成的代码全部在 Modal 云端沙箱里执行,学生自己处理"模型写的代码不能在本机跑"这一真实约束。
- Part 2(上下文压缩):实现模型自动生成"工作记忆"的 context compaction——保留任务目标、已试路径、失败教训,压掉旧的中间步骤——并在一个真实 SWE-Bench 任务(django__django-15368)上对比开启/关闭压缩的 token 消耗,写权衡分析报告。
- Part 3(象棋 Agent):复用同一个循环写一个下棋 Agent,包含:UCI 走子工具、无状态的局面模拟工具、以及程序化工具调用(让模型写 Python 代码在沙箱里批量调用模拟工具做搜索,最后只提交一步真实走子)——这正是当前"agentic search"的前沿做法。此外还要求做一个 2×2 的观察消融实验(两个模型 × 是否提供合法走法列表),按证据而非输赢评分。
评分细则精确到"并行工具调用至多执行一步真实走子、其余必须可恢复地拒绝""所有工具错误必须是可恢复的观察而非异常"这类生产级 Agent 工程的细节。可以说,做完作业一,学生对 SWE-agent / OpenHands 这类系统的内部机制就不是"听说过"而是"手写过"了。
后续两份作业同样指向核心能力:作业二(Eval)设计衡量 Agent 正确性与功能的评测框架——评测恰是目前 Agent 研究最缺方法论的一环;作业三(Training)实现训练流程,把 SFT/RL 课的内容落地。
期末研究项目占 50% 成绩(提案 5% + 中期检查 5% + 海报展示 10% + 报告 30%),2–3 人一组,从 11 月起课堂时间大量让位给项目。课程政策里明确鼓励把项目做成论文,甚至写了"如果 TA 和教授的建议实质性改进了你的项目,考虑邀请他们署名"——研究导向非常诚实。
评分与政策:几个值得注意的设计
- 个人作业占 40%,研究项目占 50%,另有 10% 的"课程亮点"(lecture highlights):每次课后 24 小时内在 Canvas 提交一条"有思考的收获或问题",22 次机会取 20 次计算——用轻量机制保证持续听课,而非期末突击。
- AI 工具政策颇为前沿:允许在作业和项目报告里使用 AI 工具,但禁止用于 lecture highlights,且课程会通过口试式 quiz 检验学生能否解释自己提交的每一处设计决策——"AI 可以帮你写,但你必须能答辩"。这在 2026 年的课程设计里是一个相当成熟的平衡方案。
- 代码复用规则明确:题目要求自己实现的方法,不允许拿别人的现成实现替代;每份作业有 2 天免申请的宽限日(slack days)。
生态与开放性
课程已获得四家算力赞助:Fireworks、Modal、Prime Intellect、Sail——学生在作业中使用 Modal 沙箱和赞助的推理额度,这解释了为什么"个体研究生也能真做 Agent RL"。
更重要的是开放性:PPT 和视频全部公开(课程 YouTube 播放列表已开始更新,Neubig 在推文中专门强调"感兴趣的人可以跟读"),作业一仓库也是公开的。对校外自学者而言,理论上可以完整跟下这条流水线。
总体评价
客观地说,这门课在三个层面上有标杆意义:
- 教学结构上,它把当前 Agent 领域分散的知识(工具调用、上下文工程、技能与记忆、RL 训练、沙箱安全、评测)第一次组织成了一条因果连贯的课程叙事——从 harness 到 eval 到 RL,正是"如何造出一个更强 Agent"的真实路径,而非论文列表的堆砌。
- 工程深度上,作业的约束设计(远程沙箱、可恢复错误、渐进披露、程序化工具调用、消融实验)直接对标 OpenHands、SWE-agent 等一线开源系统的实践,超出了多数"做 demo"级别的课程作业。
- 研究生态上,密集的客座讲师阵容(Narasimhan、Sasha Rush、Akari Asai、Eric Wallace、JY Koh 等)加上占一半成绩的研究项目,使它实质上成为 CMU 的一场 Agent 研究人才的集体孵化。
如果说它有门槛,那就是先修要求不低(需要真正训过语言模型),且 RL 训练部分依赖赞助算力,自学者在作业三和项目环节难以完全复现。但就"系统性地理解 2026 年 LLM Agent 的建造、评测与训练全貌"而言,这大概是目前公开可及的最完整的一门课程。





