本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
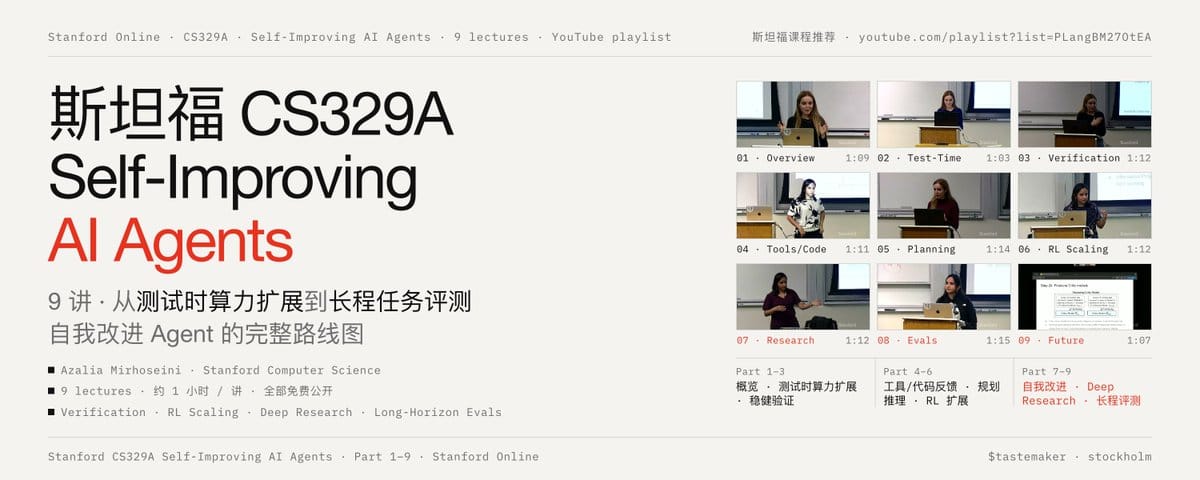
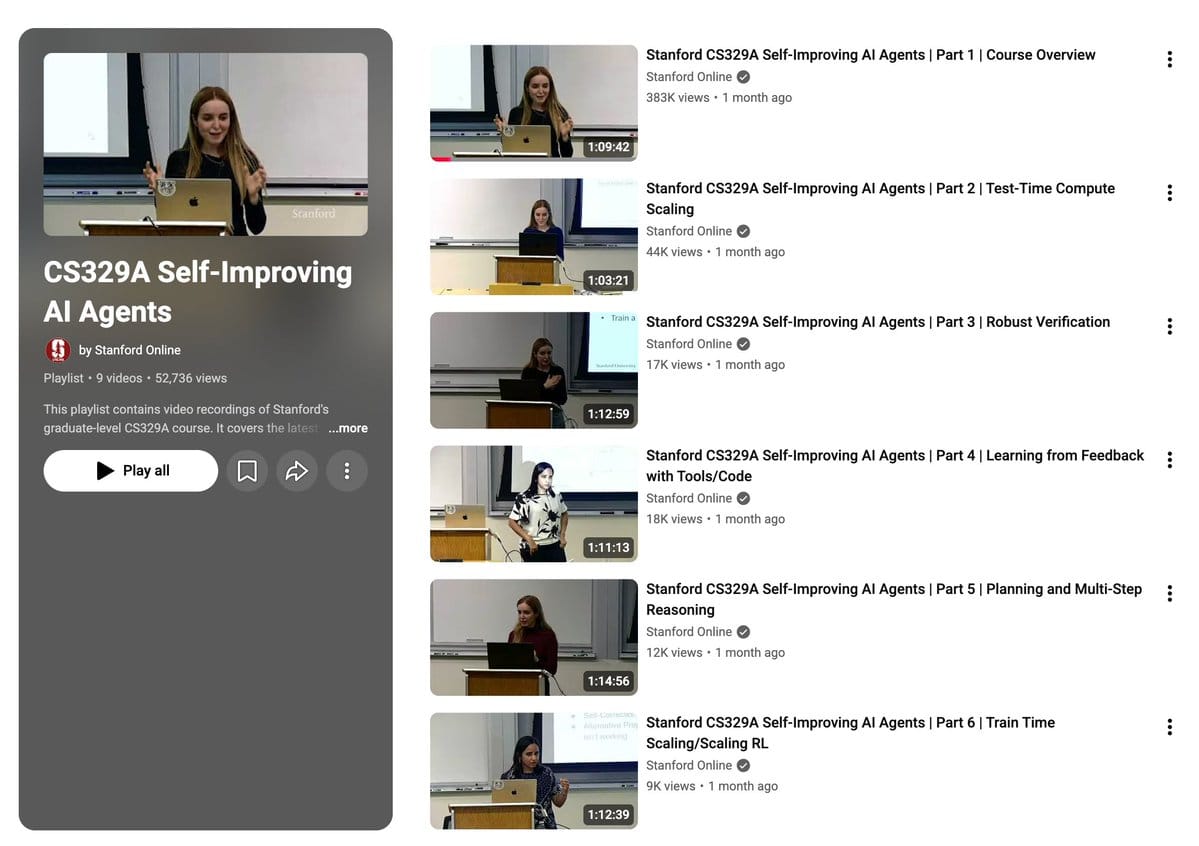
斯坦福大学研究生研讨课,@achowdhery @Azaliamirh 主讲,以 "一线经验 + 论文精读" 为骨架,以 "造一个能自我改进的智能体" 为课程目标,Youtube 已收录全部 9 节课程。
课程地址:https://www.youtube.com/playlist?list=PLangBM27OtEA
贯穿全课的一条主线:生成(大量采样)→ 验证(verifier / reward)→ 筛选(过滤正确轨迹)→ 训练(SFT / RL)→ 更强的模型 → 再生成
第 1 讲 Course Overview — 从 scaling laws 到 agent
三段式历史:参数/数据/算力 scaling(并带来 CoT 等只在大模型出现的涌现能力)→ 后训练(SFT、instruction tuning、RLHF)→ 推理侧 scaling。
关键实验来自 Mirhoseini 实验室的 Large Language Monkeys:对 Llama 3 8B 每题采样至 10,000 次配 verifier,coverage 超过单次 GPT-4o,"模型知道的远多于问一次给出的"。o1 的贡献是把 log-linear scaling 从 pass@k 搬到了 pass@1,即模型学会了在自己的多条推理链中找对的那条。
Agent 的定义:有目标、有规划、与环境交互、依据反馈修正、知道何时停止。讲者坦率指出:现实中多数"agent"仍是人手搭的静态 workflow,只有 coding 和 research 出现"signs of life"。
第 2 讲 Test-Time Compute Scaling
三个层次:
(1) 重复采样呈 power law,其数学根源是数据集里存在"难题长尾"(多数题 pass@1 即解,极难题的数量随难度缓慢衰减);
(2) Snell et al.:ORM vs PRM、parallel vs sequential revision、beam search + PRM;核心结论是易/中等题多花推理算力比扩大预训练划算,最难题仍要靠更强的预训练模型;
(3) Archon:把推理时技术(generator、fuser、critic、ranker、verifier、unit-test 生成/评估)当作可搜索的"架构层",用贝叶斯优化搜索,全开源模型堆叠后 pass@1 平均领先 GPT-4o/Claude 3.5 Sonnet 14.1%。fusion 单独就能超过 oracle selection 是一个反直觉发现。
第 3 讲 Robust Verification — 循环的真正瓶颈
四篇论文构成一条演进线:
Cobbe 2021(ORM,GSM8K;"大 generator + 小 verifier"优于反之)
→ Let's Verify Step by Step(人工标注 PRM800K,PRM 能从正确率 <5% 的难题中挑出罕见正确解,OOD 更鲁棒)
→ Math-Shepherd(用 rollout 自动标注每步"抵达正确答案的潜力",省去人工;但对非常规解法和难题信号弱)
→ Weaver(讲者团队 2025 年工作:不训新 verifier,用 weak supervision 给一组不完美 verifier 加权集成,8B 生成器 + ≤8B verifier 池达到 70B majority voting 的水平,70B 级别 86.2% 接近 o3-mini;再蒸馏成 400M 小模型保留 97% 精度)。
讲者的核心判断:generation–verification gap 是自我改进能走多远的决定因素;可验证领域(数学、代码)能持续复利,创意写作等领域的飞轮会停转。
第 4 讲 Learning from Feedback with Tools/Code
三篇论文只差一个变量——反馈从哪来。
ReAct:环境反馈,思考与动作严格交错,价值在于把内部知识和外部知识结合(并非总是优于 CoT,两者互为回退时最好;WebShop 上 66.6 vs 人类 82.1,差距仍大)。
RLEF:代码执行反馈,用 public tests 迭代、hidden tests 给 PPO 奖励的双层测试防止记忆;关键消融是 base model 只拿到错误反馈并不受益,训练时反复暴露于反馈循环才是增益来源。
Constitutional AI:模型自我批评反馈,人只写原则;CAI-RL + CoT 得到 helpfulness/harmlessness 的最佳前沿。
讲者的补充判断:让模型批评自己往往比想象中难,模型对"不知道自己不知道"过度自信,多模型共识做 critique 有时更好。
第 5 讲 Planning and Multi-Step Reasoning
LATS:把 MCTS(UCT 选择、LLM-as-judge + self-consistency 打分、失败反思回灌)引入 LLM 多步任务,缺点是成本高且假设动作可回退。
SPRINT:把 DeepSeek-R1 的长推理链拆成依赖 DAG,训练 7B 模型输出可并行的 plan/execution,原意是减少 40% 串行 token,意外提升约 3.5% 准确率,并泛化到域外。
SWiRL:离线合成多步工具调用轨迹,用 LLM-as-judge 打过程奖励,逐步 RL;最重要发现是只保留"过程正确"的数据(即便结果错)效果最好,且在 GSM8K+计算器上训练能让 HotpotQA+搜索从 65 提到约 75——模型学到的是"分步思考和调工具的方式",而非具体工具。
第 6 讲 Train-Time Scaling / Scaling RL
STaR → GRPO → DAPO 三级递进。
STaR 是"穷人版 off-policy RL":只保留答案正确的 rationale 反复微调,加上"给答案反推理由"的 rationalization,但会 plateau,且效果上限由 base model 决定。
DeepSeekMath 的两点贡献:从 Common Crawl 精挖数学网页并从 code 模型起步(首次证明 code→math 迁移),以及 GRPO 用组内归一化替代 critic,7B 模型 MATH 过 50%。
DAPO 把 GRPO 直接放大到 Qwen-32B 只有 AIME 30%,四项修正(非对称 clip、动态采样过滤全对/全错组、token-level loss、超长软惩罚)逐步推到 50%。
讲者最重要的一句冷水:三种方法都提升 maj@K 而不提升 pass@K——"模型更一致了,而非根本上更聪明",OOD 泛化未见提升。RL 占训练算力比例从去年约 1% 升至约 5%,但瓶颈在 reward 是否足够强、足够无噪声。
第 7 讲 Self-Improvement and Deep Research Agents
核心命题:"正确解已在模型的输出空间里,问题是如何搜出来。"
AlphaCode:每题采样 100 万、用生成的测试输入聚类、提交 10 个,Codeforces 排名 54.3%;瓶颈在选择阶段(pass@k 40%+,10@k 仅约 30%)。
AlphaCode 2:微调 Gemini Pro 家族 + 学习式 scoring model,100 个样本达到前代 100 万样本的水平,同预算下 43% vs 25%,升至第 85 百分位——"更强的基座 + 更多样的解 + 学到的打分"比堆样本有效。
Search-o1:推理链中动态检索,并加"Reason-in-Documents"模块提炼文档而非原样塞入上下文,解决 agentic RAG 的长上下文崩溃;Search-R1 则用 RL 学会何时搜索。
结尾问答点出:模型聚合后普遍过度自信(50% 正确却表现 80% 信心),校准仍是开放问题。
第 8 讲 Agentic Evaluations and Long-Horizon Tasks
三种评估轴给出截然不同的图景。
METR:50% 成功率的任务时长视界每 7 个月翻倍(Claude 3.7 约 59 分钟),但 80% 视界只有约 15 分钟,可靠性差距巨大;模型表现接近"无上下文的外包工程师",而非领域专家。
GDPval:44 个职业、约 1,320 个真实工作任务,对十年以上经验专家的胜率从 GPT-4o 的 12.4% 线性升至 Claude Opus 4.1 的 47.6%,与 METR 的指数外推形成对照;失败主因是 instruction following(承诺看参考数据却不看、幻觉覆盖)。
DeepScholar-Bench(每月刷新的 related-work 生成基准):没有系统总分超过 19%,"英文很好但事实不全",检索基础性论文与可验证性是硬缺口。
讲者的综合判断:模型在孤立、规范明确、自身擅长的领域(软件工程、ML 研究——"我们在自动化自己的工作")表现好;对需要大量隐性上下文、模糊需求、95% 可靠性的任务信心低。
第 9 讲 Future Research Areas
先重述自我改进循环的三个瓶颈,各配一篇论文:
(1) 推理链多样性——Multi-agent Fine-tuning 用多个专门化 agent 辩论后微调,单模型自训练会崩塌而多模型能持续改进;
(2) 验证——DeepSeek-Math V2 让 verifier 在无参考解下找证明漏洞,再加 meta-verifier 审查 verifier,generator 与 verifier 互相拉升,IMO 2024 shortlist best-of-32 接近 42%;
(3) 训练任务供给——Absolute Zero 让模型自己出题自己解,proposer 奖励设计成偏好"非平凡、非不可能"的中等难度,零人工数据在代码基准达 SOTA 并迁移到数学。
Mirhoseini 补充"Intelligence per Watt":ChatGPT 约 77% 请求不需要前沿模型,本地模型可覆盖 88.7% 查询,两年 IPW 提升 5.3x,推理负载将向边缘迁移。
列出的方向还包括:可验证领域能否带动不可验证领域、continual learning、面向重复采样/多轮修正负载的推理基础设施、能源作为最稀缺资源。
9 节讲座的核心
- 能力是潜在的,瓶颈是选择。 从 Large Language Monkeys 到 AlphaCode 到 Weaver,反复出现的结论是模型采样中已有正确解,差的是把它挑出来的 verifier。推理侧 scaling、训练侧 scaling 都以此为前提。
- 验证的可获得性决定领域的进步速度。 数学、代码、形式证明有近乎免费的 verifier,飞轮转得快;科学发现(验证需要数天仿真或湿实验)、创意写作(主观且易 reward hacking)飞轮转不动。这是课程解释"为什么 coding agent 先成熟"的根本框架。
- 过程监督优于结果监督,但要防假阳性。 PRM 能过滤"过程错、答案对"的样本;SWiRL 进一步显示"过程对、答案错"的样本反而最有训练价值。
- 当前 RL 提升的是一致性,不是根本能力。 maj@K 涨、pass@K 不涨,OOD 泛化未见突破——讲者对"RL 造就新智能"的叙事保持克制。
- 合成数据的跨域迁移是反复出现的信号。 SWiRL、SPRINT、Absolute Zero、DeepSeekMath 都显示在一个可验证域训练的分步/工具行为会迁移到其他域,且大模型吸收 data flywheel 的能力更强。
- 评估必须多轴。 任务时长、经济价值胜率、综合质量给出不同的趋势曲线;"一小时→几天→几周"的外推并不成立。





