本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
人们真的不看代码了吗?完全不懂开发真的也可以吗?每天真的在高效消耗几十亿 token 吗?
@johnjianwang 认为太多这类 "Agentic Engineering 最佳实践" 的内容都难辨真假,那为什么不去分析 Codex 呢?它是极强的 Agent Harness、开源、来自 AI 顶级团队、用 SOTA 模型开发、团队高度使用 Codex,应该是学习 Agentic Engineering 很好的路径!
https://johnjwang.com/post/2026/08/27/learnings-from-the-codex-repo/
核心发现:从一人手写到百人多 agent 并行
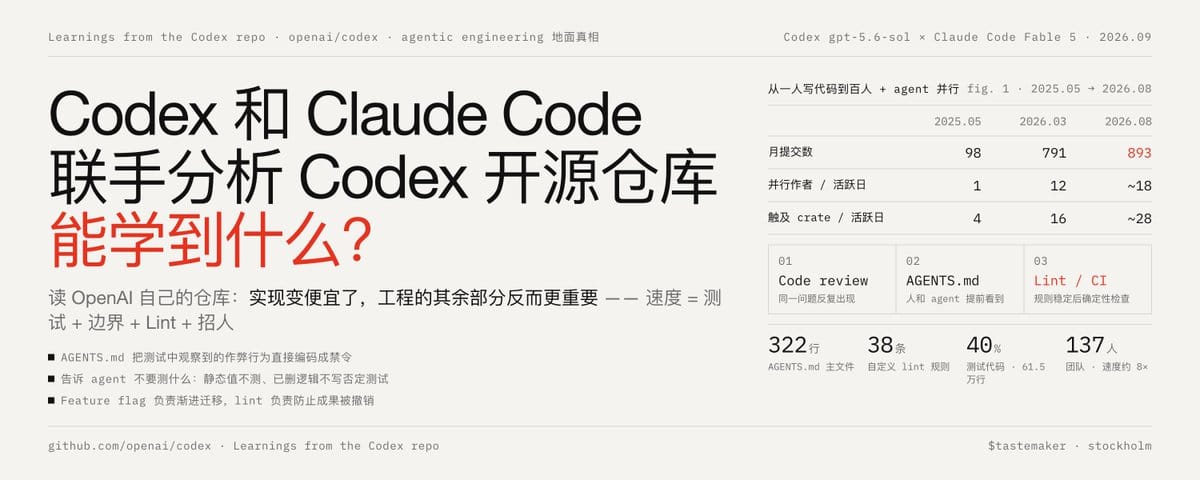
数据变化非常剧烈。2025 年 5 月,Rust 实现有 98 个 commit、6 位作者,其中一人写了 89 个;Michael Bolin 独自完成了前 169 个 Rust commit 中的 150 个。到 2026 年 8 月,前 25 天就有 1000 多个 commit、135 位作者。月提交量从 98 涨到约 900,常规贡献者从 2 人涨到 35 人,最活跃作者的占比从 91% 降到 18%,典型活跃日的并行作者从 1 人涨到约 18 人,同一天触及的 Rust crate 从 4 个涨到约 28 个。
| | 2025.05 | 2026.03 | 2026.08 |
|---|---|---|---|
| 月提交数 | 98 | 791 | 893 |
| 常规贡献者(≥5 commits) | 2 | 28 | 35 |
| 最活跃作者占比 | 91% | 14% | 18% |
| 典型活跃日的并行作者数 | 1 | 12 | ~18 |
| 典型活跃日触及的 Rust crate 数 | 4 | 16 | ~28 |
作者对这个 8 倍增长的解释很克制。他明确指出 commit 数是不完美的指标,并把增长归因于三个因素的叠加:大量使用 coding agent、激进扩招(团队现有 137 人,大多在独立的 crate 上并行工作)、以及对护栏和自动化规则的重投资。第三点是全文重心——人和 agent 越多,"如何工作"的规则就越重要。
AGENTS.md:把踩过的坑编码成规则
Codex 的 AGENTS.md 主文件 322 行,明显经过反复删减。作者挑出四条有代表性的规则。
第一条是禁止修改与 CODEX_SANDBOX_NETWORK_DISABLED_ENV_VAR 和 CODEX_SANDBOX_ENV_VAR 相关的任何代码。一些测试依赖这些变量判断是否能安全运行嵌套沙箱或网络行为,agent 看到这些检查妨碍测试通过时,会倾向于"顺手修掉"。作者认为,把测试中观察到的作弊行为直接写成禁令,是非常聪明的做法。
第二条是不要为静态定义的值写测试,也不要为已删除的逻辑写否定测试。agent 极擅长生成"看起来很严谨"但没有回归价值的测试。明确告诉它不要测什么,才能让测试套件聚焦在真正会坏的行为上。
第三条是改动 agent 逻辑的功能必须加集成测试。agent 行为来自上下文、工具、模型响应和 turn loop 的组合,小的单元测试无法回答"agent 会不会做对"。Codex 的 TestCodexBuilder 用伪造的模型流跑真实的 agent 循环;新测试还需使用自动环境配置,以保证 app-server 和 exec-server 跨操作系统时仍能工作。
第四条是避免 bool 或含义模糊的 Option 参数。如果 API 无法修改,false、None、裸数字这类不透明值旁边必须加精确的 /*param_name*/ 注释。这已经比常见的指令文件具体得多,但更有意思的是团队没有让它停留在指令层面。
规则的三级演进:Review → AGENTS.md → Lint/CI
文章最有洞见的部分。像 foo(false, None, 1000) 这样的调用,不跳转到函数定义几乎无法审查。团队要求改成 foo(/*enabled*/ false, /*parent_turn_id*/ None, /*timeout_ms*/ 1000),然后写了一个自定义 lint,校验注释是否与函数定义中的参数名完全一致。这个 lint 于 2026 年 3 月引入,几天后应用到整个 Rust workspace,随后进入 Bazel CI。
规则也不是一次性出现的。AGENTS.md 支持在 2025 年 5 月落地,更细的测试指南在当年夏天,快照要求在 2026 年 2 月,关于 codex-core 的警告在 3 月,trait 指南在 4 月,模型上下文与改动大小规则在 6 月。这看起来就是团队不断把重复的 review 反馈放到"下一个人或 agent 动手前一定会看到的地方"。
由此归纳出的模式是:问题先在 code review 中反复出现,然后写进 AGENTS.md 让人和 agent 提前看到,等规则足够稳定后再变成 lint 或 CI 检查。 不是每条规则都走到最后一步,但代价高且能客观判定的那些往往会。Codex 目前有 38 条 lint 规则。作者认为这些确定性的自动检查,是 agent 能在这个仓库上高效工作的重要原因。
测试:重投资,分层执行
测试代码约 61.5 万行,占代码库 40%。团队还专门构建了一个 mock 测试框架,约 7000 行代码、300 多个 commit,能 stub Responses API 的 HTTP 响应,跑一个真实的 Codex thread:调用工具、处理审批、多轮迭代,就像真的在与 LLM 交互。这是完全确定性地测试大量行为的方式。作者认为这笔投入非常正确,因为 Codex loop 是产品最核心的部分。
作者所在团队遇到的问题是,agent 写测试越快,测试套件就越慢。Codex 的解法是不在每个阶段都跑同一套巨大的测试,而是让测试深度随代码接近部署而递增。本地开发时只跑受影响的 crate,改终端 UI 就只跑终端 UI 的测试,保证日常编辑-测试循环够快。
合并前,CI 用 Bazel 在 macOS、Linux、Windows 上跑兼容的 Rust 测试,SDK、格式、依赖、仓库规则由独立 job 检查,大任务分机执行并复用远程构建缓存。
合并到 main 之后才付出最昂贵的代价:全量 Cargo 测试跑 5 种平台与架构组合,每个平台编译一次、打包二进制、分发到 4 台机器执行,较慢的 Windows 原生检查、release 构建和远程环境测试也放在这一阶段。
这样既能快速部署,又能在长期保住安全性与正确性。
迁移:Feature flag 推进,Lint 锁定
文章最后观察到的是"老派的高质量工程"。大改动被分阶段进行,新旧实现并存,迁移计划最终被编码进 lint 规则,而不是依赖所有人记住。
TUI 迁移是典型案例。3 月 16 日,团队在 tui_app_server feature flag 后建立了临时的并行实现;10 天后默认开启;稳定后删除旧 TUI、退役 flag,但配置中继续接受旧 flag,避免现有用户报错。两周后,团队加了一条 CI 规则,禁止 TUI 直接 import codex-core。
作者特别认可最后一步。清理一次依赖很容易,但在这么大的团队里,如果 CI 不拦截,总有人会把它加回去。Feature flag 让迁移可以渐进推进,lint 规则则保证成果不会被意外撤销。
结论:速度等于测试、边界、Lint 与招人
Codex 团队在一个被大量使用的生产级代码库上以极快速度推进。速度提升来自 coding agent 与扩招的叠加,而支撑这种叠加的是代码库被明确组织成"给 agent 提供上下文"的形态,以及对测试和边界的持续投资。
作者的核心论点很反直觉:至少在 Codex 团队,实现变便宜之后,工程的其余部分并没有变得不重要,反而更重要了。 测试、高质量的边界与抽象、自动化 lint 系统、招到优秀的人——这些最经典的工程卓越要素,权重都上升了。





