本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。
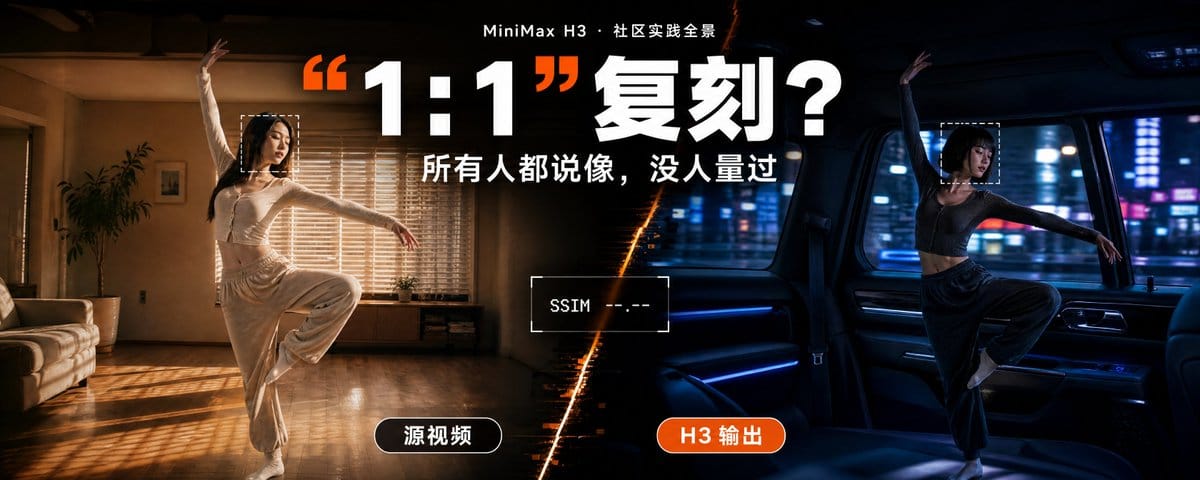
一条推文,75.6 万人看过:一句 Replace the sunlit living room with the interior of a car,人物动作一帧没动,阳光客厅变成了车厢。
一支 B 站教程,5892 播放、478 收藏,标题写着“100% 复刻运镜动作光影”。
一份 400 多次生成的统计:主体描述写得稍弱,大约一半的结果会把人物身份丢掉。
这三件事,说的是同一个模型:MiniMax H3。
更有意思的是,我把截至 2026 年 9 月 2 日散落在 X、B 站、知乎、note、Zenn、Reddit、Hugging Face、GitHub 和各家 ComfyUI 工作流站上的帖子翻了一遍,宣称“1:1 复刻”的数不过来,但没有一个人量过。输出和源片之间的 SSIM、MAE,一个数据都找不到。
所有人都在说像,没有人说有多像。
所以这篇文章只回答一个问题:
H3 在源片编辑这件事上,到底能保住多少,又会在哪里翻车?
先说清楚证据怎么分级
为了不把营销语和实测混在一起,文中的证据按可信度分成五级,从高到低依次是:
- 官方:HF 仓库、官方博客与文档
- 第三方实测:有数据或可复现步骤
- 用户自述:单人经验帖
- 厂商教程:产品营销页附带的方法论
- 未核实:只见到标题或快照
全部关键条目都做过二次核验。正文只在可信度较低或有争议的地方额外标注,核验中发现的张冠李戴和夸大,文末有一份勘误汇总。
01|先把“1:1”打上引号
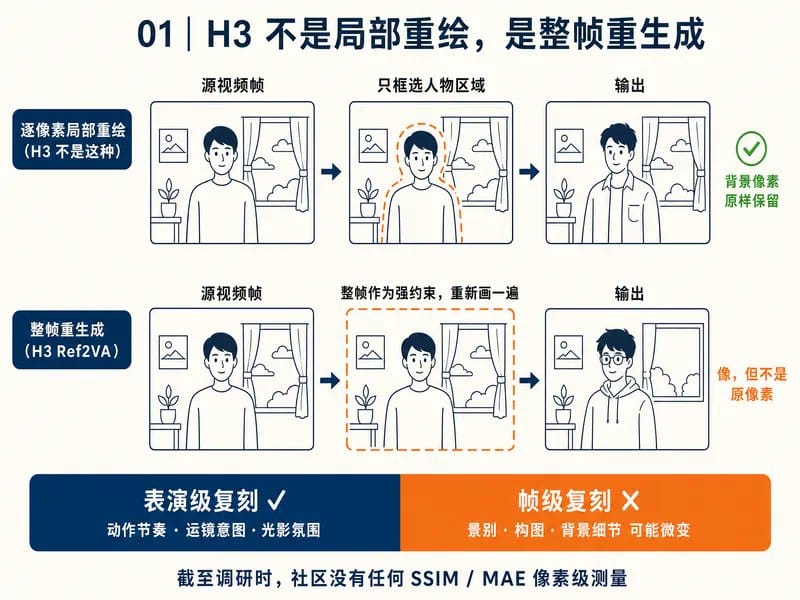
先搞清楚一件事:H3 的编辑路线在技术上到底是什么。
官方称之为 Ref2VA(reference-to-video-and-audio),任务类型为 video editing。它不是逐像素锁定的局部重绘,而是整帧重生成:模型把源视频当作强约束,把整段画面重新画一遍。
换句话说,它“保留”源片的方式,是尽量画得像,而不是原样复制。
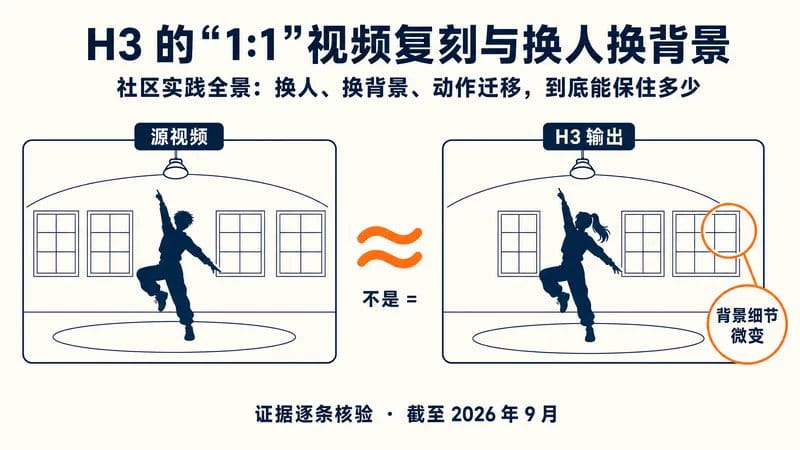
社区大量成功案例证明:结构、运镜、编舞、光影可以保得非常像,肉眼几乎分不出差别。但截至调研时,没有任何一篇帖子对输出和源片做过像素级测量,SSIM、MAE 一个都没有。
所有“100% 复刻”的说法,要么是肉眼看的,要么是营销文案。不一定错,但确实没人量过。
这是社区目前最大的空白,最后一节会给一套自己动手量的方法。
📌 一句话总判断 H3 做的是表演级复刻:动作节奏、运镜意图、光影氛围保得住。 不是帧级复刻:景别、构图、背景细节都可能微变。 要真正的 1:1 背景像素,只有“遮罩合成”这条绕路可走。
02|换人:最热的玩法,也是最软的一环
换人(person swap)是社区围着 H3 玩得最多的东西,正面证据相当充分。
先看正面案例
在 MiniMax Design 官方平台上,@Bhavani_00007 用一段参考视频加三张人物图,通过提示词里的方位映射,把画面里三个舞者分别换成三张参考图上的人。输出 768×1344,一分钟出片,自评脸和光照全程一致。
本地部署方面,@0x0SojalSec 在一张 3090 上跑 ComfyUI 的 Ref2VA 模板,把主角全身替换成 Deadpool。提示词是用 Claude skill 生成的六段式结构,pastebin 公开可查,自评为“完美的角色替换”。
这两条都是用户自述,但都能核实到原帖和配置。需要修正一点:Sojal 帖子回复区有人提到的“+Turbo”是他人补充,并非他本人的配置。
B 站教程要补两个前提
B 站上流传最广的是一段 11 分钟的系统教程(5892 播放、478 收藏),演示换人、换装、换道具,宣称“100% 复刻运镜动作光影”。核实后要补两个前提。
其一,UP 主是“有趣的80后程序员”。此前一些整理资料误写成“甘露斯”,疑似把 GitHub 仓库名 ganloss 误读成了人名。
其二,也是更重要的:该教程基于社区自训底模 10Eros Max 加 LightX2V Turbo,用六层提示词和两段式 3D Latent 放大,工作流 JSON 在 GitHub amao2001/ganloss-latent-space 仓库里。它证明的是这条技术路线可行,不是原版 H3 权重的表现。
教程里最有价值的一条经验:参考视频的帧率和尺寸必须与输出参数对齐,否则直接崩溃。
负面证据同样实锤
官方推广贴的评论区里,有创作者反馈“换完的脸向原人物回拉,太像原人了”。r/StableDiffusion 上有人指出,Ref2VA 每换一个 seed 就出一张不同的脸。
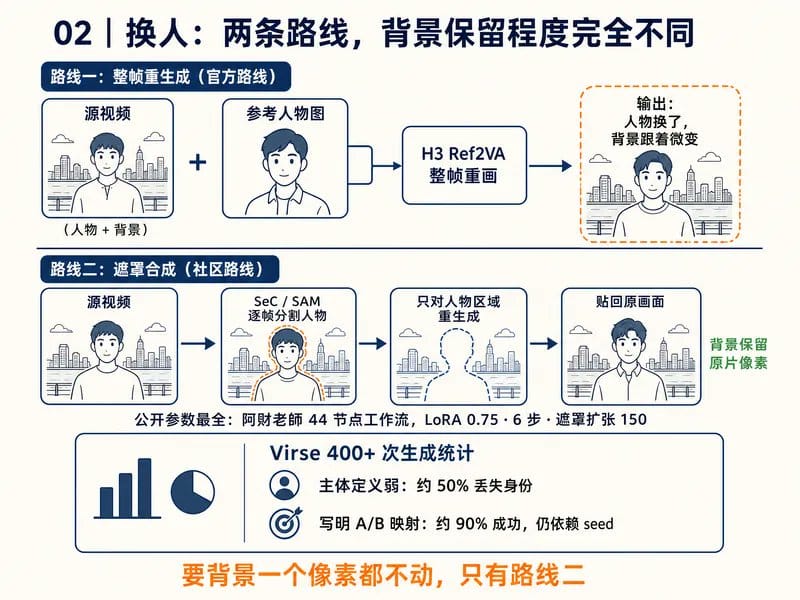
最系统的一组数据来自社区作者 Virse 的 400 多次生成统计:
- 主体定义写得弱的时候,大约一半的生成结果会丢失身份;
- 双人替换若显式写出 A/B 映射关系,成功率能到九成左右,但依然依赖 seed。
这是目前唯一一份带样本量的换人成功率数据。
社区分化出两条路线
围绕身份不稳这个软肋,社区已经分化出两条技术路线。
第一条是官方的整帧重生成路线:一切重画,人物换了,背景也会跟着微变。
第二条是遮罩合成路线:先用 SeC、SAM 这类视频分割模型把人物逐帧抠出来,只对人物区域做重生成,再贴回原画面,背景保留原片像素。
遮罩合成路线目前公开参数最完整的实现,是 RunningHub 上阿財老師发布的 44 节点工作流:BiRefNet 抠参考图、PointsEditor 点选、SeC 逐帧分割、Ref2VA 重生成、贴回原画面。LoRA 强度 0.75、6 步、1344×768、124 帧、遮罩扩张 150,参数已逐项核对。有意思的是它的热度极低,只有 8 次浏览。
RunComfy 也上线了一个 Character Replacement 工作流:SAM3.1 出检测遮罩、ImageCompositeMasked 生成动作参考、Ref2VA 注入新身份图。页面属实,但没有任何量化数据,只能算工作流展示页。
如果目标是“背景一个像素都不能动”,遮罩合成是唯一的选择。
03|换背景:H3 编辑能力里最稳的一项
相比换人,换背景的成功率明显更高,这是社区较为一致的观察。
日本用户 @ponzponz15 用官方平台做过一组绿幕实测:以参考图设定世界观,保住运镜和人物位置,换背景加换服装成功。
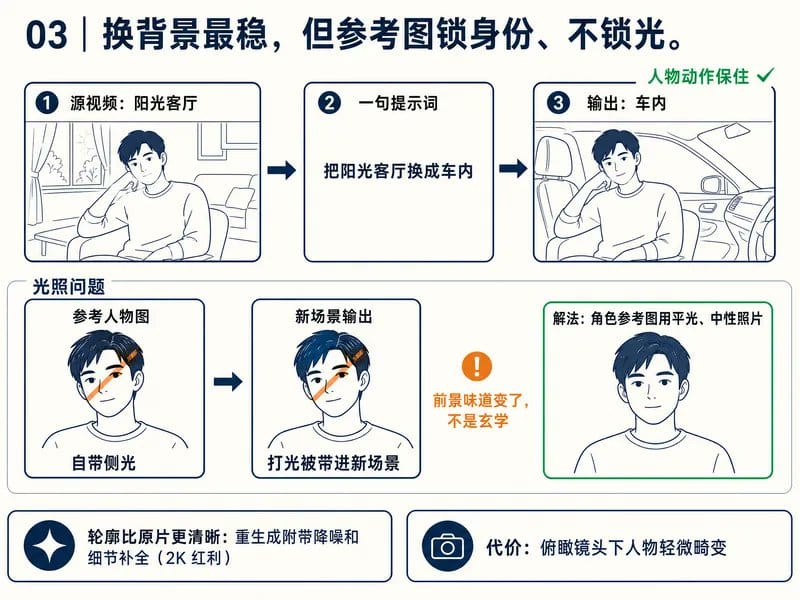
有个意外发现:编辑后的人物轮廓比原片更清晰。重生成过程附带了降噪和细节补全,相当于拿到了 2K 的红利。代价是俯瞰镜头下的人物出现轻微畸变。
他的另一组 VFX 局部修改(摩托换成猪、体育场加观众)只生成了一两次,样本很小,但评价是“以前的模型改局部会整体劣化,H3 这次相当好”。回复区还有人对比 Gemini Omni 在同类任务下的劣化明显更严重。
@codedailyML 一条 75.6 万浏览的推文,用一句提示词 Replace the sunlit living room with the interior of a car(把阳光客厅换成车内),保住人物动作换掉了整个环境。这条的价值在传播广度:说明“一句话换场景”已经进了大众对 H3 的认知。
知乎作者“卡尔的AI沃茨”做了一次更进一步的测试:一条 6 秒源片,一次指令同时把猫的眼睛换成蓝色、把大海换成草原,其余画面保持不变。效果仅有动图为证,没有量化。
换背景也有一条系统性的代价
来自 AtlasCloud 在 API 层的第三方实测:参考图锁身份,但不锁光。
参考图自带的打光会被拖进新场景。所以“换了背景以后前景的味道也变了”不是玄学,是参考图的光被带进去了。
对应的解法:角色参考图一律用平光、中性的照片。
04|动作迁移:官方主打卖点,社区实操最容易翻车
官方博客把 V2V 动作迁移(motion transfer)列为三大商用强项之一。但社区的体验要复杂得多。
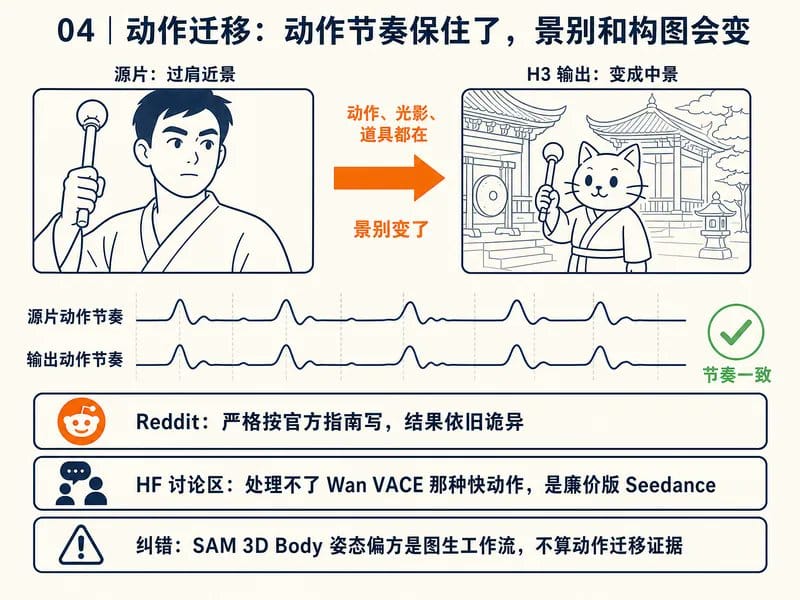
r/StableDiffusion 上有人严格按官方指南写动作迁移提示词,结果依旧诡异。
Hugging Face 讨论区一位资深用户的结论更直接:“H3 处理不了 Wan VACE 那种快速动作,它是廉价版 Seedance,不是替代品。”(原文:a budget seedance, not a replacement)Wan VACE 是 Wan 系列专门做视频编辑与控制的模型,后文竞品一节还会提到。
B 站上还有一条标题为 H3 换人“minimax 完败”Wan2.2 Animate 的对比视频。本次调研只见到搜索快照的标题,正片未看,存在标题党可能,标为未核实。
成功案例的共同特征:动作节奏保住了,但景别和构图可能变。
前述知乎作者用憨豆先生的寺庙片段做动作参考,把和尚和憨豆分别换成 2D 的猫和老鼠。剧情演绎完全保留,虚化和光影被复现,锣槌这类道具还被自动补全了。但原片的过肩近景,在输出里变成了中景。
这正是“表演级复刻”与“帧级复刻”的区别在真实案例里的样子。
一条广为流传的偏方需要纠错
“用 SAM 3D Body 做姿态估计再转成自然语言提示词”的那条 615 赞推文,作者是 @tori29umai,不是此前资料里写的 @grmchn4ai。
而且它的场景是拿一张姿势参考图改姿势的图生工作流,拿来当动作迁移的证据是牵强的。
05|官方规范的正确写法
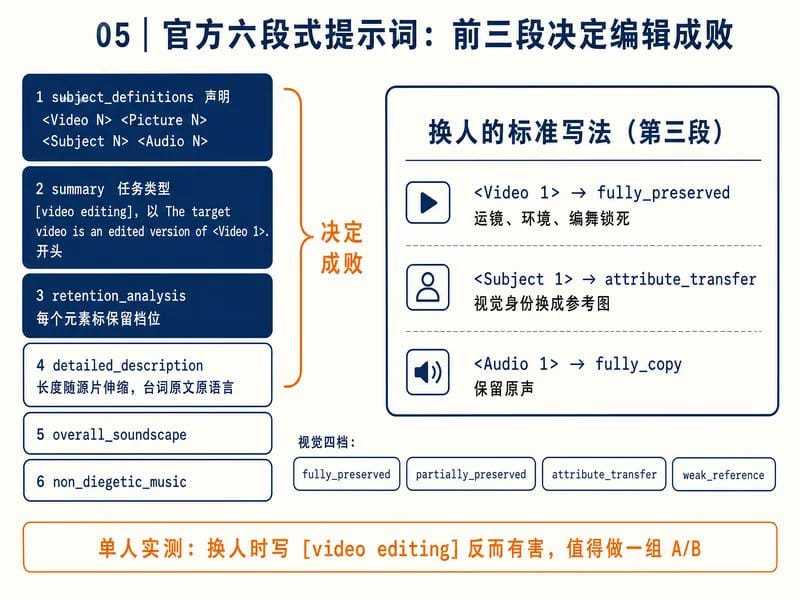
官方在 HF 仓库的 docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md 里给出了编辑任务的提示词规范。
它是一个六段式结构,依次是:subject_definitions、summary、retention_analysis、detailed_description、overall_soundscape、non_diegetic_music。
社区绝大多数成功案例都遵循了它,绝大多数翻车案例都在某一段上违反了它。真正决定编辑成败的是前三段。
第一段:subject_definitions
声明每一个 <Subject N>、<Picture N>、<Video N>、<Audio N>。
关键规则:<strong><Video N> </strong>只留给“整片级关系”,也就是编辑原片、续拍、参考运镜或剪辑节奏。如果只是想从参考视频里复用某个人或物,仍要归到 <Subject N>。
第二段:summary
对编辑任务有硬格式要求:
- 任务类型必须写 [video editing],且仅当源视频被直接修改时才用;
- 要保留原声,必须组合成 [video editing + audio reuse];
- 前缀之后必须以 The target video is an edited version of <Video 1>. 开头。
如果只是借运镜和节奏而不改源片,任务类型应归为 reference generation。
第三段:retention_analysis
用四档标记每个元素的保留程度:fully_preserved、partially_preserved、attribute_transfer、weak_reference。
音频独立四档:fully_copy、partially_copy、reference、weak_reference。
换人的核心就在第三段。
官方对 attribute_transfer 的定义是“参考特征被转移到另一个可识别的目标主体上”(原文:Referenced characteristics are transferred to a different identifiable target subject)。
所以换人的标准写法是:源片人物这个“槽位”标 <strong>attribute_transfer</strong>,让视觉身份换成参考图;镜头、环境、编舞标 <strong>fully_preserved </strong>**锁死。**官方还明确了一点:新加的动作、背景、剧情不算保真度损失。
第四段:detailed_description
需要知道的只有三条:
- 编辑描述的长度随源片复杂度伸缩,不受生成任务 350–500 词区间的约束;
- 在源状态生效的地方自然引用 <Video N>;
- 复用参考音频里的台词必须原文原语言,听不清的写 [unclear],不允许编。
一条与官方相悖的实测
r/StableDiffusion 上一位用户在几次测试后发现,换人任务里写 [video editing] 或 [video editing + reference generation] 反而有害,改用其他任务标记效果更好。
单人经验,样本量不明,推翻不了官方文档,但值得拿来做一组 A/B。
一份可以直接抄的换人提示词骨架
综合 Sojal 的 pastebin(已逐字核实)、WeShop 模板和 Civitai 上的绿幕配方,骨架如下:
subject_definitions:
<Video 1> is the video being edited; its camera
framing, handheld motion, cuts, and choreography
timing are the fixed structure to preserve exactly.
<Picture 1> is the sole identity reference for the
replacement performer: use only the face, head
shape, skin tone and hairstyle. Ignore its
background, pose, lighting and camera angle.
<Subject 1> is the performer in <Video 1> whose
visual identity will be replaced.

summary:
[video editing + audio reuse] The target video is
an edited version of <Video 1>. Replace only
<Subject 1>'s visual identity with the person from
<Picture 1>, preserving everything else.

retention_analysis:
<Video 1>: fully_preserved — camera path, framing,
cuts, environment, lighting, choreography, timing.
<Subject 1>: attribute_transfer — face, head shape
and hair from <Picture 1>; body proportions,
wardrobe, motion, position, speed and timing are
inherited frame by frame. Preserve occlusions
(hands, props passing over the face) exactly.
<Audio 1>: fully_copy.

detailed_description:
(一两句风格 + 逐秒动作锚点:at 1.5s ..., at 3s ...
引用 <Video 1> 的状态;结尾列 AVOID:re-animating
the subject, changing camera motion, adding new
actions/objects/cuts/text, edge halos,
altered lip timing.)
围绕这份骨架,社区积累了几条写法共识
- 参考图只写正向职责加排除项,否则参考图的背景会串进画面(metaso 与 @johnAGI168 的写法)。
- 多视角参考拼成一张图,效果好于分别上传三张(WeShop,厂商教程)。
- 减少参考图数量反而能提升身份准确度;过度结构化的提示词会“保留过头,几乎没换”(Virse 400 多次统计)。
- 遮挡必须显式写明保留(preserve occlusion),手过脸、道具过脸这类地方不写就会出问题(Virse)。
官方自己的标准答案
官方给出的“1:1 保留加局部改”范例,是 HF 仓库里的 scripts/readme/reproducible-768p-ref2va-request.sh:源视频加参考音频,任务标记 [video editing + audio reference + audio reuse],<Video 1> 标 fully_preserved,保住源片的运镜、场景、背景,只改人物口播。
06|失败模式与硬限制清单
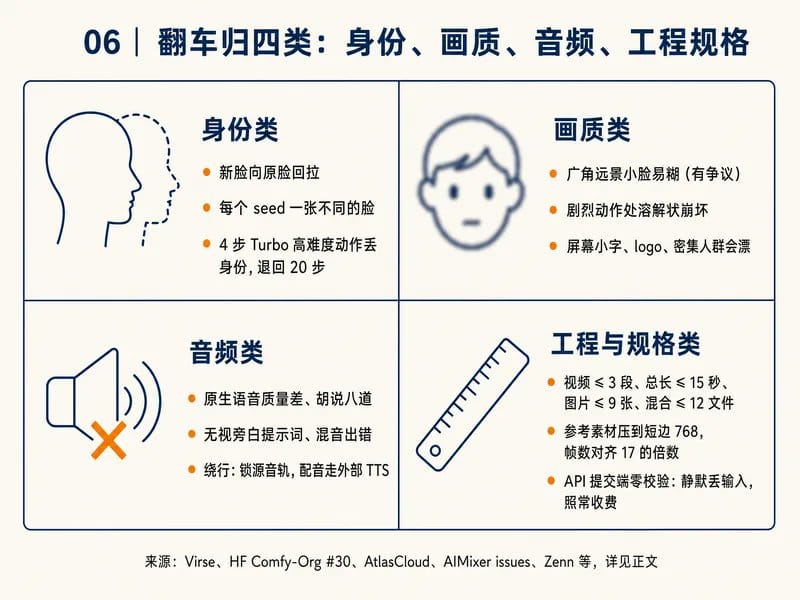
把社区各处报告的翻车归类之后,大致落在四组。这一节是给人回来查的,按条目列。
身份类
- 换人后新脸向原脸回拉,“换出来的脸还是有点太像原人”(官方推广贴下创作者反馈,原文 faces ended up a little too similar)。
- 每个 seed 出不同的脸。一位用户的修复经验:参考图先缩放到长边 1280 再送进采样器(r/StableDiffusion,用户自述)。
- 漂移不是显存问题:Virse 用 848×1264 的全身参考图配 1280×720、14.4 秒的源片,在 16GB 的 5070 Ti 上仍然漂移。
- 4 步 Turbo 适合快速迭代,但高难度动作会丢身份,需要退回 20 步左右(Virse)。
画质类
- 广角或远景的小脸容易糊,但这条有争议:LabMike3D 称 1376×768、24 步也救不了;同帖里 rocky533 反驳说 1.0MP 配 Turbo LoRA 是甜点位、脸是清楚的,010O11 用 0.6MP 竖幅出了清晰的远脸(HF Comfy-Org discussion #30,帖内多方)。
- 剧烈动作处人物和背景出现溶解状崩坏,复杂运镜的源片输出不自然;舞蹈类或无运镜的片源效果更好(note.com 嗚呼蛙,官方 Ref2VA 模板、int8 模型、864×480/5 秒、16GB 显存;注意其源片是 AI 生成而非实拍)。
- 用 latent upscaler 补救会毁细节并破坏时序;EasyCache 节点会降质(HF #30)。
- 屏幕小字、精确 logo、密集人群这类要求帧级一致的元素会漂。Runware 官方文档承认了这一点,但同样无人量化测过。
音频类
- “H3 生成的语音质量极差,还时不时胡说八道”(AIMixer issue #62 用户原话)。
- 音频幻觉:无视旁白提示词;喂自定义音频时中途出错、变成杂乱的混音(HF #30)。
- 社区绕行方案:锁死输入语音,配音走外部 TTS 和唇形同步。seitanism/ComfyUI-H3-Motion-Context-MultiRef(165★)就是为此而生。
工程与规格类
- 输入硬边界(官方):视频最多 3 段,单段 2–15 秒,总长不超过 15 秒;图片最多 9 张(AtlasCloud 在 API 层测出 10 张也能过,9 是网页 UI 的限制);音频最多 3 段;混合输入不超过 12 个文件;i2v 与 r2v 互斥;H3-Max 快速版不支持 reference-to-video。
- 参考素材会被 adapt_canvas 压到短边 768、上限 768×1344(AtlasCloud 实测 16:9 输出为 1344×768 印证)。
- 帧数网格:max(5, round(sec×24)) 再对齐到 17 的倍数(官方 ComfyUI 模板)。
- API 提交端零校验:first_frame 和 refers 同时传不报错,静默丢掉一半输入,照常收全价(AtlasCloud,两个方向各花 $0.40 验证)。
- 参考图不锁光,会把自带打光拖进新场景;角色参考图要平光中性(AtlasCloud)。
- REF2VA 分发包不带 turbo LoRA,16 步会在 sigma≈0.44 处停住、全面发糊;把 FL2VA(H3 的图生视频入口)包里的 turbo_lora.safetensors 复制过去即可解决(Zenn Accenture,第三方实测)。
- drbaph 发布的 4 步 Turbo LoRA(强度 2.8)是流传的修脸配方,但该文件近期被 HF 标了安全警告且未作解释,下载需谨慎(HF #30)。
- 速度:编辑任务约为普通图参考生成的两倍开销;3060 12GB 跑 1.34MP、8 秒需要 25 分钟,比同为开源的 LTX 慢一个量级(Virse 与 HF #30)。
- AIMixer 是 ComfyUI 生态里 star 最多的 H3 节点包(1241★),其 Director 工作流有几个已核实原帖的 bug:#51 v2v/rv2v 源素材缓存不刷新(已关闭,“修复”是从状态推断的);#87 段间引导会吞掉末尾对话;#58 多段拼接时逐段劣化。
- 源片先降一档分辨率再进节点可以提高编辑成功率;贴脸、半张脸、剧烈运动的片源最难(r/StableDiffusion SCAIL 帖,用户自述)。
07|竞品坐标
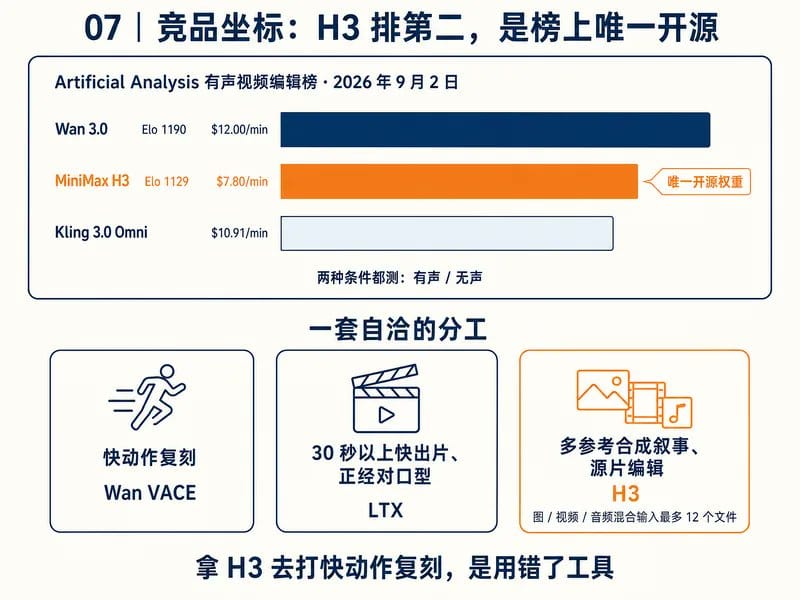
在 Artificial Analysis 的有声视频编辑榜上(2026 年 9 月 2 日实抓),H3 以 Elo 1129 排第二,12,936 票,$7.80/min,是榜上唯一的开源权重模型。
第一是 Wan 3.0,Elo 1190,2026 年 8 月上榜,$12.00/min。Kling 3.0 Omni 也在榜,$10.91/min。Runway 的 Act-One/Act-Two 不在此榜。
两条需要更正的流传信息
“H3 Elo 1130 第一”已经不成立:Wan 3.0 上榜后 H3 退居第二,开源仍是第一。
这个榜不是强制开声音,with-audio 和 no-audio 两种条件都测。
分维度看
H3 的弱项是快动作和复杂运动。HF #30 那位用户的原话是“做不了 VACE 能做的快动作”“过不了我的直觉测试”,并推荐 Wan 2.1 VACE 作为快动作复刻首选。AtlasCloud 的横评认为 Kling 强在大幅运动场景和 4K。Act-Two 本身就是动作迁移专用模型。
H3 的独有强项是多模态参考:图、视频、音频混合输入最多 12 个文件,原生音频,一句话同时指定运镜、人物和人声。
价格上,$7.80/min 约为 Seedance 2.0 的四分之一(@aiwarts)、Veo 3.1 的三分之一(PixMind 转述)。真实感方面,@johnAGI168 的横评认为“Seedance 2.5 仍遥遥领先 H3”。编辑时不劣化无关区域这一项,H3 优于 Gemini Omni(前述日本用户对比)。
一套自洽的分工 HF #30 里 rocky533 的说法虽是一家之言,但和上面所有证据吻合: 快动作复刻用 Wan VACE,30 秒以上快出片和正经对口型用 LTX,多参考合成叙事用 H3。 H3 的位置是“源片编辑加多参考合成”这一格,拿它去打快动作复刻是用错了工具。
08|哪些“证据”需要降权
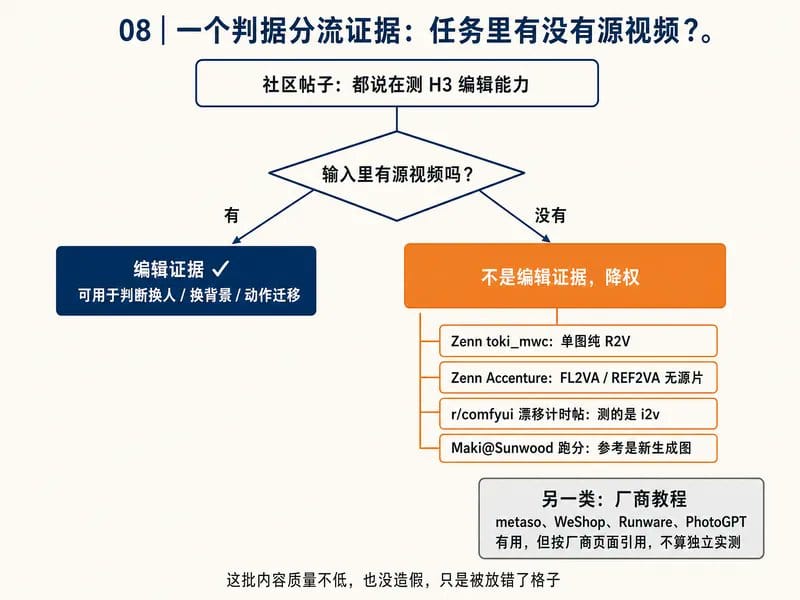
还有一批帖子经常被拿来证明 H3 的编辑能力,但仔细看,它们测的根本不是编辑。
这批内容质量不低,也没造假,只是被放错了格子。上文的结论都已经把它们剔出去了。
Zenn toki_mwc 的单变量实验
结构化提示词 3/3 成功对比非结构化 1/3,四视图参考图没有收益。实验严谨,但它用的是单张角色图的纯 R2V 生成,没有源视频。
所以它是提示词方法论的证据,不是换人或编辑的证据。另外它引用的“七段结构”直接出处是 Reddit 社区用例,不是官方指南原文。
Zenn Accenture 团队的 FL2VA 与 REF2VA 对比
在 M4 Max 上做的对比(85/86GB 内存占用、turbo LoRA 缺失的坑)也一样:FL2VA 是 i2v,REF2VA 是图参考生成,全程没有源视频。
它证明的是人物一致性和本地部署的问题。坑本身很有用,第六节已经用到,但它不是编辑证据。
厂商教程类
秘塔 metaso 的《小白导演课》提出的素材职责分配方法(“图片 1 管人物,视频 1 管动作,排除项防串场”)是有用的,但它的 27 条成片加首帧锁脸演示是 FL2VA/i2v,而且是给自家 H3 入口引流的厂商教程。
WeShop 的三视图拼合换人指南内容扎实,模板和 QC 清单都是真的,但它是 WeShop 产品页,单案例无量化,同样只能按厂商教程引用。
@itsphotogptai 那句“对构图和音频的尊重非常出色”出自 PhotoGPT 套壳平台带引流链接的营销号,只能当“有人这么用”的存在性证据。
测的是 i2v 而非编辑
r/comfyui 一篇身份漂移计时帖(特写约 3 秒开始崩)常被引用为编辑保真度数据,但作者自己标明测的是 i2v 漂移,只能作旁证。
Maki@Sunwood 在 4090 上的 Ref2VA 跑分(898 秒出 1280×704、175 帧),参考是新生成的图、没有源视频,是一条 3 赞视频的小样本性能数据点。
利益相关说明
huangserva/ComfyUI_MiniMaxH3_Director(828★)是我自己维护的仓库,先把关系说清楚。它保存了 5 份可以直接导入 ComfyUI 的 H3 Director 工作流,底层节点来自 AIMixer 的导演台插件。
统计生态时我把它照常算进去:AIMixer 1241★,这个工作流仓库 828★,加至少十个第三方仓库,H3 的 ComfyUI 生态是活跃的。至于为什么推荐拿它起步,第九节实验方案里会说。
09|如何自己把“1:1”量出来
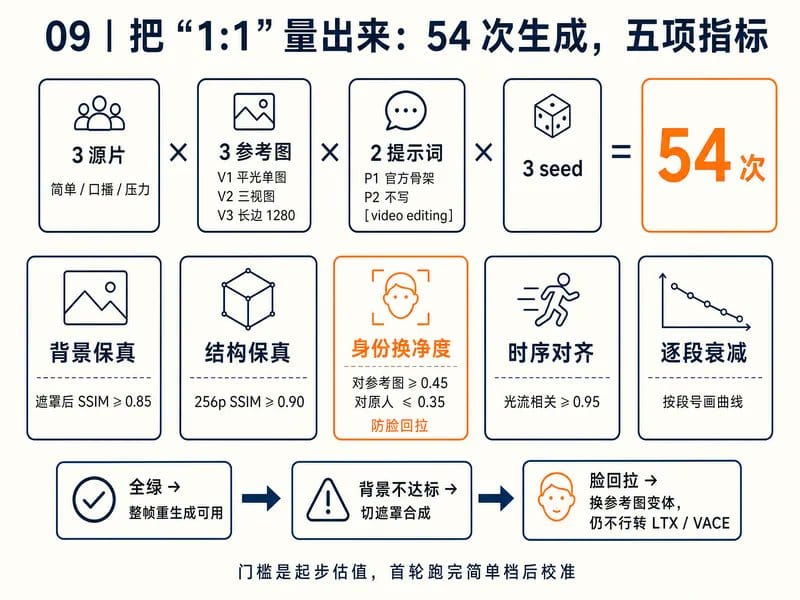
前面反复提到,社区没有人对 H3 的编辑保真度做过量化。这件事其实不难,全部指标用 ffmpeg 加开源模型就能算。
下面是一套可以直接照做的实验设计。
源片分三档
每条裁到 10 秒以内、24fps。
- 简单档:固定机位、中景、单人、动作平缓。社区共识里最容易过的片型。
- 口播档:中近景人物口播。与官方 reproducible 脚本是同款任务,有官方标准答案可对照。
- 压力档:把手部过脸遮挡、转身、发型飘动全塞进一条。预期翻车,用来标定能力边界。
预处理每条必做
源片帧率和尺寸与输出参数对齐(B 站教程的崩溃坑),帧数按 17 的倍数网格取。
源片主动降一档分辨率再进节点,作为 A/B 变量。
如果用 AIMixer,每换素材就重启或换文件名,防御性绕开 #51 的缓存问题。
工作流直接从我的仓库拿
节点包我推荐 AIMixer 的导演台,工作流可以从我维护的 huangserva/ComfyUI_MiniMaxH3_Director 拿现成的:5 份 JSON,覆盖 T2V、首尾帧、R2V、V2V 和 RV2V。其中 RV2V 就是“源视频加参考图或参考音频”这条线,正对着本文的换人实验。
导演台按镜头切段(也可以智能分割),每段单独写提示词,源片段绑定为 <Video 1>,参考素材用 <Picture N>、<Audio J>。它支持逐段选择运行和缓存,改一段不用重跑整条时间轴,54 次生成的矩阵跑起来能省不少时间。音频可以选模型生成、沿用原声或静音,跟上面“锁 audio reuse 保源音轨”的建议是配套的。
我自己的习惯是先生成 5 秒,检查脸部、服装、动作和镜头边界,没问题再扩展。环境要求 ComfyUI 0.30.0 以上,CLIP Loader 类型选 minimax。仓库和上游插件都是 Apache-2.0。利益相关在第八节已经说明,仓库地址在文末。
参考图每个身份出三个变体
- V1:单张正面平光中性照(回应 AtlasCloud 的“不锁光”结论)。
- V2:正面、背面、特写拼成一张的三视图(WeShop 配方)。
- V3:V1 缩放到长边 1280(r/StableDiffusion 修 seed 脸的偏方)。
注意参考图会被压到短边 768,别把像素浪费在背景上,人物要占满画幅。
提示词两个变体
- P1:第五节的官方六段式骨架。
- P2:内容相同,但任务标记不写 [video editing],用来验证 Reddit 那条“官方标记反而有害”的说法。
实验矩阵
3 源片 × 3 参考图 × 2 提示词 × 3 seed,共 54 次生成。
先用 Turbo 低分辨率初筛(turbo LoRA 从 FL2VA 包拷来,有安全警告的 drbaph 版本先不碰),过筛的用 20 步终跑。ref_image_size=max 只在终跑时开,因为已知会慢几倍。
核心测量指标分为五项
- 背景保真:用 SAM 或 BiRefNet 把人物遮罩掉,对遮罩后的背景区逐帧与源片算 SSIM 和 MAE。这是社区完全空白的数字。
- 结构保真:整帧降采样到 256p 后算 SSIM,滤掉重生成的纹理噪声,只看构图和运镜是否一致。
- 身份换净度:对输出人脸提取 embedding(ArcFace 一类),分别对参考图和源片原人脸算余弦相似度。第二个数专门防“脸回拉”:对参考图要高,对原人要低,两头都要卡。
- 时序对齐:源片与输出的光流能量曲线求相关系数,看动作节奏是否一致。
- 逐段衰减:多段拼接时按段号画指标曲线,验证 #58 报告的衰减是否存在。
过门线作为首轮标定值
一组可以起步的参考数:
- 背景遮罩后 SSIM ≥ 0.85(整帧重生成路线;若走遮罩合成路线,背景是原像素,应直接套用更严的像素级门槛);
- 256p 结构 SSIM ≥ 0.90;
- 身份对参考图余弦 ≥ 0.45,且对源片原人 ≤ 0.35;
- 时序相关 ≥ 0.95。
得说清楚:这些线没有社区先例可抄,是起步用的估值。首轮跑完简单档,第一件事就是把线校准出来。
结果判定逻辑
简单档与口播档全绿:说明整帧重生成路线在这类片型上可用。
背景 SSIM 不达标但身份达标:切到遮罩合成路线,照抄阿財老師公开的参数,SeC 分割、只重生成人物、贴回原画,LoRA 0.75、6 步、遮罩扩张 150。
身份出现“脸回拉”(对原人余弦超线):先上 V2/V3 参考图变体并减少参考图数量(Virse 的结论),仍不行则判该片型 H3 不可用,转 LTX 或 VACE。
音频一律不用 H3 原生:锁 audio reuse 保源音轨,配音走外部 TTS。这是社区 issue #62 的通用绕行方案。
写在最后
开头说“1:1”要打引号,原因不是 H3 做不到,是没人量过。
54 次生成跑完,那对引号该去还是该留,就不用再靠肉眼和营销文案争了,看数字。
附一|本次核验的勘误汇总
- SAM 3D Body 姿态偏方的作者是 @tori29umai,不是 @grmchn4ai。
- B 站教程 UP 主是**“有趣的80后程序员”**,不是“甘露斯”(疑似把 GitHub 仓库名 ganloss 误读成人名),且教程基于 10Eros Max 社区底模而非原版 H3。
- huangserva/ComfyUI_MiniMaxH3_Director(828★)是本文作者维护的仓库,工作流来自 AIMixer 上游。文中已作利益相关声明,生态统计照常计入。
- AA 榜“H3 第一”已过时,现为 Wan 3.0 第一、H3 第二(开源第一)。
- AA 编辑榜不是强制开声音,with-audio 和 no-audio 两种条件都测。
- Sojal 帖中贴的是 base 版提示词指南链接而非 ref 版;“+Turbo”是他人回复补充,非本人配置。
- WeShop、metaso、Runware、PhotoGPT 均为厂商自家页面,应按“厂商教程”引用,不是独立实测。
- “广角脸糊提分辨率救不了”是单人断言且同帖被实测反驳,引用需带争议标注。
附二|主要出处
公众号正文不支持外链跳转,以下链接以文本形式列出,可复制访问。
- @Bhavani_00007 三人换人:x.com/Bhavani_00007/status/2090381046651224224
- @0x0SojalSec 全身换人:x.com/0x0SojalSec/status/2089349548347105623
- B 站换人/换装/换道具教程:bilibili.com/video/BV1v24f6FEuH
- RunningHub 阿財老師遮罩合成工作流:runninghub.ai/zh-cn/post/2090413724438994945
- RunComfy Character Replacement 工作流:runcomfy.com/comfyui-workflows/minimax-h3-character-replacement-comfyui-sam3-ref2va
- @ponzponz15 绿幕换背景:x.com/ponzponz15/status/2083718891768091115
- @ponzponz15 VFX 局部改:x.com/ponzponz15/status/2084474728304304443
- @codedailyML 换场景:x.com/codedailyML/status/2087885987305463967
- 知乎“卡尔的AI沃茨”实测:zhuanlan.zhihu.com/p/2067020688339346386
- note.com 嗚呼蛙换人实测:note.com/aaafrog/n/na4de71e4f808
- 官方 Ref2VA 口播编辑范例:huggingface.co/MiniMaxAI/MiniMax-H3/blob/main/scripts/readme/reproducible-768p-ref2va-request.sh
- 官方提示词规范:HF 仓库 docs/VIDEO_PROMPT_WRITING_GUIDE_ref_en.md
- 本文作者维护的 H3 Director 工作流仓库:github.com/huangserva/ComfyUI_MiniMaxH3_Director
待补链接:Virse 400+ 次生成统计、HF Comfy-Org discussion #30、AtlasCloud API 层实测、Zenn toki_mwc 与 Accenture 两篇、AIMixer issue #51/#58/#62/#87、Artificial Analysis 有声视频编辑榜快照。