本文作者:huangserva(@servasyy_ai)。版权归作者所有,未经授权禁止转载。
你有没有发现,Codex 越来越贵,用量越来越少?
用 Codex 的人最近应该都有同感:账单越来越贵,能用的量越来越少。以前一周够用的额度,现在一两天就见底;就算你是 20X 的用户,全程开着顶配模型,也根本顶不住。
我自己就是这样。花钱不是最难受的,最难受的是额度用完了活还没干完,只能干等。
但仔细看会话记录会发现,大部分线程根本不需要顶配:改个配置、跑个脚本、批量重命名,用便宜档一样能做对。真正需要顶配的,是那些长上下文、多轮推理的父线程。问题是没人帮我在两档之间做选择。
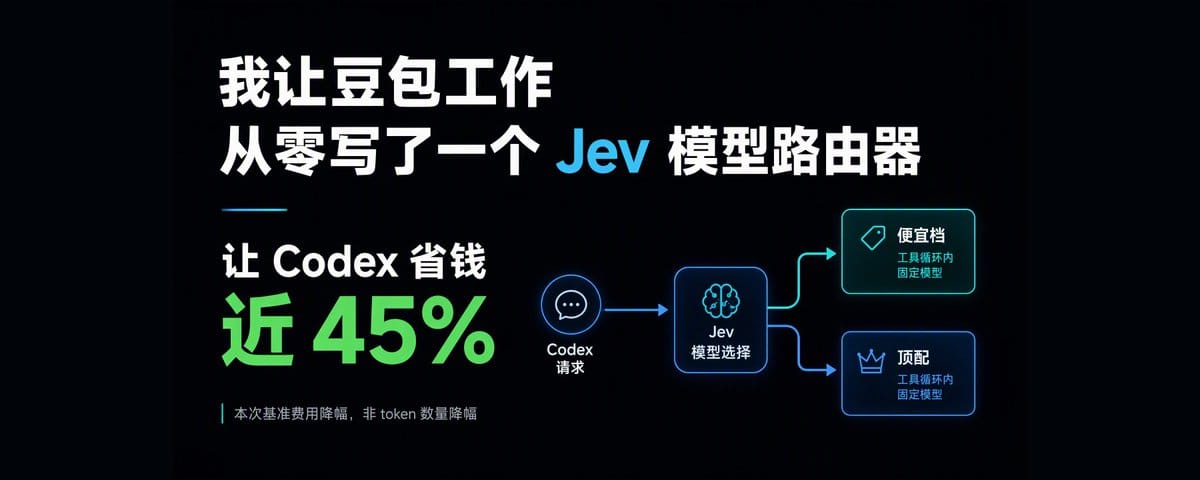
这时候我想到了 Jev。TypeSafe AI 刚发布的模型,最近很火,但它和你熟悉的大模型不是一回事:它不聊天、不写代码、不生成任何文字,只做一件事——你给它一段状态和几个选项,它直接返回一个带概率的判断。因为不用逐字生成,一次前向计算就出结果,延迟在几百毫秒以内,输入每百万 token 只要 0.042 美元,输出免费。
「该用便宜档还是顶配?」正好就是这样一个判断题。我就想,能不能用 Jev 的这个特性和速度,跟 Codex 结合一下,让它来做模型选择,把钱省下来呢?
于是我做了一个路由器,让 Jev 专门负责挑模型:这条线程该走便宜档还是顶配。但真正花时间的不是“让 Jev 判断”,而是搞清楚什么时候该问它。
这个路由器不是我自己写的。我用豆包工作让它从零做的,我一行代码都没写。
每步都换模型,反而更贵
一开始我以为每个请求都需要判断一次、简单的就换便宜档。
试了之后,中途换模型会让缓存作废,token消耗反而涨了。
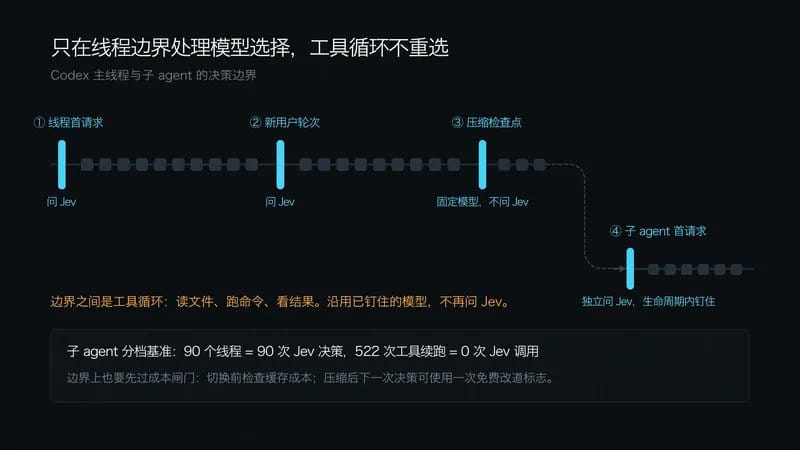
所以规则,只在缓存本来就要重建的四个时刻换模型:线程首请求、新用户轮次、压缩检查点、子agent首请求,中间的工具循环不会请求Jev,沿用之前的模型。
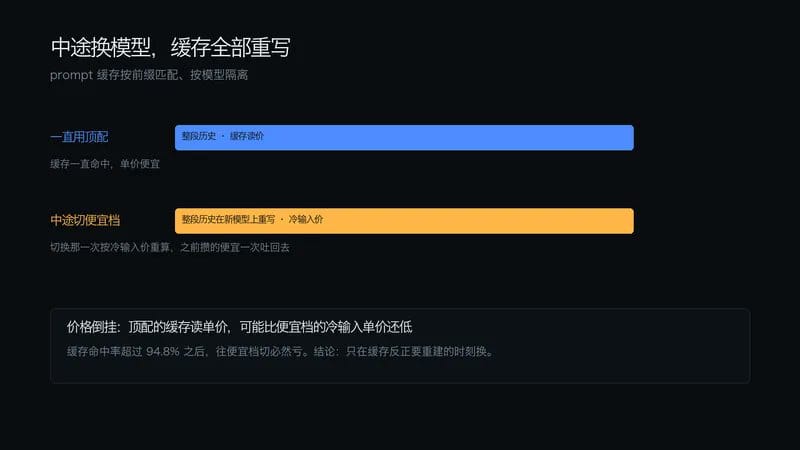
图中的 94.8% 是本次价格与缓存成本测算下的临界值,不是所有模型通用的结论。
这四个时刻之间是读文件、跑命令的工具循环,路由器一次都不问Jev,一直沿用之前的模型。子agent的基准测试里,522次工具续跑都没有调用Jev。
为什么不让 Codex 自己做
这里大家肯定会问:你都在用 Codex 了,为什么不让 Codex 自己写这个路由器?
因为 Codex 是被路由的那一方。这个路由器要做的事,是在 Codex 外面替它决定用哪个模型。让 Codex 在自己的 app 里改自己的路由,等于让被测试方自己出题自己判卷,在 Codex app 里也做不到。它必须是一个外部调用。所以我需要另一个编码 agent,把这个项目从零做出来。
那为什么是豆包工作?说实话没什么特别的理由,正好这段时间刷到它可以免费领 30 天权益,试一下不花钱。再一看,它刚出了两个新的任务模式:计划模式和目标模式。一个是先出方案、我批准了才动手;一个是我写验收标准、它自己核对、自己返工。这两件事正好是我做这个项目时最在意的:我不想盯着它,但我要能在事前和事后各卡一道。
坦白说,我一开始并不相信它能做。我平时不怎么用豆包工作这类 app,对它写代码的水平心里没底,只是抱着将信将疑的态度试一下,不行就算了。
不过有一点让我敢把活交给它:这个路由器的决策核心我之前已经验证过了,跑了三天、192 个真实 Codex 会话,有数据、有测试可以对照。它写出来对不对,我一眼就能看出来,不至于被糊弄。当时验证的结果,分组看是这样:
| 分组 | 全顶配 | 真路由 | 差 |
| --- | --- | --- | --- |
| 机械任务 | $5.79 | $0.27 | **省 95.4%** |
| 推理任务 | $5.82 | $6.15 | 多 5.6% |
| 全部 | $11.62 | $6.42 | **省 44.8%** |
另外两组单独的实验:子 agent 委托 $13.85 → $2.81,省 79.7%;151k 长上下文场景,整体从 $5.90 降到 $0.16,省 97%。
两边的通过率都是 100%,结果没有差别。也就是说,钱省了,活没少干。但有两条要说清楚。一是推理任务这一档没有收益,样本只有 6 次,方向和量都不确定。二是代价是慢一点:便宜档步数更多,机械任务的耗时中位数从 50 秒涨到 62 秒。钱省九成,时间多两成,这个取舍我认。
决策核心验证没问题,剩下的就是把它做成一个完整的项目:路由、价格表、审计日志、测试,全套。这是一个真实需求,不是为了测评编出来的题目。我把需求给豆包工作,让它从零做。
结果出乎我意料。全程我只操作了四次,它自己干了两个多小时,最后 76 个测试全通过,中间还自己揪出了 3 个 bug——这 3 个 bug,在我自己验证决策核心的那三天里也没暴露出来。 这 76 个是单元测试,和前面那 192 个真实会话不是一回事:前者验代码,后者验思路。
这个项目是怎么做出来的
我给这个Jev模型搭配Codex的项目叫 HippoRoute-Jev-Codex,它站在 Codex 外面,在前面说的四个线程边界上把上下文交给 Jev 判断一次:走便宜档还是顶配。判断完就钉住,工具循环内绝不换模型,避免打断 prompt 缓存。围着这个决策核心,还要有一套配套的东西:查价格表算划不划算的逻辑、记录每次决策的审计日志、以及能证明这些行为都对的测试。全部只用标准库,测试全部 mock,不联网。
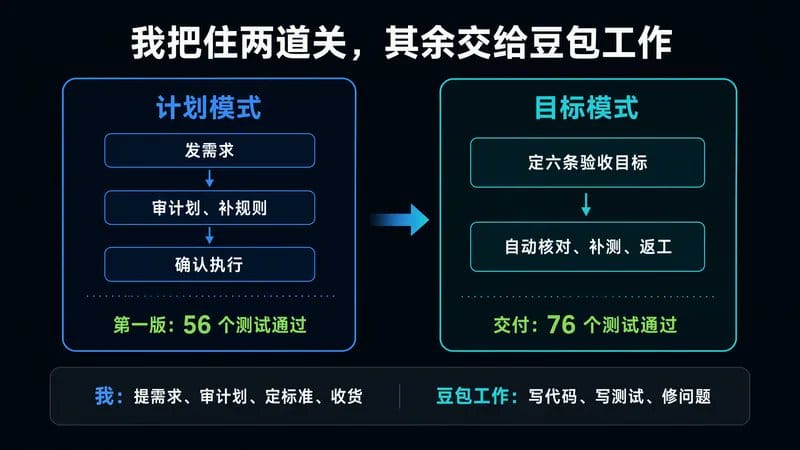
我前面已经手工验证过决策核心是对的,所以这次的目标不是再验证一次思路,而是让豆包工作把它从零做成一个完整的项目。整个过程我分成了两步,正好对应它的两个任务模式。
**第一步,用计划模式出方案、写第一版。**我把需求发给它,它先不写代码,交一份计划让我审。我确认没问题,它再动手把所有模块和测试写出来。这一步结束时是 56 个测试全绿。
**第二步,用目标模式做验收。**第一版的测试是它自己写的,全过只能说明代码符合它自己的理解,我需要用一套更高的、我定的标准再压一遍。我写了六条验收目标交给它,让它自己核对、自己返工,全部达标才算交付。这一步结束时是 76 个测试全绿,中间揪出了 3 个 bug。
它翻译文档的时候我没有干等,把统计代码行数、生成 CHANGELOG、写推文文案这三件事丢进了任务队列,让它排着队自己做。
两步加起来,我说的一共操作了四次,具体是这四次:
- 把需求发给它
- 审计划、补两条规则、点确认
- 把六条验收目标发给它
- 收货
中间它自己干了两个多小时,我没看过一行代码。下面按顺序说每一步具体是怎么用的。
计划模式:批准之前,它一个文件都不碰
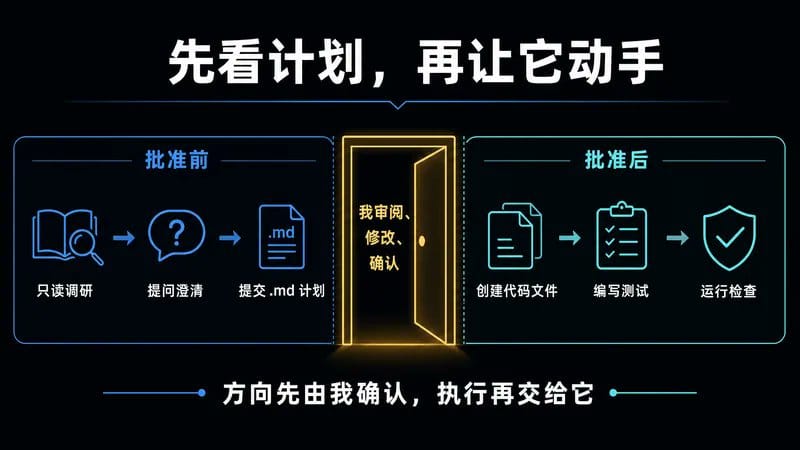
先说计划模式是干什么的。
你给它一个复杂任务,它不直接开工,先只读调研,拿不准的地方反问你,然后交一份 .md 实施计划:任务怎么拆、分几步、按什么标准验证。你批准之前,它一个文件都不碰。计划可以直接批准、逐条改,也可以让它重新生成,点「开始执行」它才动手。
用法是在输入框打 /plan,选「计划」,把任务描述发出去就行。
我这次是这么用的。计划模式的流程就三步:我给需求,它交计划,我批准它才动手。按这个顺序说。
我发给它的需求
打了 /plan 之后,我贴进去的原文如下:
在 ~/Desktop/hippo-doubao 从零实现一个 Codex 模型路由器的决策核心,纯 Python,只用标准库,不装任何第三方包。 背景:Codex 每个请求都重新选模型会打掉 prompt 缓存,反而更贵。这个路由器只在线程边界选一次模型,然后钉住。 需要实现的核心行为: 1. 只在四个时机问外部选模型服务:线程首请求、新用户轮次、压缩检查点、子 agent 首请求 2. 工具循环里的续跑一律沿用已钉住的模型和 effort,不再询问 3. 换模型前过一道缓存成本闸门:切换成本减留守成本超过预算就不切 4. 线程身份识别优先级:thread-id,其次 client_metadata.thread_id,再次 x-codex-turn-metadata.thread_id,三者冲突时失败回退 5. 子 agent 首请求独立决策,按委托语义单独判断,并钉住整个生命周期 6. 任何失败都不能卡住:超时、网络错、没有 key、熔断打开,全部回退到 gpt-6-astra@medium 继续跑 7. 三种运行状态用哨兵文件切换:live 应用决策、shadow 只记录不应用、off 完全跳过 8. 每条决策可审计:记录原始选择和置信度、真实上游模型、完整 token 用量、决策原因 范围边界,这次只做决策核心: 做:线程状态存储、身份识别、决策引擎、成本闸门、配置加载、决策日志 不做:HTTP 服务器、SSE 流式转发、benchmark 脚本、launchd 安装脚本 外部选模型服务用一个可注入的接口表示,测试里用 mock 替换,不访问网络。 测试要求:用标准库 unittest。 请先调研和规划,产出实施计划。
八条核心行为就是前面几节讲过的东西,写成它能照着做的规格。**「外部选模型服务」就是 Jev,**只是在需求里把它抽象成一个接口,测试时好用 mock 替掉。
它交回来的计划
它在对话里回了这样一份摘要(完整的 .md 计划更长,在「任务规划」面板里能点开看):
计划已提交,核心要点: 模块划分(9 个 + 测试目录) - identity.py:三级优先级取 thread-id,冲突→匿名桶 - state.py:pin 表,线程安全 + atomic JSON 落盘 + TTL - selector.py:抽象接口,测试用 StaticSelector - circuit_breaker.py:三态熔断 - cost_gate.py:切换成本 − 留守成本 ≤ 预算才切 - engine.py:四时机判定(first/new_turn/compaction/subagent_first)+ 续跑 reuse - config.py:哨兵文件切 live/shadow/off,运行时热切换 - audit.py:JSONL append + 事后回填 token 用量 - fallback.py:gpt-6-astra@medium 兜底 几个关键设计选择(如果你有不同意见请指出): - fallback 不 pin——临时降级不污染线程钉住状态,下一个请求仍走正常判定 - 超时用 ThreadPoolExecutor.result\(timeout=\) 实现,纯 stdlib 跨平台 - 新轮次近似用 messages\[-1\].role \\=\\= “user” 判定,调用方也可在 RequestContext 显式传 is_new_turn 覆盖 - off 模式返回 applied=False,让上游走它自己的默认(等于完全不干预) - token 用量通过 record_usage\(audit_id, usage\) 事后回填(决策时拿不到) 等你确认或调整,确认后我开始写代码。
九个模块和我需求里的八条行为一一对得上。那五个设计选择我能当场拍板,因为手写版我做过:1、3、4、5 和我的做法一致,第 2 条比我那版重一点但更严格。这点我给它点赞!
批准前我特意查了 git status,目录还是空的,确认它真的没动手。我补了两条规则,它当场改好计划。点了确认,我就没再管它。
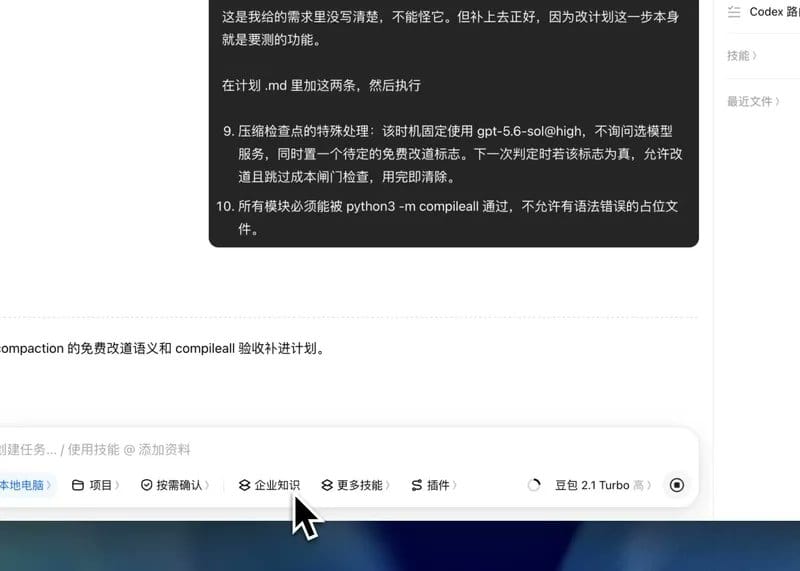
确认之后它就直接在我电脑上 ~/Desktop/hippo-doubao 那个目录里动手了:按计划里的顺序一个模块一个模块写,每写完一个就接着写这个模块的测试。我没有复制粘贴过任何代码,文件都是它自己建的。
它自己干了1个多小时,所有文件,代码写完后反复改好,自己做了56个测试,直到完全通过。
目标模式:测试全过,不等于没有错
到这里我有一个疑问。计划模式那版通过了 56 个测试,但测试是它自己写的,只能证明代码和它自己的理解一致,证明不了这个理解是对的。那我把验收标准定高,它能不能自己把漏掉的问题找出来?
目标模式就是干这个的。你把验收目标一条条写清楚,它做完逐项核对,全部达标才交付;有一条不达标,它自己返工,直到过为止。输入框上方一直挂着「进行中的目标」,做到哪一步一眼能看到。
用法是打 /goal,选「目标」,先写验收目标,再写任务。
我发给它的目标
打了 /goal 之后贴的原文,前半段任务描述和计划模式那份几乎一样(目录换了个新的,核心行为从八条变成九条),不重复贴了,只贴后半段的验收目标:
验收目标,每一条都必须达成: 一、执行 python3 -m unittest discover -s tests 全部通过,测试用例不少于 70 个 二、执行 python3 -m compileall 退出码为 0 三、代码里不能出现任何第三方 import,只能用标准库 四、上面 9 条核心行为,每一条都要有至少一个专门的测试,并在 README 里列出行为与测试文件的对应表 五、所有测试用 mock,不访问网络,不需要真实 API key 就能跑通 六、审计日志每条记录必须包含全部字段,且有测试断言字段完整性 做完后执行 python3 -m unittest discover -s tests,把原始输出贴给我。
它中间做了什么
指令写的是「从零实现」,但它开工不到 3 分钟就自己拿了主意:把计划模式那版代码复制到新目录,对着六条验收目标往下补。
中间经过了两轮返工:
第一轮核对发现测试只有 56 个,不够 70,补了 20 个;
第二轮新补的一跑,4 个没通过,它自己查原因、改好、重跑。
它最后返回的
完成。全部六条验收达成: 一、python3 -m unittest discover -s tests:76 tests, OK(≥70) 二、python3 -m compileall:退出码 0 三、第三方 import:无,全部标准库 四、9 条行为各有专门测试 + README 对应表:已加 五、全 mock,无网络、无真实 API key:通过 六、审计字段完整性断言:test_audit_record_full_fields_after_selector_call 等
后面跟着 76 行 unittest 原始输出,最后一行是 Ran 76 tests in 0.406s OK。
规划、执行、验收三次任务的额度加起来,不到 7 天额度的 0.6%。
比数字更要紧的是它自己找出来、自己改掉的那 4 个问题:
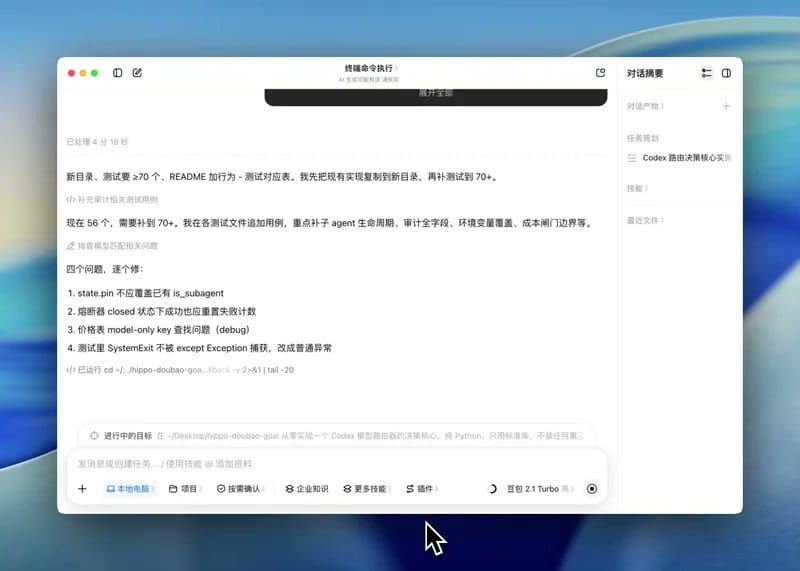
前 3 个是代码写错了,第 4 个是测试写错了——原来 56 个全过的测试没照到这 3 个错,是我要求补到 70 个之后,新测试覆盖到了没测过的路径才照出来的。
回到开头那个疑问:标准定高了,它能不能自己把漏的找出来?能。测试全过不等于没错,区别只在验收目标写没写清楚——你把标准定在哪,它就能做到哪。
顺手用到的三个小功能
**任务队列。**它正在跑任务的时候,你可以接着往对话框里发指令,发送时选「排队」,当前任务一完成,它自动按顺序往下执行;想插队就点队列里那一条立即发送。我在它翻译文档的时候追加了三条:统计代码行数、生成 CHANGELOG、写推文文案。翻译完成后,三条排队的指令自动一条接一条执行了,每条的产出都出来了。
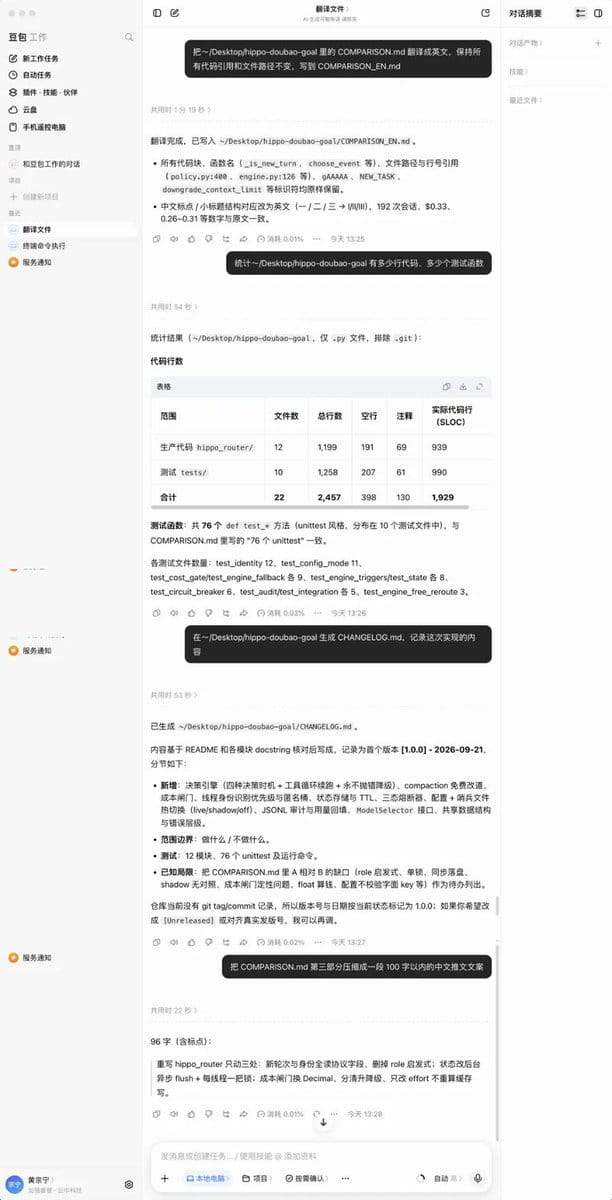
**md 在线编辑。**它产出的 markdown 在对话里能直接看、直接改、直接分享,改完预览同步。
**深色模式。**设置里切成深色,晚上盯屏幕舒服一些。
最后
回到最开始的问题:账单。
机械任务省了 95.4%,
子 agent 分档省了近 80% 的 tokens,
全任务集算下来省 44.8%,推理任务暂时没收益。
这个结果我满意。
而把这个路由器从一份需求做成一个能跑、有测试、经过验收的完整项目,是豆包工作从计划到执行、测试、验收全程做完的。
最后接入 Codex,模型菜单里已经能选中我们自己的 Jev Codex Router,不再只是一个跑测试的项目。
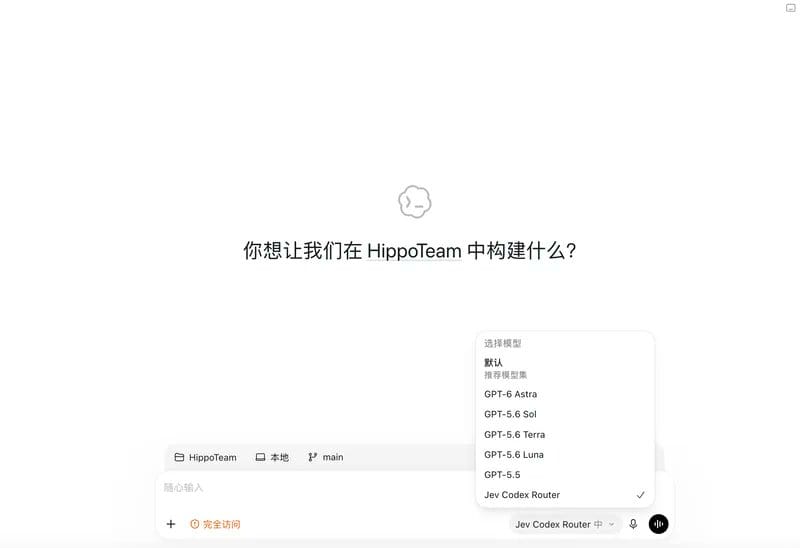
项目地址:https://github.com/huangserva/hipporoute-jev-codex
顺带提一嘴:豆包工作目前可免费领 30 天权益,8 月底已领取的用户,可多领一个月。
白拿的,干嘛不赶紧冲? https://doubao.com/work