本文作者:Berryxia.AI(@berryxia)。版权归作者所有,未经授权禁止转载。
AGENT INFLECTION POINT
一个参与造出“最会说话的 AI”的人,隐身两年,做了个“不会说话的 AI”。
01
一个"反ChatGPT"的模型,为什么刷屏了?
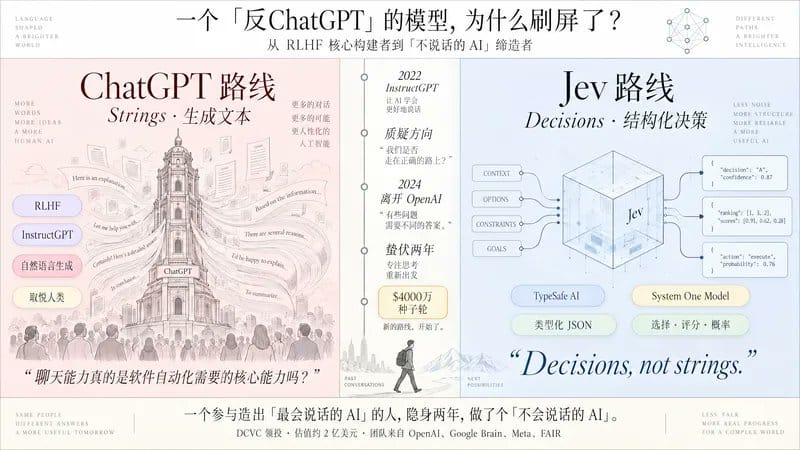
9月15日,硅谷AI圈被一个叫Jev的新模型刷屏了。
创始人Diogo Almeida在X上发了一条帖子,两天数百万次浏览,近2万点赞。Hacker News首页挂了一整天。
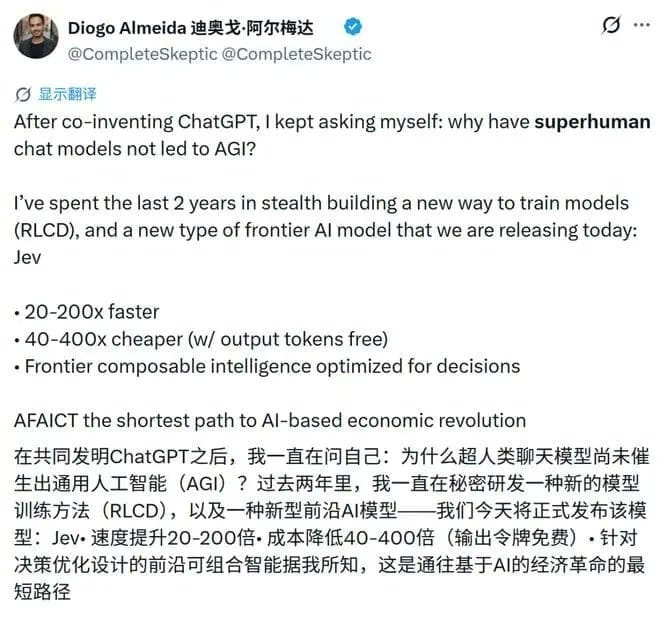
要理解这件事的分量,得先认识Almeida这个人。
他的履历放在AI圈算得上"嫡系中的嫡系"。在加入OpenAI之前,他已有顶级AI实验室的研究背景。后来转到OpenAI,深度参与了2022年InstructGPT的研究——这篇论文后来被广泛认为是ChatGPT的技术基石。
InstructGPT做了一件什么事?它把监督微调、人类偏好数据和RLHF(基于人类反馈的强化学习)结合在一起,让GPT-3从"能生成文本"变成"能听懂人话并按人的意图回答问题"。后来ChatGPT沿用的就是这条RLHF路线。GPT-4的贡献名单里,OpenAI把他列入了"Foundational RLHF and InstructGPT work"——基础性贡献。
说直白点,今天所有人用ChatGPT、DeepSeek能跟AI自然对话,背后靠的训练方法,他是核心构建者之一。
但Almeida在OpenAI内部,是少数公开不认同ChatGPT方向的人。
他的质疑不是觉得模型不够强,而是觉得方向偏了。"大模型现在非常擅长聊天,但聊天能力真的是软件自动化需要的核心能力吗?"这个问题,他思考了四年。
他对RLHF的反思尤其尖锐。RLHF让模型学会了取悦人类,但在他看来,这恰恰是问题所在。
据他公开发表的观点,RLHF训练出来的模型天然会在"人类偏好"和"实际结果"之间留下巨大差距,那就是模型过度承诺,而且这种过度承诺是设计层面的问题。换句话说,无论模型错得多离谱,它们看起来都会是对的。
这话从别人嘴里说出来是一回事。从RLHF论文作者嘴里说出来,完全是另一回事。
2024年,Almeida离开OpenAI。拉了两个联合创始人,连续创业者Erik Gafni、前Meta/FAIR研究工程师Sasha Sheng,在旧金山创办了TypeSafe AI。
蛰伏两年,拿到4000万美元种子轮,DCVC领投,估值约2亿美元。团队核心成员来自OpenAI、Google Brain、Meta和FAIR。
两年隐身之后,他拿出来的东西,跟ChatGPT走的是完全相反的路。
Jev不会聊天,不会写代码,不会生成任何自然语言。你给它一段信息,再给它几个预设问题,它直接返回结构化的选择、评分和概率。官方slogan只有一句话:
Decisions, not strings. 要决策,不要字符串
一个参与造出了"最会说话的AI"的人,隐身两年,做了个"不会说话的AI"。
这个叙事本身就足够有戏剧张力。但真正让整个圈子震动的,不是故事,是数字。
02
三组数字,砸烂了大模型的成本结构
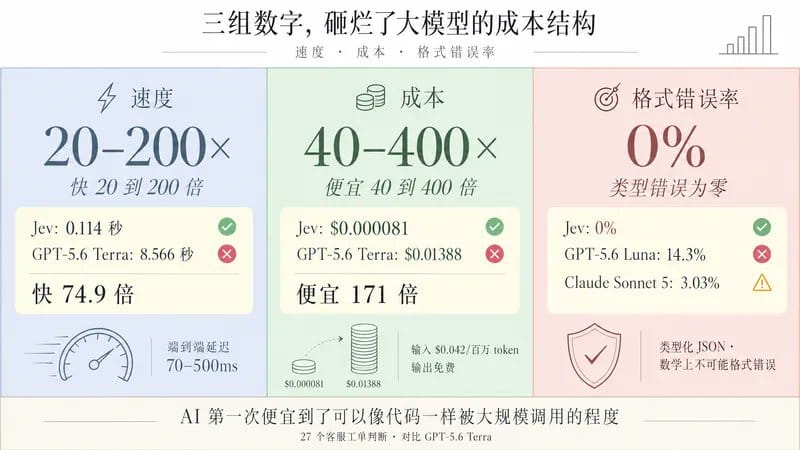
先看一组官方公布的对比数据,可能会颠覆你对AI成本的直觉。
SPEED · 快20到200倍
端到端延迟70到500毫秒。同样回答27个客服工单判断问题,Jev用了0.114秒,GPT-5.6 Terra用了8.566秒——快了74.9倍。
COST · 便宜40到400倍
输入token每百万0.042美元,输出token干脆免费。同样27个问题,Jev花了0.000081美元,GPT-5.6 Terra花了0.01388美元——便宜了171倍。
FORMAT ERROR RATE · 格式错误率:0%
输出结构是提前定义好的类型化JSON,数学上不可能输出格式错误的答案。工具调用错误率,Jev是0%,GPT-5.6 Luna是14.3%,Claude Sonnet 5是3.03%。
注意,这里说的是"类型错误"为零,不是"判断错误"为零。它也会判断错,但不会给你返回一段需要程序再解析的废话,也不会瞎编一个不在选项里的答案。
这三个数字放在一起,意味着什么?
意味着AI第一次便宜到了可以像代码一样被大规模调用的程度。
以前调用一次大模型,几分钱到几毛钱,你得省着用。现在在特定任务中调用一次Jev,成本不到万分之一美分,便宜到可以在一个请求里并行问几十个问题,输出还不收费。
03
真正的革命:从“串行生成”到“并行判断”
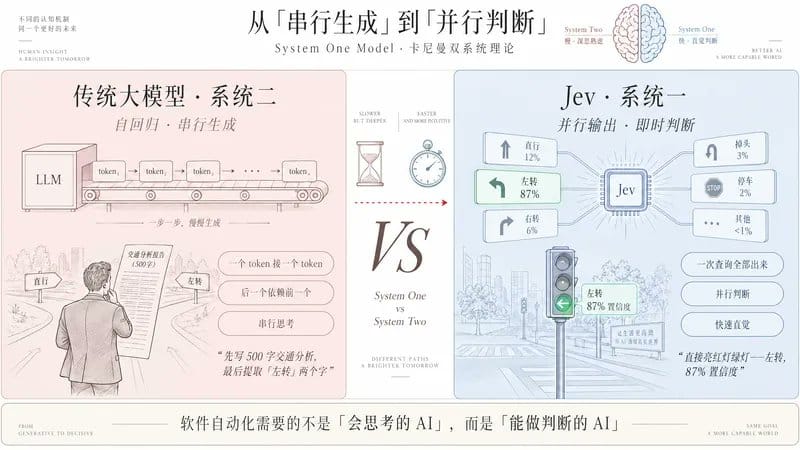
速度和成本只是表象。Jev真正不一样的地方,在架构上。
传统大语言模型是自回归的,一个token一个token往外蹦,后一个依赖前一个。你问它一个问题,它得先想第一个词是什么,再想第二个词,一步步生成完。
Jev不是,它是并行输出的。一次查询,所有问题的答案同时出来。
打个比方。你开车到一个路口,想知道该往哪走。
传统大模型的做法是:先给你写一篇500字的交通分析,从城市规划讲到高峰期车流,最后你从里面提取出"左转"两个字。
Jev的做法是:直接亮红灯绿灯——左转,87%置信度。
这听起来好像只是个"输出格式"的区别,但背后是完全不同的训练目标和模型架构。
Almeida给它起了个名字叫System One Model(系统一模型),借用了卡尼曼的双系统理论,系统一是快速、直觉、并行的判断,系统二是缓慢、推理、串行的思考。
过去几年,整个行业都在往系统二的方向狂奔,模型越来越大,推理越来越深,越来越像一个"全能的思考者"。
Jev说:等等,软件自动化需要的根本不是"会思考的AI",而是"能做判断的AI"。这俩不是一回事。
04
为什么偏偏现在火:Agent的"最后一公里"被打通了?
Jev如果在2023年发布,可能不会有今天的热度。
那时候大家还在问:大模型能写什么?能聊什么?能生成什么?
到了2026年,行业的焦点变了。现在的问题是:Agent为什么还是慢、贵、脆?
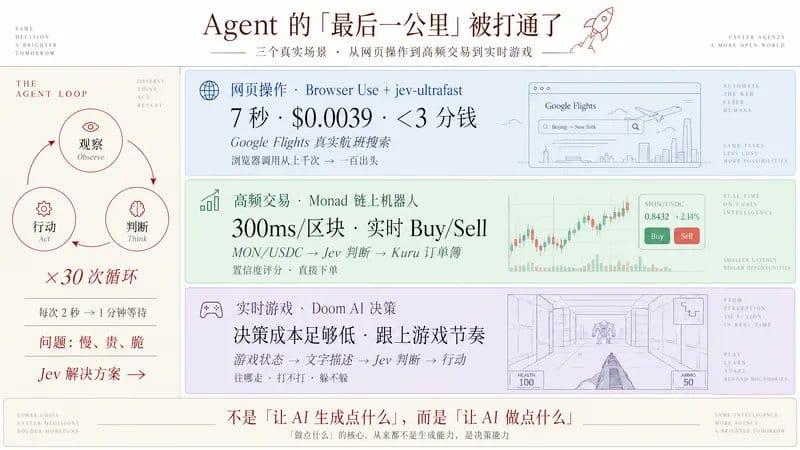
答案其实很简单。Agent不是一次调用模型,而是一串循环:
观察 → 判断 → 行动 → 再观察 → 再判断 → 再行动
一次调用慢2秒,在聊天里问题不大。但如果一个Agent要循环三十次,用户就要等一分钟。
一次调用贵几分钱,在偶尔用一次的Copilot里无所谓。但如果一个系统每天要做数百万次路由、过滤、评分、验证、重试和工具选择,这就变成了基础设施成本。
Jev刚好卡在了这个位置上。
发布当天,Browser Use团队就用Jev做了一个叫jev-ultrafast的开源项目,演示了在Google Flights上完成一次真实航班搜索,总耗时7秒,成本0.0039美元,不到3分钱人民币。
据项目演示,浏览器协议调用次数从上千次降到了一百出头。这是日常的网页操作场景。
第二天,Monad的工程师用Jev做了一个链上交易机器人,实时读取MON/USDC价格,Jev判断Buy还是Sell,给出置信度,直接下单到Kuru订单簿。每300毫秒一个区块,刚好跟上节奏。这是高频金融交易场景,对延迟极度敏感。
还有人用它玩Doom,不是跑Doom,是把游戏状态整理成文字描述喂给它,让AI判断往哪走、打不打、躲不躲。因为决策成本足够低,它能跟上游戏节奏。这是对延迟要求最极端的实时场景。
从日常网页操作到高频金融交易再到实时游戏,Jev都能跟上节奏。
这几个demo放在一起,你会发现一个共同点:它们都不是"让AI生成点什么",而是"让AI做点什么"。
而"做点什么"的核心,从来都不是生成能力,是决策能力。
05
哪些行业会最先被Jev这类模型改造?
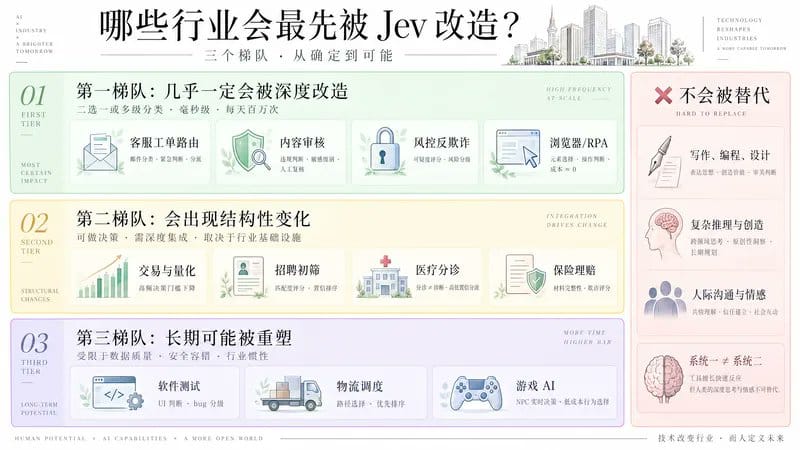
Jev不是来替代ChatGPT的。它的战场,是所有"高频重复决策"的岗位和流程。我按确定性从高到低排了三档。
第一梯队:几乎一定会被深度改造
这些场景的共同特征是:决策本身就是二选一或多级分类,延迟要求毫秒级,每天百万次调用。刚好是Jev的甜区。
- 客服工单路由:邮件分类、紧急程度判断、分派部门:每天百万级量,完美匹配。
- 内容审核:违规判断、敏感级别、是否需要人工复核:大规模并行,低延迟。
- 风控与反欺诈:交易可疑度评分、账户风险分级:毫秒级决策,可设置信度阈值。
- 浏览器/RPA自动化:网页元素选择、下一步操作判断:Agent循环里最频繁的"小决策",成本压到几乎为零。
第二梯队:会出现结构性变化
这些场景的共同点是:决策本身可以做,但需要跟现有系统深度集成,落地节奏取决于行业基础设施。
- 交易与量化:不是替代量化研究员,而是让"高频决策型交易"门槛大幅下降,用自然语言定义选项就行。
- 招聘初筛:简历匹配度评分、候选人分级:不需要AI写面试评语,只需要带置信度的排序。
- 医疗分诊:症状初步分级、科室推荐:注意是"分诊"不是"诊断",高置信度自动处理,低置信度转人工。
- 保险理赔初审:材料完整性判断、理赔类型分类、欺诈风险评分。
第三梯队:长期可能被重塑
这些场景目前受限于数据质量、安全容错或行业惯性,但方向已经清晰。
- 软件测试:自动判断UI元素是否正确、bug严重程度分级。
- 物流与调度:路径选择、优先级排序、异常情况快速处置。
- 游戏AI:NPC的实时决策不再需要脚本树,直接用Jev做低成本行为选择。
那什么不会被Jev替代?
需要生成内容的(写作、编程、设计),需要复杂推理和创造性思维的(它是系统一不是系统二),需要人际沟通和情感连接的(它连话都不会说)。
06
一个更大的判断:AI 栈正在分裂
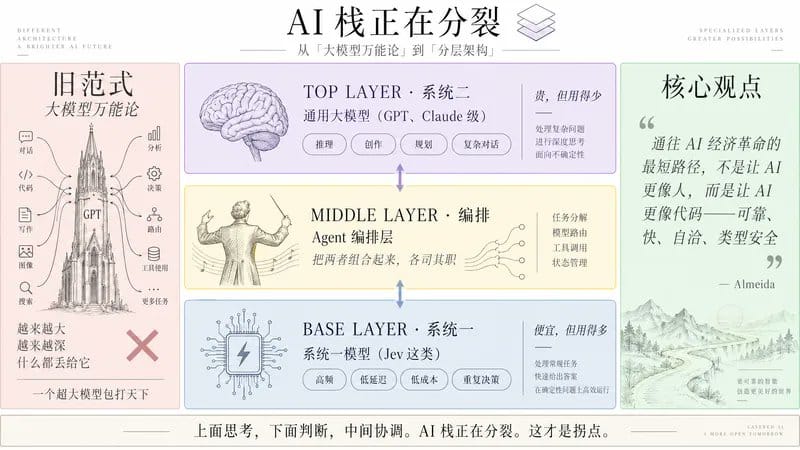
Jev最值得关注的,不是"又出了一个更快更便宜的AI",而是它在挑战整个行业默认的"大模型万能论"。
过去几年的共识是:把模型做更大、让它更会说话、什么任务都用同一个通用模型搞定。
OpenAI的路线就是这套逻辑的集大成者,GPT系列一路做大,推理越来越深,然后所有任务都丢给它。
Jev说的是:不对。
软件自动化需要的根本不是"会说话的AI",而是"能做判断的AI"。这两者的训练目标、架构、成本结构完全不同。
如果这个判断是对的,未来的AI栈很可能不是"一个超大模型包打天下",更像是一个分层架构:
TOP LAYER · 系统二 — 通用大模型(GPT、Claude 级),推理、创作、规划、复杂对话。贵,但用得少。
MIDDLE LAYER · 编排 — Agent 编排层,把两者组合起来,各司其职。
BASE LAYER · 系统一 — 系统一模型(Jev 这类),高频、低延迟、低成本的重复决策。便宜,但用得多。
Almeida在不同场合表达过一个核心观点:通往AI经济革命的最短路径,不是让AI更像人,而是让AI更像代码,可靠、快、自洽、类型安全。
Jev可能不是最终答案。但它第一次让底层那层有了自己的模型。
未来的AI不会是一个会说话的巨无霸,而是一套分层系统:上面思考,下面判断,中间协调。
ChatGPT打开了"AI能跟人对话"的潘多拉盒子,但对话只是开始。真正的AI经济,要建立在AI能替人做判断、替人执行的基础上。
AI栈正在分裂。这才是拐点。
Decisions, not strings.