本文作者:sitin(@sitinme)。版权归作者所有,未经授权禁止转载。
前段时间,我想给一项线上服务加个监控。
我主要是想解决两件事。服务整体不可用了,我没有及时看到。某项外部依赖出了问题,任务还在继续提交,等到用户反馈才发现。
最直接的做法是在服务器里加一套监控程序。我没有这样做。我先定了几条边界,不能改生产服务器,不能重启服务,也不能调用会改变业务统计的检查接口。
剩下的路很清楚。监控得放在服务器外面。
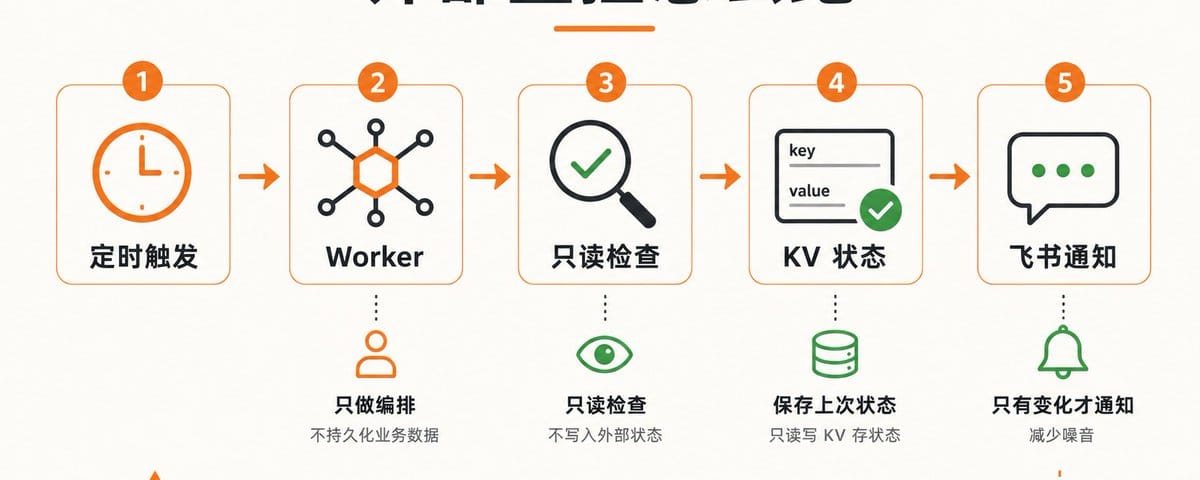
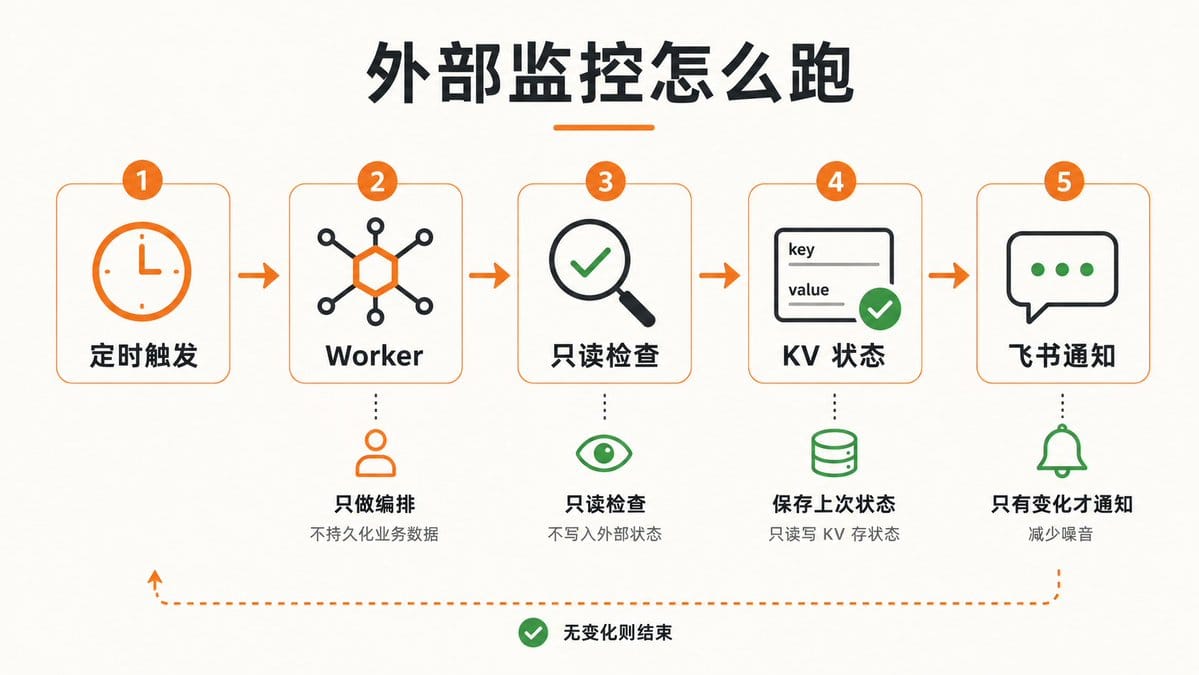
最后我的解决的方案是 Cloudflare Worker。它每分钟醒来一次,读取两份经过脱敏的健康信息,和上一轮状态比较。发现新的故障就发一张飞书卡片,故障一直存在时保持安静,恢复后再发一条恢复通知。
我的电脑关掉以后,它照常运行。
01 为什么要把监控放在外面
监控程序装进业务服务器,开发起来通常更顺手。代码、数据库和日志都在旁边,想看什么都方便。
问题也在这里。服务器真的失去响应时,里面的监控可能跟着消失。监控和被监控对象共用一套环境,出了问题还得先判断是谁拖累了谁。
这项服务已经有只读健康接口,可以返回数据库和任务队列是否正常。另一份只读信息用来判断外部依赖还能不能工作。动手前,我先核对了接口行为,确认读取不会改变状态,才把它们接进监控。
系统里还有一种主动检查,会更新成功失败次数,甚至改变资源状态。这类接口更适合人工诊断,不适合每分钟调用。监控如果一边观察,一边改写被观察对象,后面看到的数字就很难再信。
把巡检放到 Cloudflare 以后,原来的服务没有新增常驻进程,也没有多开端口。Worker 只是从外面读取现成信号。
02 一个 Worker 怎样拼出完整监控
这套东西用到的 Cloudflare 能力并不多。
Cron Triggers 负责定时叫醒 Worker。配置里写的是每分钟一次,触发后进入 scheduled() 处理函数。
Worker 收到定时事件以后,用 fetch 读取健康信息。请求设置了超时,返回内容也会检查格式和大小,避免一份异常响应把巡检拖住。
KV 用来保存上一次看见的状态。Worker 每次启动都可能落在不同的运行实例里,不能指望内存还留着一分钟前的东西。上一次是否健康、连续失败了几次、哪些通知还没送达,都要放到外部存储。
访问凭证和飞书 Webhook 放在 Workers Secrets 里。源码和配置文件只出现变量名,看不到真实内容。
最后还有 Workers Logs。Cron 有没有按时执行,请求在哪一步失败,飞书是否拒绝了消息,都能回到 Cloudflare 控制台里查。本地终端不用一直挂着。
这些东西放在一起,才有了一个能长期工作的巡检程序。
03 发现错误很容易,决定何时提醒更难
第一版规则听起来很简单。只要发现异常,就给飞书发消息。
真这么做,一分钟一次的巡检会很快把群聊淹没。一个故障持续半小时,群里可能出现三十张一模一样的卡片。
我后来把提醒分成了几种情况。
某项业务资源刚刚失效,立即提醒。它继续处于故障状态,后面的巡检不再重复发送。它恢复正常,再单独发一条恢复通知。
人工暂停的资源不会触发告警。维护动作和意外故障需要分开,否则每次正常操作都会把人叫回来检查一遍。
服务器或健康接口偶尔超时,也不能马上判定故障。现在的规则会连续失败三次再提醒。恢复同样要连续成功两次,防止服务在好坏之间抖动时反复发消息。
做到这一步,监控才开始像一个人值班。它知道什么情况要开口,也知道什么时候应该安静。
04 上线以后,我还是遇到了重复告警
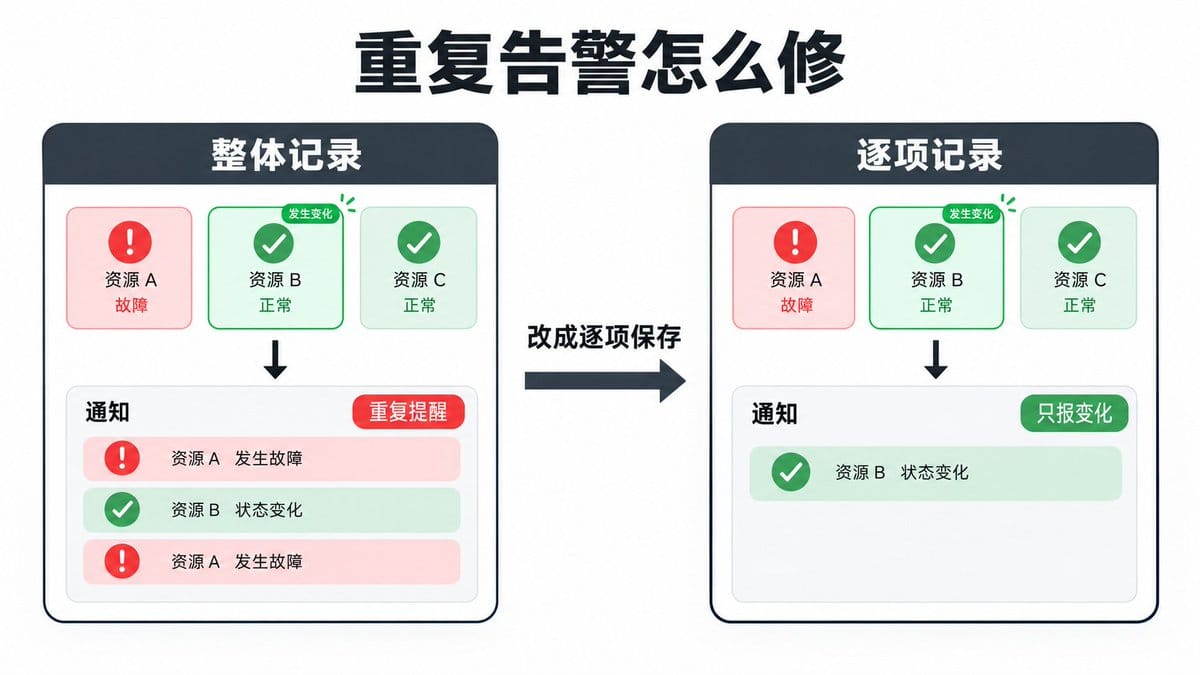
后来我添加了一项正常资源,飞书却把原来已经提醒过的故障又发了一遍。
问题出在第一版的状态记录方法。它把全部资源合成一份总状态。资源列表一变化,整个结果都会变。程序看见变化以后,无法准确分辨谁刚刚出错,只好把旧故障一起带进通知。
后来,状态记录改成了逐项保存,每项资源单独处理。
本轮故障列表里新出现的项目,归到新增故障。上一轮有、本轮消失的项目,归到已经恢复。新加入的正常资源只会进入基线,不会惊动以前的故障。
改完以后,飞书卡片里只出现本轮发生变化的项目。
这个小问题给我的印象很深。很多监控脚本都能判断当前有没有错,麻烦的是它能不能讲清楚刚才发生了什么。前者只需要条件判断,后者需要认真保存状态。
05 电脑关机,Worker 照常巡检
这套监控从一开始就部署在 Cloudflare Workers 上。Mac 只负责写代码和部署,Wrangler 用完就退出。真正的巡检一直由 Cloudflare 执行,没有在本机挂一个进程凑合着跑。
Cron Triggers 每分钟触发一次任务。Mac 关机,本地终端退出,下一分钟的巡检还是会来。平时想看运行情况,我再去 Workers Logs 里查,不用让电脑一直开着等日志。
Cloudflare 常把 Workers 放在边缘计算的语境里介绍。这次任务对访问速度没有多少要求。我看重的是托管运行和外部位置。它不占业务服务器的资源,也不会随着我的电脑一起休息。
06 Workers 免费额度,完全够这项任务用
Cloudflare 目前给 Workers Free 提供每天 100,000 次请求额度。这个 Worker 每分钟运行一次,一天一共 1,440 次,只用了每日请求额度的 1.44%。
每轮任务也很轻。它读取两份很短的健康信息,从 KV 里拿出上一轮状态,比较完就结束。只有状态发生变化,才会再发一张飞书卡片。在我现在的运行规模下,Workers 的免费请求额度完全够用,也没有带来一笔能单独看出来的新增支出。
KV 的读取、写入和列表有自己的每日额度,不能跟 Worker 请求混成一笔账。我会在控制台里分开看它们的实际用量。这里能确定的是,每分钟一次的 Worker 调用离免费额度还很远。
07 KV 去重仍然有边界
目前这套监控用 KV 保存状态,规模小,写入也不频繁,做起来很轻。
Cloudflare 的文档写得很明确。KV 采用最终一致模型。一处位置写入的新值,在其他位置可能过一段时间才能看到,常见传播窗口可以达到六十秒或更久。
当前方案能大幅减少重复提醒,却无法承诺任何情况下都只发送一次。两个很接近的执行如果读到旧状态,仍然可能处理同一项变化。
对一分钟一次的小型巡检,我可以接受这个边界。通知数量不大,偶发重复的后果也有限。
如果以后用它处理扣款、库存或必须严格串行的动作,我不会继续依赖 KV 去协调。Cloudflare 的 Durable Objects 提供强一致状态,更适合这类工作。通知过程需要更可靠的缓冲和自动重试时,还可以把消息交给 Queues,消费端再用幂等键挡住重复处理。
现在,我基本感觉不到它的存在
这套监控跑起来以后,我很少再打开 Cloudflare 控制台。大多数时候,飞书里也没有消息。它每分钟照常检查,真有变化时,卡片才会出现。
这正合我意。监控不用每天证明自己还活着,也不用把每次短暂超时都推到我面前。平时安静,出事时能找到我,就够了。
以前碰到这种小任务,我会先想要不要在服务器里再放一个定时脚本。现在我愿意先看看 Workers。逻辑不长,需要一直在线,又能通过只读接口完成,放在这里很省事。
欢迎关注,这个账号还会持续分享更多AI编程、出海工具、实战经验、踩坑记录。
想了解更多可以加我 vx: 257735 聊。
新注册用户送 50 张 GPT Image 2 免费额度,不用绑卡,需要快速出图的可以试试:👉 https://www.hiapi.ai/invite/WF1y