本文作者:sitin(@sitinme)。版权归作者所有,未经授权禁止转载。
上周有人把一句话丢给我:帮我做一份 SEO 调研。
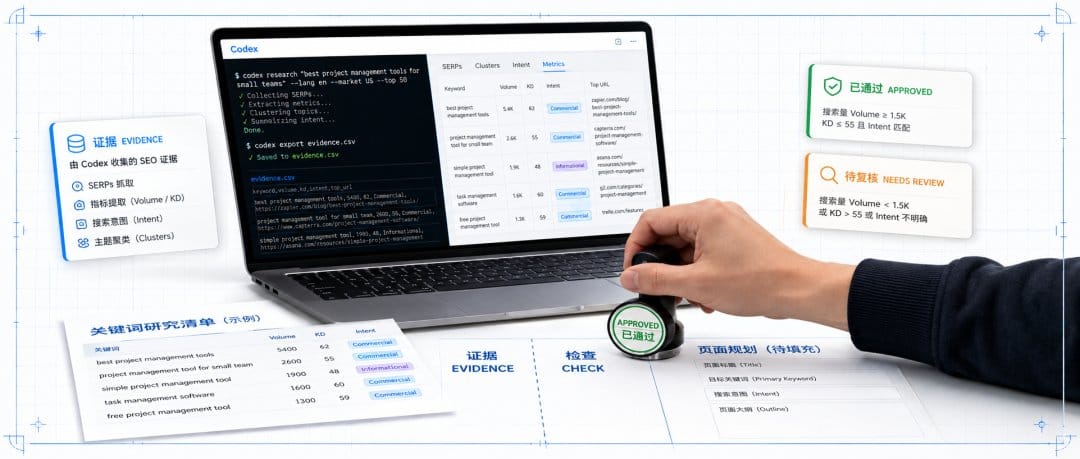
这种需求,Codex 很快就能接住,读文件、查资料、整理关键词、输出表格,几分钟后看起来什么都有:关键词、搜索量、难度、意图,甚至连推荐页面类型都写好了。
真正麻烦的是下一句:这批词到底是不是你的客户会搜?应该做产品页,还是写文章?两组相近的词要不要拆成两张页面?
这些问题,表格不会替你回答,SEO 调研里最容易被 AI 做得很像样、却最不能直接交给 AI 的,恰好就是最后的取舍。
所以我把这件事拆成四段:采集、整理、判断、规划。
Codex 适合承担前两段,可以给后两段出候选,但不能替你拍板。
先别让它开工,先让它写计划
SEO 调研的第一步,不是查关键词,是把业务边界交代清楚。
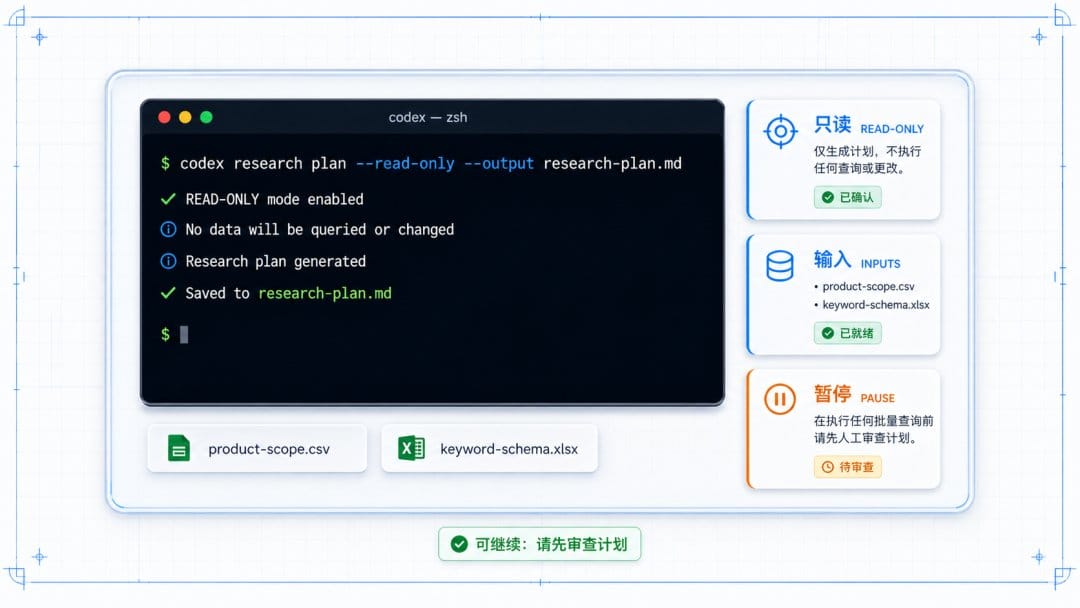
假设项目目录里有两个文件:
• product-scope.csv:产品范围、服务地区、客户类型、不能承接的需求
• keyword-schema.xlsx:你希望最终保留的字段
我会先让 Codex 只读这两个文件,只输出计划:
codex exec -s read-only -o research-plan.md "读取 product-scope.csv 和 keyword-schema.xlsx。先不要查询关键词。输出需要确认的业务问题、种子词来源、筛选规则、最终字段、验收方式,以及必须人工确认的步骤。"
这里的重点有三个。
-s read-only 把研究阶段锁在只读沙箱里。它可以读资料、写出计划文件,但不能顺手修改产品范围。
-o research-plan.md 把计划保存成中间产物。计划可以被人审一遍,也可以作为下一次执行的输入,不必从滚屏里捞结论。
先计划,后批量。 如果计划里出现了你根本不卖的产品线,或者漏了地区和客户类型,现在停下来还来得及。
这一步看起来慢,实际是在给后面的查询省返工。
关键词表最怕“看起来很完整”
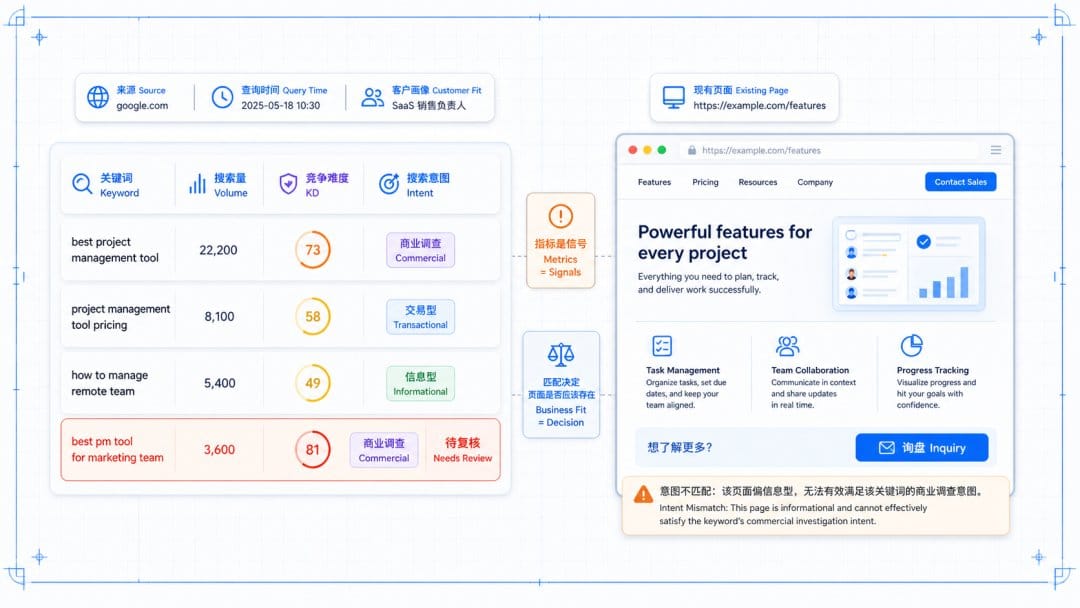
计划确认后,再让它分批处理,每一批都留下来源 URL、查询时间、原始字段和无法确认的值。
通常会把记录拆成两类:
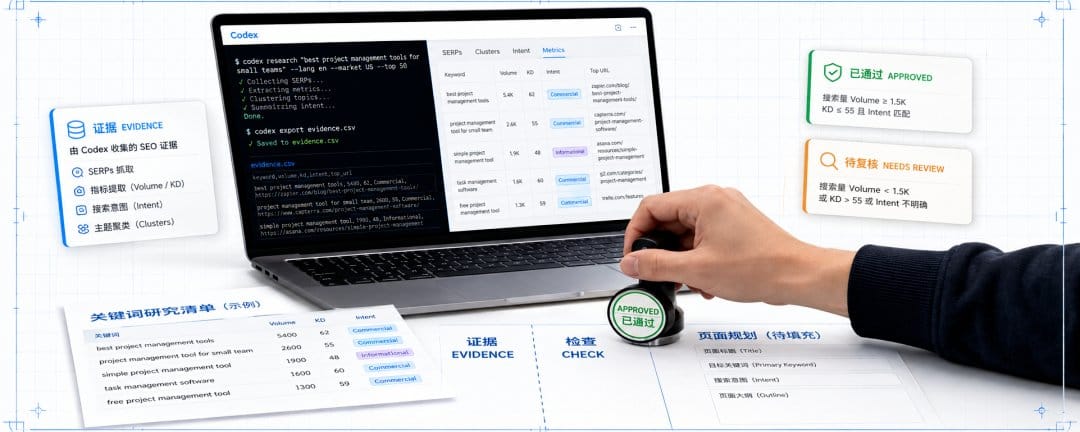
原始证据:关键词、来源 URL、查询时间、原始 Volume、原始 KD、原始 Intent。
工作判断:建议页面类型、Topic Cluster、人工备注、状态。
前一类必须能回到来源,后一类必须能解释理由,不要把两类揉成一列“结论”,否则月底复盘时只剩一张漂亮的表。
Semrush 这类工具里的 Volume、Keyword Difficulty、Intent 都有用,但它们表达的是不同信号:
• Volume 说明搜索需求的规模,不等于你的客户数量。
• KD 用来估计竞争难度,不等于新页面一定做不上去。
• Intent 是搜索目的分类,不等于页面已经知道该怎么承接访问者。
比如 industrial valve 可能是一个需求很大的词。只做某种规格、只服务几个地区的工厂,未必应该围绕这个泛词建页面。客户采购路径、交付范围和页面上的询盘动作,才决定它是不是一个好选题。
还有一个很容易漏掉的技术问题,网页表格被抓下来后,多列数字可能被拍平成一串值。列错位时,表格仍然整齐,错的却是每一行的含义。
我的做法是先拿页面外单独出现的一个值交叉核对列序,再接受整批数据。
核不上的行直接标记为 needs-review,不让模型用常识补空。
--json 解决交接,不解决判断
当 Codex 只输出自然语言,人能读懂,下一个程序却很难稳定接手。
需要把执行过程接进脚本时,可以用:
codex exec --json -s read-only -o research-result.md "检查 research/ 目录中的关键词记录,指出缺少来源 URL、查询时间或意图字段的行。"
--json 的价值在于把执行过程变成 JSONL 事件流。后续脚本可以按事件类型记录成功、失败和待复核项;-o 则保留最后的可读结果。
这和“让 AI 自动完成 SEO”是两回事。结构化输出只能让程序稳定接手,不能证明字段真实,也不能替你决定页面该不该上线。
权限也要单独设。研究阶段用只读,确实要改文件时再明确放开工作区范围。那个会跳过审批和沙箱的危险参数,不该出现在主力电脑的日常流程里。
聚类可以交给 AI,页面树别自动发布
关键词越查越多,下一步通常是聚类。
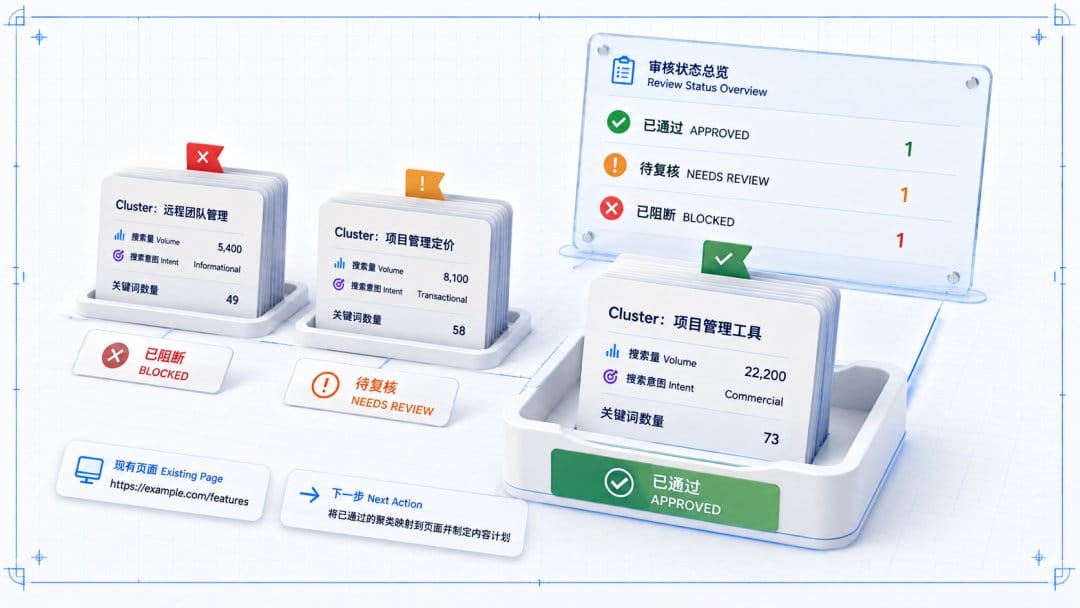
Codex 可以先按搜索意图和产品语境给出候选 Topic Cluster,并解释为什么把几组词放在一起。它也可以列出每个 Cluster 可能对应的页面类型。
但最后的页面规划,我会放在人工审核表里,至少检查这几件事:
客户会不会这样搜。 不是你觉得合理,而是目标客户真的会用。
现有产品能不能交付。 词再大,交付范围接不住,也不该为了流量建页面。
网站有没有现成承接页。 新页面和旧页面的意图太近,可能互相竞争。
访问者下一步做什么。 页面能不能自然地引导询盘、试用或注册。
其中一项答不上来,就保留候选状态。宁可少发一页,也别让一堆互相抢词的页面把站内结构做乱。
浏览器能取数,也能把误差带进来
如果当前环境接入了浏览器工具,并且账号有 Semrush 权限,Codex 可以协助点击页面、读取结果、保存截图和整理字段。
但登录态、浏览器连接、站点改版和账号权限,都不是 Codex CLI 自己保证的。今天能看到的字段,下周可能换位置;一个账号能导出的数据,另一个账号未必有权限。
所以浏览器这一层,我只让它做三件事:
取数,保留原始页面和查询时间。
截图,把关键表头和异常状态留档。
整理,把结果写进固定 schema。
涉及付费、导出客户数据、修改网站内容的操作,都停在人工确认之前。浏览器自动化最怕的不是报错,而是静默地完成了一个你没打算做的动作。
把分工压缩成一句话
人定义问题和边界,Codex 采集并整理证据,人根据业务做聚类和页面决策。
对独立站负责人,先准备产品范围文件,再让 Codex 生成研究计划,不要从“帮我做 SEO”开始。
对内容团队,最值得固定的是 schema、来源 URL 和查询时间,这样每次新增关键词,旧结论还能追溯。
对搭 AI Agent 工作流的人,优先抄 只读沙箱、输出文件、JSONL 事件和暂停点。它们比一个很长的 SEO Prompt 更能决定流程是否可复查。
Codex 可以帮你查词、搬数据、做初步聚类,甚至列出候选页面树,它不知道你的交付能力,也不会为错误页面负责。
写在最后
这件事不适合追求“一键完成”。SEO 调研里最适合自动化的,是重复、规则明确、出错后容易回滚的动作;最不该自动化的,是业务边界、页面取舍和上线确认。
先用一小批关键词跑通:计划能不能审、来源能不能回、字段会不会错位、needs-review 能不能被看见。等这条链稳定了,再接脚本、CI 或定时任务。
顺序反过来,跑得越快,返工越多。
参考来源:OpenAI Codex CLI 官方文档:https://developers.openai.com/codex/cliOpenAI Codex GitHub:https://github.com/openai/codexSemrush::https://www.semrush.com/blog/keyword-difficulty/
最近发现一个好用的 AI 生图工具,分享一下。
写文章、做 PPT、搞 README 配图的时候经常需要快速出一张图,HiAPI.ai 直接输入描述就能出图,也支持生视频,响应很快,出图质量也不错。
新注册用户送 50 张 GPT Image 2 免费额度,不用绑卡,需要快速出图的可以试试。
👉 HiAPI.ai(直达链接:https://www.hiapi.ai/invite/QwfK)
想了解更多可以加我 vx: 257735 聊。