本文作者:meng shao(@shao__meng)。版权归作者所有,未经授权禁止转载。
Stanford CS336: Language Modeling from Scratch
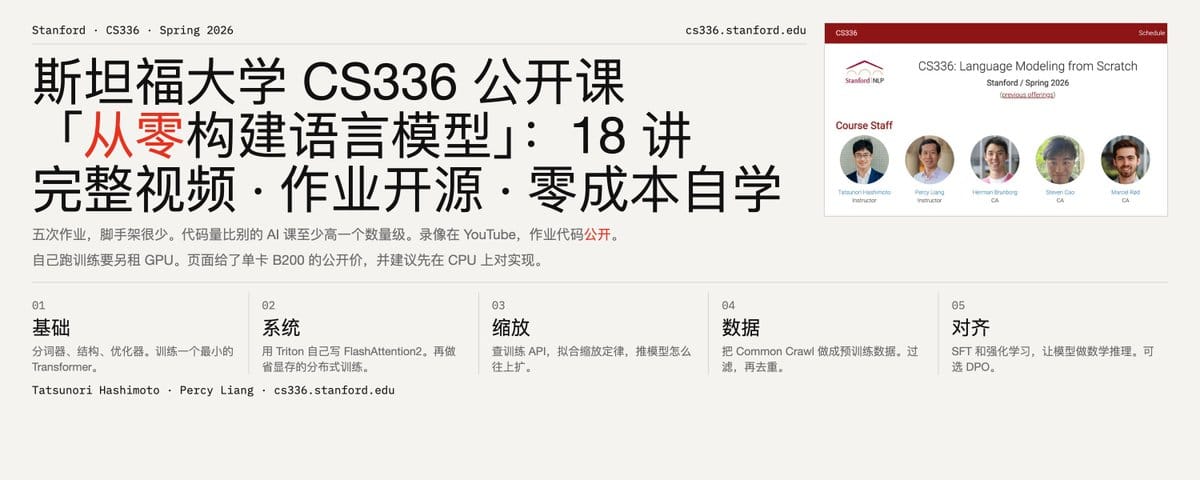
CS336 是斯坦福大学的一门 5 学分研究生课程,由 Tatsunori Hashimoto 和 Percy Liang 两位教授联合讲授(2026 年春季学期),主题是从零开始构建语言模型。课程主页开篇就给出了一个非常准确的类比:这门课之于语言模型,就像操作系统课之于操作系统:不是教你“怎么用”大模型,是要带你亲手把一个完整的语言模型流水线从头到尾做出来,覆盖数据收集与清洗、Transformer 模型构建、训练、直到部署前的评估。
这个定位决定了它的两个鲜明特征:
1.工程量极大。 官方明确说作业代码量“远超一般 AI 课程”,且几乎没有脚手架代码,学生要自己写 tokenizer、自己搭模型、自己实现 FlashAttention2 内核、自己配置分布式训练。先修要求里“扎实的 Python 能力”被放在第一位,甚至排在深度学习经验之前。
2.内容覆盖 LLM 的全生命周期,而非只讲建模。从课程表看,真正讲“模型架构”的只有第 3、4 两讲,其余篇幅都给了系统(GPU/内核/并行)、数据、Scaling Laws、推理、评估和后训练,这个比例分布本身就反映了 2024 年之后业界对“造一个大模型需要什么”的共识:模型结构只占其中一小部分,算力效率和数据质量才是大头。
课程主线:五次作业串起一个完整的 LLM
课程的五次编程作业(Assignment 1–5)构成一条递进的完整链路,与讲课节奏交替进行:
| 作业 | 主题 | 核心任务 |
| --- | --- | --- |
| A1 | 基础 | 实现 tokenizer、模型架构、优化器,训练一个最小语言模型 |
| A2 | 系统 | 性能剖析与基准测试、用 Triton 实现 FlashAttention2、内存高效的分布式训练 |
| A3 | Scaling | 分析 Transformer 各组件的计算开销、通过训练 API 拟合 Scaling Laws |
| A4 | 数据 | 把 Common Crawl 原始网页处理成预训练数据(过滤、去重、配比) |
| A5 | 对齐与推理 RL | SFT + 面向数学推理的 RL;可选部分涉及 DPO 等安全方法 |
这五次作业连起来,恰好就是一个现代 LLM 从原始互联网数据到可对话模型的完整生产流程。A4 特别值得一提:把 Common Crawl 真实地清洗成训练数据,这是绝大多数 NLP 课程完全跳过、但在工业界最耗工时的环节。
YouTube 视频:18 讲完整录像
播放列表由 Stanford Online @StanfordOnline 频道发布,共 18 个视频(17 讲 + 1 次客座讲座),每讲时长在 1 小时 15 分到 1 小时 29 分之间,内容与课程表逐一对应:
第一模块:模型基础(Lecture 1–4)
1.Overview, Tokenization(课程总览与分词)
2.PyTorch (einops)(含 FLOPs、内存、算术强度等资源核算)
3.Architectures(架构与超参数)
4.Attention Alternatives(注意力替代方案、MoE 混合专家)
第二模块:系统与效率(Lecture 5–8)
5.GPUs, TPUs(硬件原理)
6.Kernels, Triton, XLA(算子内核编程)
7–8. Parallelism(两讲,数据/张量/流水线并行等)
第三模块:Scaling 与推理(Lecture 9–11)
9.Scaling Laws
10.Inference(推理与部署效率)
11.Scaling Laws(续,含数据侧 scaling)
第四模块:评估与数据(Lecture 12–14)
12. Evaluation(模型评估方法论)
13. Data: Sources, Datasets(数据来源与常用数据集)
14. Data(过滤、去重、配比、合成数据)
第五模块:后训练与对齐(Lecture 15–17 + 客座)
15.Mid/Post-Training(SFT/RLHF 入门)
16.Post-Training - RLVR(可验证奖励的强化学习,即当前推理模型的核心训练方法)
17.Alignment - Multimodality(对齐与多模态)
• Guest Lecture: Dan Fu(客座讲座)
一个细节:课程表上原定还有 Daniel Selsam 的客座讲座(6 月 1 日),但播放列表中并未收录,最终公开的是 17 讲加 Dan Fu 一讲,共 18 个视频。录像于 4 月中旬起分批上传,与学期进度同步。
几个值得注意的课程设计
对 AI 工具的使用有严格限制。 Honor Code 明确规定:允许用 LLM 回答低层或概念性问题,但禁止用 AI 直接解题,禁止使用 Copilot 等 AI 自动补全,禁止参考网上已有的实现。在一门“教人训练 AI”的课上限制 AI 代写,逻辑是自洽的,课程的全部价值就在亲手实现。
为自学者铺好了路。 课程列出了多家云厂商的 B200 GPU 租用价格(Modal、Lambda、RunPod、Nebius、Together,每小时约 5–7.5 美元),并给出实用建议:先在 CPU 上调试,只在真正训练和跑基准时才上 GPU。课程本身由 Modal 赞助算力。
嘉宾阵容反映课程视野。 客座讲者 Dan Fu 是斯坦福博士、Lambda Lab 创始成员,长期做高效系统与模型训练方向。
对这门课程的评价
CS336 是目前公开可得的课程中,对“大语言模型工程全貌”覆盖最完整、实现深度最高的一门。它假设你已经会训练小模型(要求先修 CS224N/CS229 等深度学习课程),在此基础上把真正的分水岭(系统优化、Scaling Laws、数据处理、后训练 RL)逐一讲到可动手实现的深度。尤其第 6–8 讲(内核与并行)和第 16 讲(RLVR)的内容,在多数高校课程中要么不涉及,只停留在论文综述层面。
对于想系统补齐 LLM 工程能力的学习者,这门课的录播 + 五次作业 + 课程讲义已全部公开,是自学的稀缺资源;但也应清醒评估其门槛:没有扎实的 PyTorch 和体系结构基础(内存层级、算术强度这类概念),中途放弃的概率不低。





