本文作者:波妞PONYO(@ponyodong)。版权归作者所有,未经授权禁止转载。
说实话,我原本以为,这次最容易翻车的是数字。
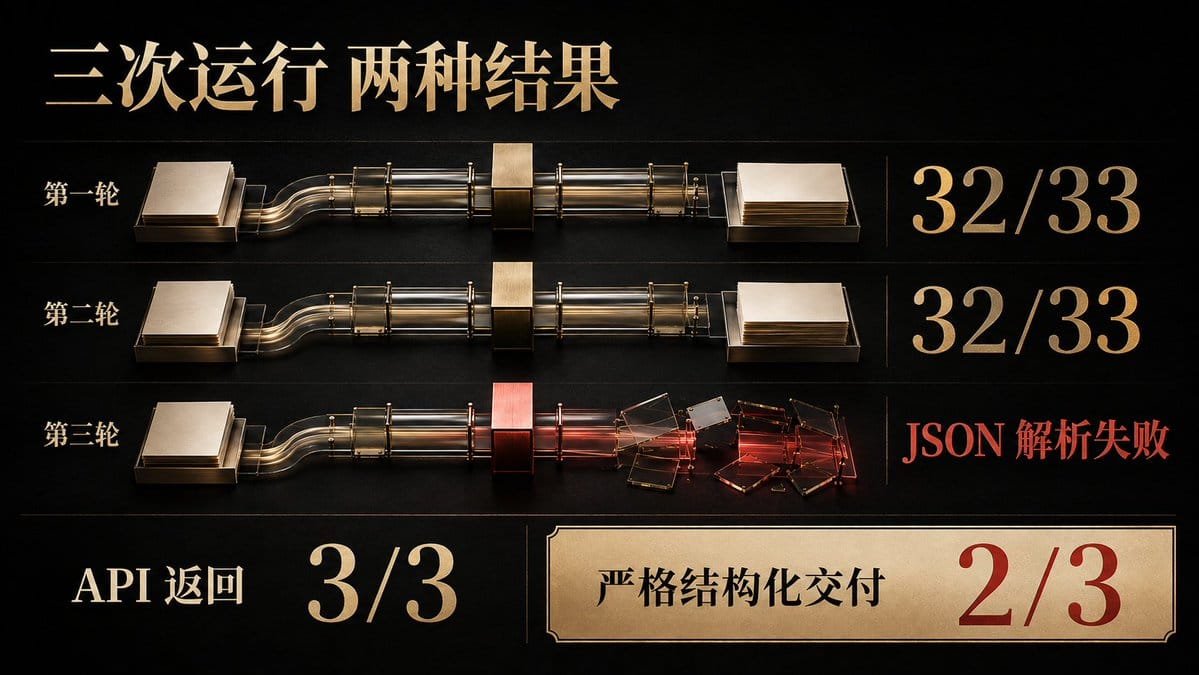
结果同一个宇树科技任务跑了三次:
- 第一轮:32/33;
- 第二轮:还是 32/33;
- 第三轮:内容大体答出来了,整份结果却因为一个 JSON 结构错误,没法继续交给程序。
这个失败,反而比“三次全对”更有意思。
因为模型真正进入金融工作流以后,问题已经不只是“它知不知道答案”,而是:它能不能稳定交出下游真的能用的东西。
我给它的不是一道金融问答题
这次我选了宇树科技。
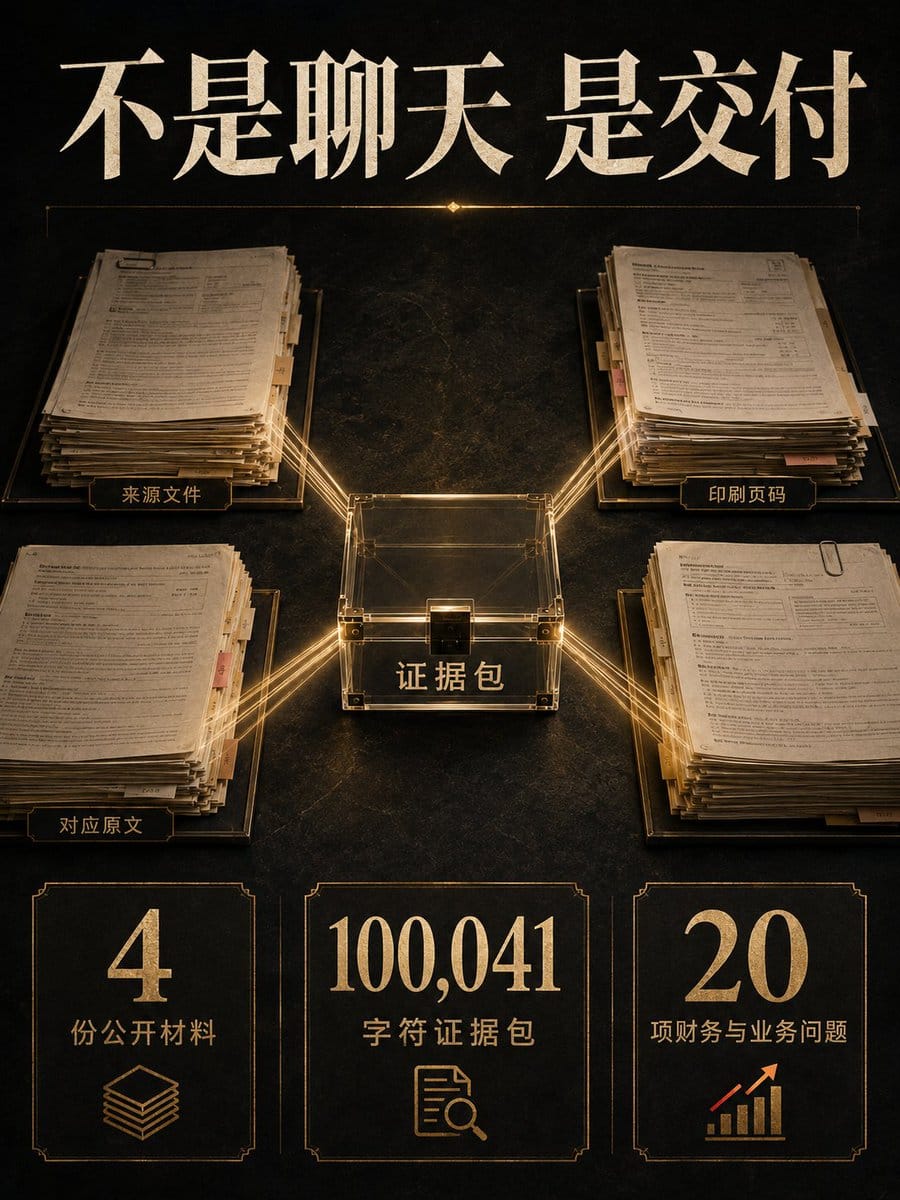
输入来自四份公开申报材料:招股说明书注册稿、两轮问询回复,以及审核中心意见落实函回复。相关原文、印刷页码和少量干扰信息被整理成一份 100,041 字符的证据包。
模型要回答 20 项财务和业务问题,包括:
- 三年营业收入、毛利率、净利润、经营现金流和研发投入;
- 四足机器人、人形机器人与境外业务收入结构;
- 客户集中度、募投项目与 2026 年一季度变化;
- 三类模型在已销售机器人中的集成状态;
- 以及一道材料没有答案的问题:2025 年付费客户的精确数量。
每一项都不能只交一个结论,还必须带回来源文件、印刷页码和对应原文。
换句话说,我测的不是聊天,是交付。
为什么是 Ling-3.0-flash-Fin
Ling-3.0-flash-Fin 是蚂蚁百灵在 Ling-3.0-flash 基础上推出的金融增强模型,采用 124B 总参数、5\.1B 激活参数的 MoE 架构。
参数本身不是我最关心的部分。
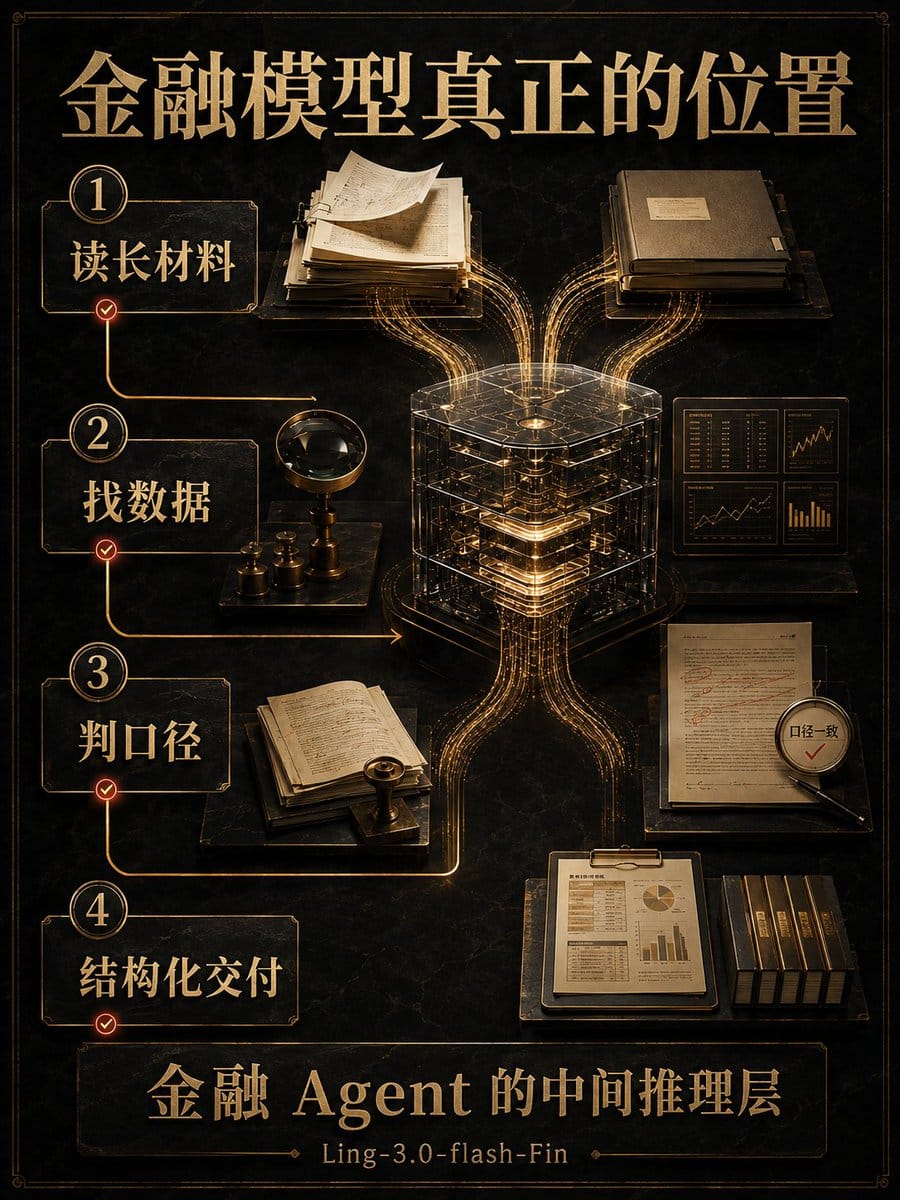
我真正想测的是,它能不能放进一个金融 Agent 里,负责读长材料、找数据、判断口径,再把结构化结果交给校验器和下游工具。
这三轮都走 OpenRouter 的 inclusionai/ling-3.0-flash-fin:free 端点,使用完全相同的证据包、20 项问题和参数。每一轮都从空上下文开始,也不读取上一轮答案。
人工标准答案一直封存到测试结束后,模型看不到。
如果输入条件不一样,连跑三次就没有比较意义。
前两轮准确但不是满分
前两次返回都能被程序正常解析。
校正评分后,两轮结果分别是:
| 指标 | 第一轮 | 第二轮 |
| :--- | :--- | :--- |
| 字段正确 | 32/33(97\.0%) | 32/33(97\.0%) |
| 整项正确 | 19/20(95\.0%) | 19/20(95\.0%) |
| 信源可追溯 | 53/60 | 57/60 |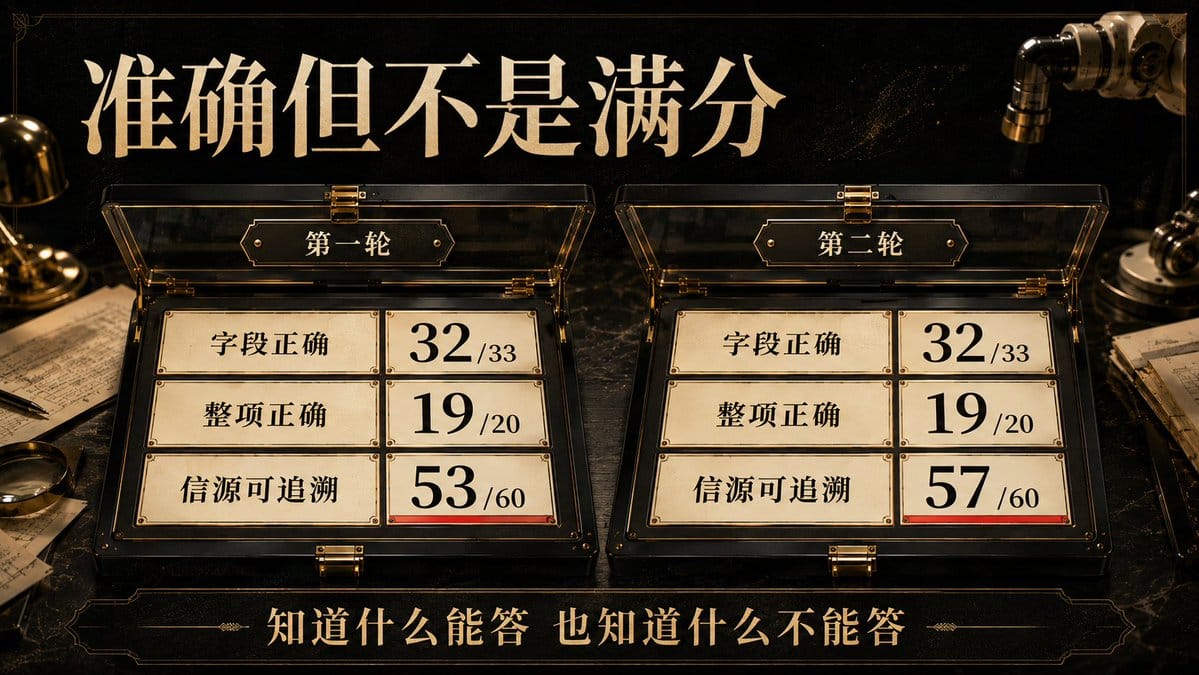
主要财务数据、产品收入结构、境外业务和模型集成状态,它基本都找对了。
对于材料没有披露的付费客户精确数量,它也没有硬编,而是明确说无法确认。
这是我觉得它最像工作流模型的地方:知道什么能答,也知道什么不能答。
但两轮都有同一个缺口。
它找到了 34,906.55 万元股份支付费用,却没有把材料中的关键限定说透:这项费用属于非现金,不涉及现金流出。
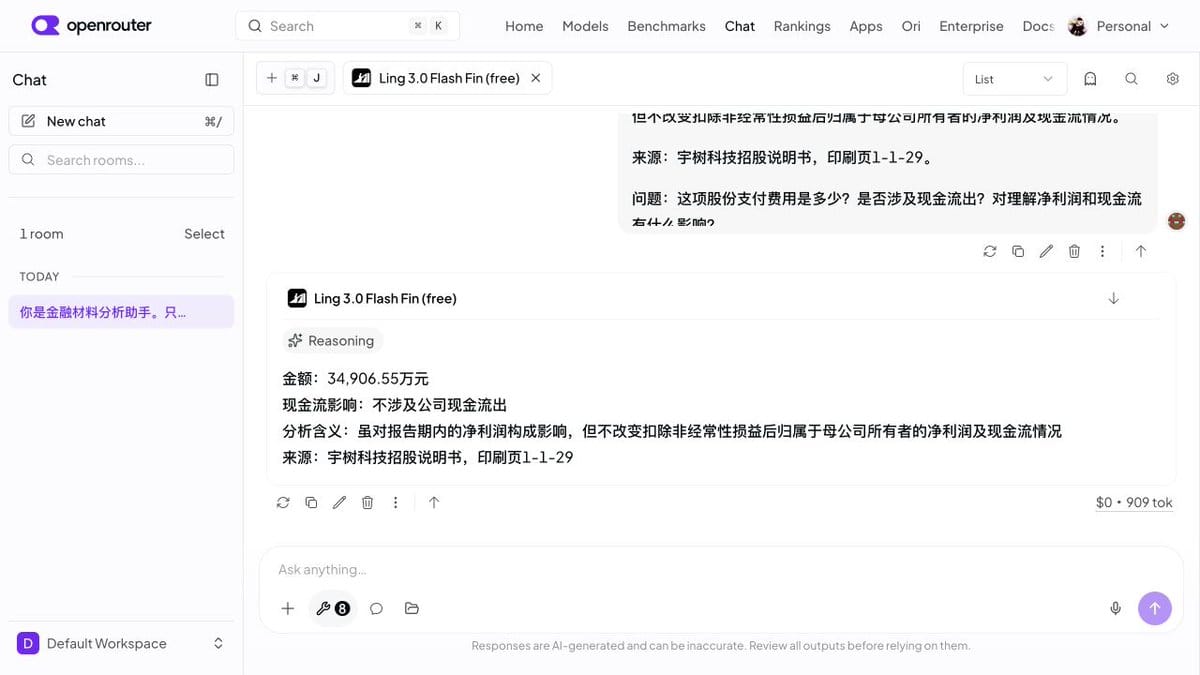
在普通问答里,这可能只是少一句话。
放进财务分析流程里,它却会影响下游怎么理解现金消耗。
数字对了,不代表口径已经交付完整。
第三轮人能看懂但程序接不住
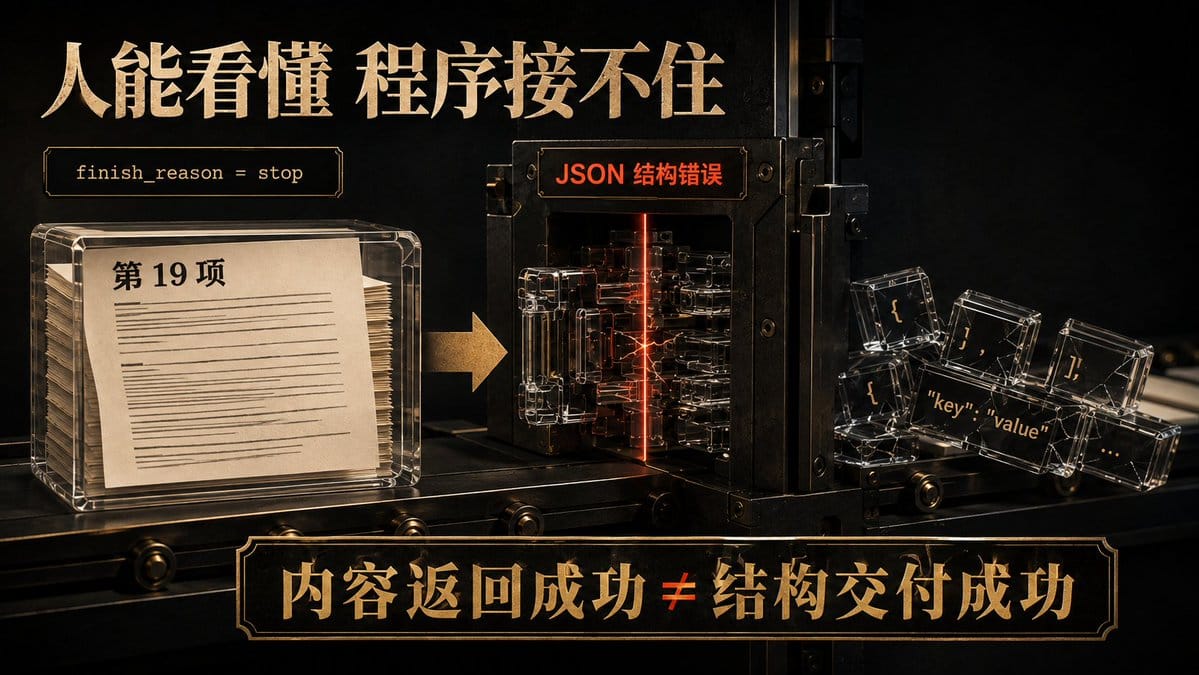
第三次 API 正常返回,finish_reason 也是 stop,不是因为长度不够被截断。
问题出在第 19 项。复杂嵌套答案里,几个本应放进数组的对象被写到了错误位置,最终导致整份 JSON 无法解析。
人打开文本,大概还能看懂它想表达什么。
程序只会告诉你:失败。
所以这次不能写成“三次全成功”。准确的说法是:
API 返回 3/3;严格结构化交付 2/3。
这就是演示和生产之间那条最容易被忽略的缝。
速度与成本也要拆开看
| 指标 | 真实结果 |
| :--- | :--- |
| 三轮耗时 | 29\.697s / 32\.637s / 32\.771s |
| 平均耗时 | 31\.702s |
| 三轮总 Token | 147,086 |
| 本次端点显示成本 | $0 |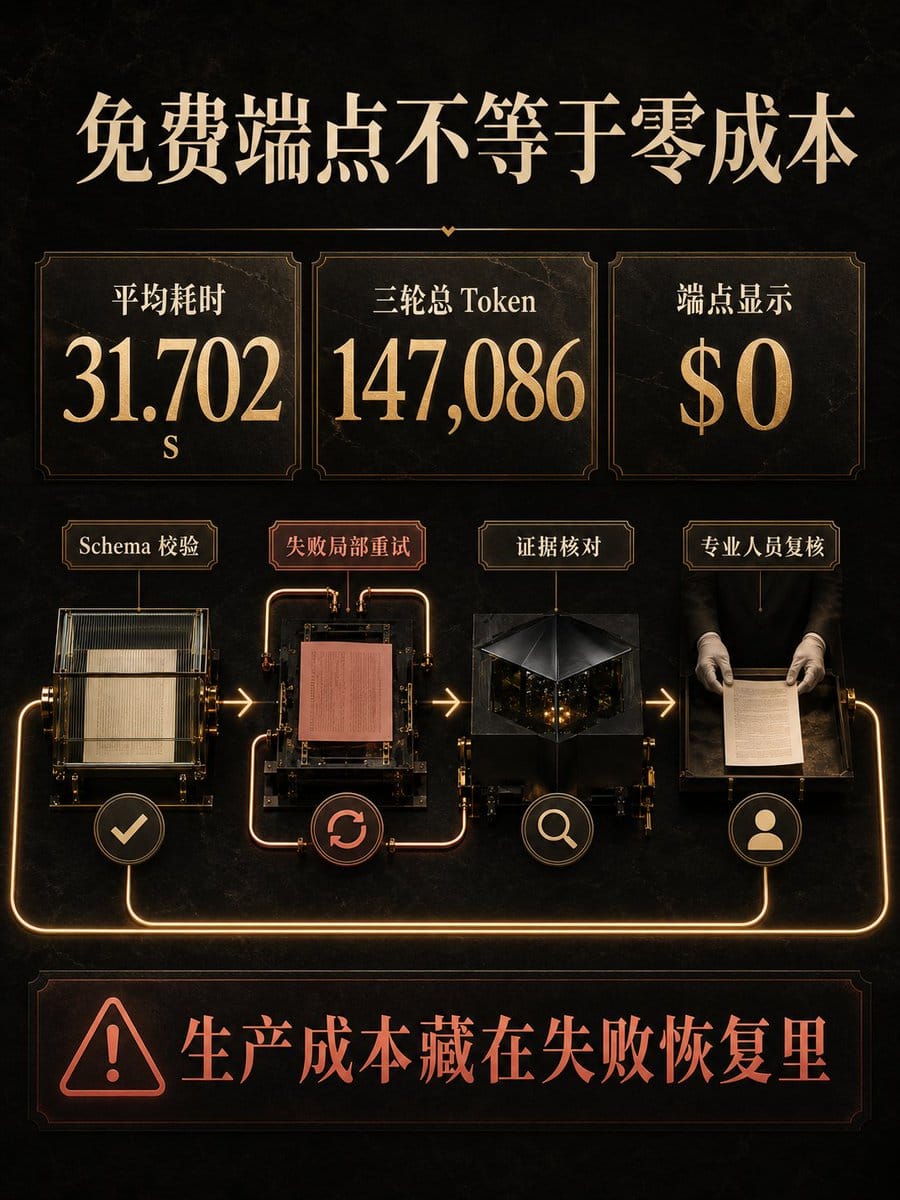
本轮成本为零,是因为测试走了 OpenRouter 免费端点。
这不等于生产部署没有成本。正式工作流还要面对限流、失败重试、数据工具、证据核对和人工审批。
第三轮的 JSON 失败,已经把这些隐性成本露出来了。
如果让我现在把它放进产品
我会用,但不会让它裸奔。
最小可用的生产路径应该是:
官方材料 → Ling-3.0-flash-Fin → JSON Schema 校验 → 失败局部重试 → 专业人员复核 → 下游文件或系统
模型负责理解长材料、取数、识别缺失信息和组织证据;确定性的程序负责格式、边界和失败恢复;专业人员保留最终审批权。
所以,我的结论不是“它已经可以无人值守地接管金融工作流”。
更准确的说法是:在十万字符级别的真实监管材料里,它已经有资格进入金融研究和数据处理的原型工作流,尤其适合做金融 Agent 的中间推理层。
金融 AI 的下一步,不只是回答更多问题。
而是知道哪些结果可以交给程序,哪些必须被拦下来重做。
这次,前两轮过了。
第三轮,校验器应该把它拦住。
Ling-3.0-flash-Fin 目前可以通过 OpenRouter 免费端点体验。免费端点存在速率限制,模型开放方式、许可证和后续价格请以官方最新信息为准。
想自己体验
这次实测使用的是 OpenRouter 上的 inclusionai/ling-3.0-flash-fin:free 免费端点。你可以直接从下面几个入口开始:
- 打开网页对话
- 查看模型与 API 页面
- 查看官方 Hugging Face 模型卡
- 查看官方发布推文
更多官方信息:Ant Ling 官方 X|inclusionAI 官方主页|FinFIRST 官方评测集
说明:本文不构成投资建议。关键数据、估值假设与投资结论仍需由专业人员复核。