本文作者:sitin(@sitinme)。版权归作者所有,未经授权禁止转载。
今天,Anthropic 发布了 Claude Fable 5.1 和 Claude Mythos 5.1,距离 Fable 5 上线,不到三个月。
先说结论:这是一次同价加量的更新,输入输出定价一分没动,还是 $10 / $50 每百万 token,但缓存读取从 $1 降到了 $0.25,官方拿 8 月四周的真实用量算了一下,典型负载账单少 25%,重度 agent 负载少 45%。
跑分全线上涨,而且 5.1 开 Low 或 Medium 档,就能跑出 Fable 5 开 High 档的成绩。
核心数据一览
定价(按 token 计费的渠道)
• 输入 $10 / MTok,输出 $50 / MTok,跟 Fable 5 一样
• 缓存读取:$1 → $0.25 / MTok,降 75%
• 缓存写入不变:5 分钟 $12.50,1 小时 $20;Batch API 五折,$5 / $25
• 实际账单(Fable 5 = 100):典型负载 100 → 75,重 agent 负载 100 → 55,按 8 月四周真实用量算
规格
• 上下文 1M,最大输出 128K,可靠知识截止 2026 年 6 月
• 自适应思考常开,默认 effort high。Claude Code 里默认 High,Claude.ai 和 Cowork 里默认 Medium
• 模型 ID:claude-fable-5-1,Bedrock 上是 anthropic.claude-fable-5-1,Vertex 和 Foundry 同名
跑分(Fable 5 → Fable 5.1)
• Terminal-Bench 4.0:42.0% → 55.8%(Mythos 5.1 60.9%;Opus 5 52.3%,GPT-5.6 Sol 37.3%)
• Terminal-Bench-Science 0.1:24.7% → 52.6%
• Humanity’s Last Exam(无工具):57.8% → 60.9%
• OSWorld 2.0(strict):36.1% → 41.7%
• CursorBench 3.2.0:70.5% → 73.4%
• AutomationBench:17.1% → 31.4%;GDPval-AA v2:1723 → 1853
价格没动,账单为什么能少 45%
一个 agent 跑长任务,每一轮都要把前面的 system prompt、工具定义、对话历史整个再喂一遍。这部分内容上一轮已经处理过了,API 把它存着,下一轮直接读,这就是 cache read 缓存读取。
可以把它理解成停车费:车停在那儿不动,但每过一轮都要交一次。真正新产生的 token 才是油费。Claude Code 这种工具跑起来,停车费远比油费多,一个几十轮的会话,大头都是重读缓存。
以前所有 Claude 模型的缓存读取都是基础输入价的 0.1 倍,Fable 5 就是 $1。5.1 把这个系数改成了 0.025 倍,$0.25。其他模型没动,Opus 5 还是 $0.50,Sonnet 5 还是 $0.20。
所以出现了一个有点反常识的局面:Fable 5.1 的缓存读取,比 Opus 5 便宜一半。
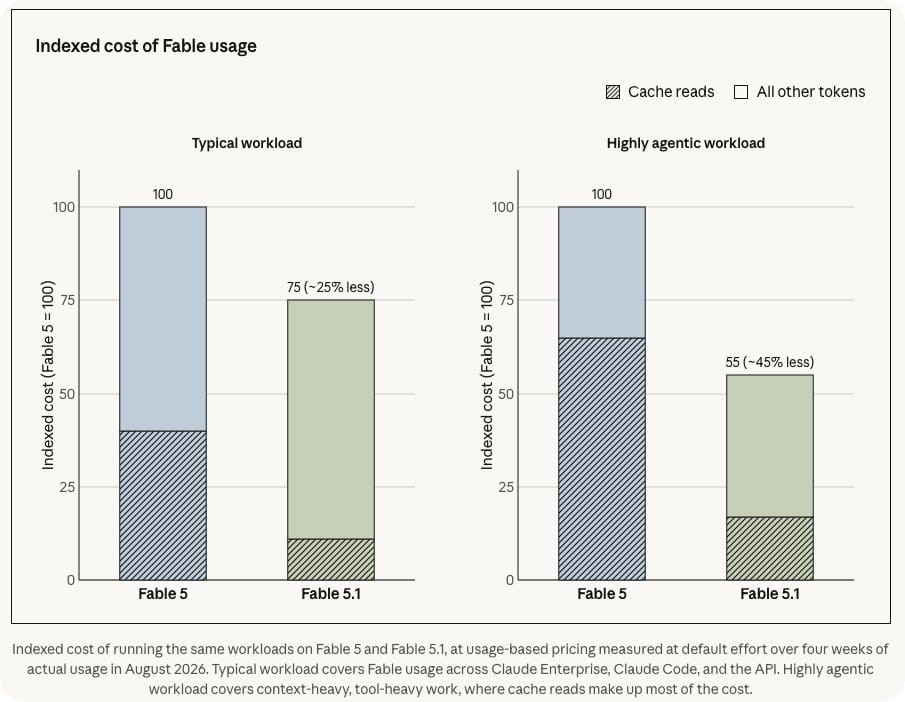
这个变化对不同人影响差很多。拿它做单轮问答,上下文短,缓存占比低,基本感觉不到。跑 agent、跑 Claude Code、跑长会话的,官方那个 45% 就是冲你算的。
Cognition 的反应最直接,说要在发布当天把 Devin 里的 Opus 5 流量切到 Fable 5.1,理由就一句:以前 Fable 级别的模型对 code review 这类活来说太贵,现在缓存降价之后算得过来了。
有一点要说清楚:这条降价只对按 token 计费的渠道生效,API、Bedrock、Vertex、Foundry 这些。订阅制的 Pro、Max 用户账单上不会直接看到变化,额度消耗速度受不受影响,官方没有明确说明。
跑分涨了,更值钱的是 Low 档
涨幅最大的是 Terminal-Bench-Science,从 24.7% 直接翻到 52.6%。不过这个 benchmark 标准误差有 3.5 到 4.5 个点,官方自己在脚注里标了,看大方向就行。
Terminal-Bench 4.0 是 agent 写代码的主战场,42.0% 到 55.8%,超过了 Opus 5 的 52.3%。
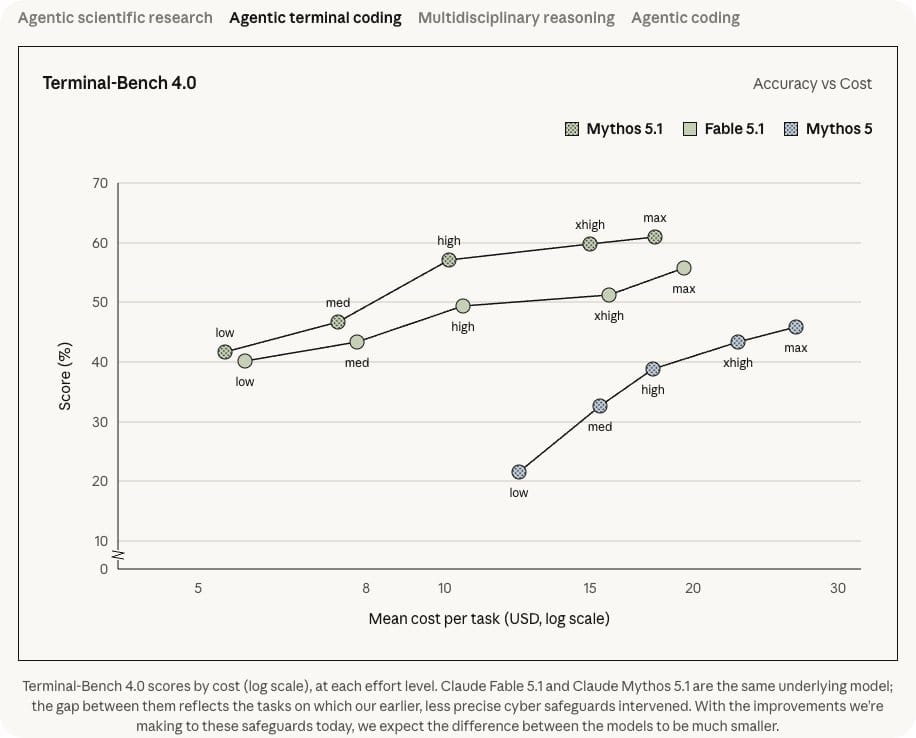
真正值得看的是这张按成本画的图。横轴是花的钱,对数刻度;纵轴是分数;每个模型在 Low、Medium、High 各打一个点。Fable 5.1 的 Low 档和 Medium 档,落在了 Fable 5 High 档差不多的高度,但横轴往左挪了一大截。
翻译一下:同样的活,以前得开满档才能做到的质量,现在开中档就够了,还便宜。
跟以往一样得提醒一句,跑分高和实际好用是两码事。
Red Hat 那边说的更朴素,拿 Claude Code 测了一批坏掉的构建,每一个都找到了根因,Low 档也一样。
Mythos 5.1 和 Fable 5.1 是同一个模型,Terminal-Bench 4.0 上差的那 5 个点,是安全过滤拦掉的任务,官方说随着过滤器变准,这个差距会缩小。
别急着改模型名,三处会直接报 400
这部分是给调 API 的人看的。只用 Claude Code 和 Claude.ai 的可以跳过,那边官方替你处理了。
第一,不能强制调工具了。 tool_choice 设成 {“type”: “any”} 或者 {“type”: “tool”, “name”: “…”},返回 400:
tool_choice: type "tool" and "any" are not supported for this model.
原因是 5.1 的思考是常开的,强制调工具会跳过思考,模型就把推理过程往工具参数里塞,参数质量反而变差。想要结构化 JSON,tool_choice 留 auto,工具定义上加 strict: true,或者直接用 structured outputs。想让它一定调某个工具,在 prompt 里说清楚就行,它对这种指令跟得挺稳。
第二,thinking block 绑模型了。 每个 thinking block 会记下是哪个模型生成的,只往一个方向兼容:5.1 能读旧模型的思考,旧模型读不了 5.1 的。你要是有个 router 或者 fallback 会在对话中间切模型,从 5.1 切到 Opus 5,之前的思考会被 API 静默丢掉,不计费也不报错。想看到丢了什么,加 thinking-binding-controls-2026-08-01 这个 beta header,响应里多一个 input_transformations 数组。
第三,改历史会让思考失效。 这条最容易踩。5.1 的 thinking block 之前的任何东西,system prompt、tools 数组、更早的 message,只要动了一个字,下一次请求就报 400,报错信息是 The block is bound to a different conversation。
哪些算动了:改、删、重排早期轮次;往早期轮次里塞一段临时提醒下次再删掉;每次请求重新拼 system 或者 tools;图片 URL 每次返回不同的字节。
哪些不算:从最前面开始按顺序删 thinking block;服务端的 compaction 和 context editing;挪 cache_control 标记;换 effort。
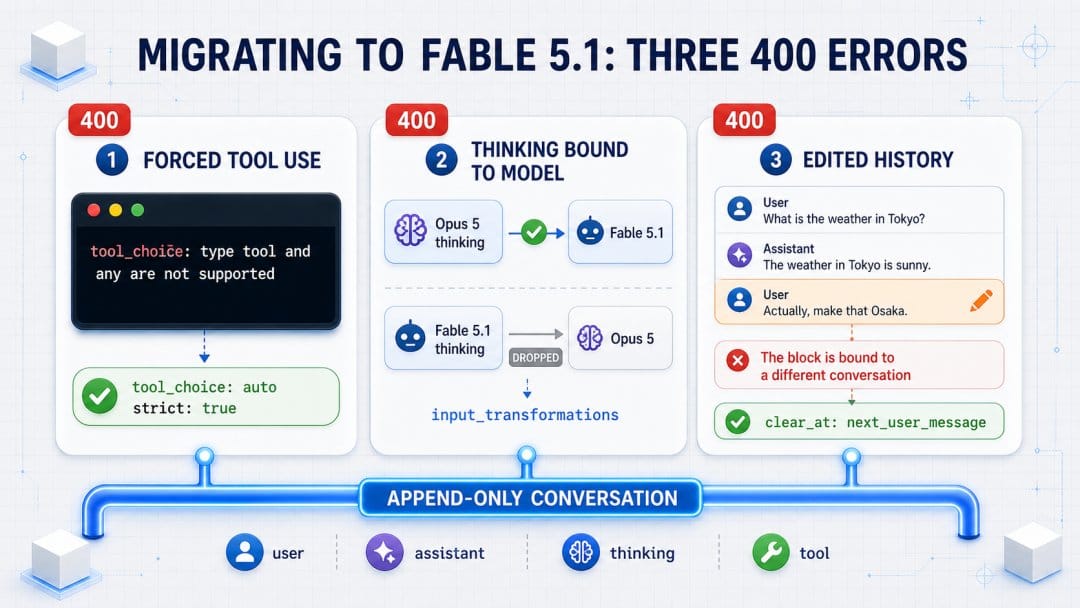
修法其实就一条原则:把对话当成只能追加的日志。想中途给模型加规则,别改 system,用 mid-conversation system message;只想管这一轮的,加 clear_at: “next_user_message”,下一条用户消息出现它就不渲染了,也不占 token,缓存照样命中。这个要带 mid-conversation-system-clear-at-2026-08-21 的 beta header。
新增的几个能力
中途换档。 以前 effort 是整个请求一个值,现在能在对话中间改,而且不打断缓存。
写法是插一条空内容的 system 消息带 output_config:
response = client.beta.messages.create( model="claude-fable-5-1", max_tokens=4096, output_config={"effort": "high"}, messages=[ {"role": "user", "content": "把 SQLite 迁到 PostgreSQL,给三步方案。"}, {"role": "assistant", "content": "1. 导出数据 2. 建 PG schema 3. 导入并核对行数"}, {"role": "system", "content": [], "output_config": {"effort": "low"}}, {"role": "user", "content": "一句话总结上面的方案。"}, ], betas=["mid-conversation-output-config-2026-07-01"], )
难的步骤开 high,收尾开 low,一个会话里省下来的 token 不少。Opus 5 也支持这个。
进度更新能露出来了。 5.1 在工具调用之间会写短句说明发现了什么、下一步干什么,但默认藏在空的 thinking block 里,用户看着像卡死,加 thinking-display-updates-2026-08-18 header 并把 thinking.display 设成 “updates”,这些状态行就以文本形式回来,推理过程照样不露。
Claude Code 侧。 2.1.257 版把 Fable 5.1 设为默认的 Fable 模型。/effort 加了 s 选项,只改当前会话,跟 /model 对齐。
有一个坑:走企业网关的会话,fable 和 best 这两个别名暂时还指向 Fable 5,因为没配好的网关会拒绝 5.1,要用得在 /model 里手动选。
还有几个行为变化不改代码也会碰到,5.1 并行调工具比 Fable 5 保守,可能一轮只调一个,多花轮次但不影响结果,prompt 里加一句让它批量调就行;Low 档更爱凭记忆答,不爱搜,需要新信息的轮次把 effort 抬起来;改文件更倾向整文件重写而不是局部改,输出 token 会多;聊天里加粗、标题、列表用得比以前少。
写在最后
这次更新最实的一刀是缓存读取降到 $0.25,它改变的是 Fable 该在什么场景用的答案。以前的答案是 Opus 5 不够用再上,现在长 agent 会话上 Fable 5.1 可能比 Opus 5 还便宜,这个账要重算。
天天用 Claude Code 的: 升到 2.1.257 以上,/model 选 fable-5-1,默认就是 High。routine 的步骤用 /effort 降下来,长会话里省的是真钱。走公司网关的记得手动选,别名还没切。
调 API 的: 改模型名之前先 grep 一遍 tool_choice,any 和 tool 全换掉。再看你的 messages 数组是不是 append-only,有没有每次重拼 system 或者往历史里塞临时文本。不确定的,开 prefix_mismatch_behavior: “drop_block” 跑一天日志,看 input_transformations 里有没有东西。最后重跑 evals,并行工具调用和整文件重写这两个行为变化会影响你的 token 账单。
给团队算账的: 打开用量面板看 cache_read_input_tokens 占总输入的比例。占比高的负载,切 5.1 是省钱;占比低的,跟 Fable 5 一个价,只是模型强了。
参考来源:官方发布页:https://www.anthropic.com/claude-fable-and-mythos-5-1模型文档:https://platform.claude.com/docs/en/models/fable-5-1/overviewWhat’s new in Fable 5.1:https://platform.claude.com/docs/en/models/fable-5-1/whats-new-fable-5-1定价页:https://platform.claude.com/docs/en/about-claude/pricingClaude Code 更新日志:https://github.com/anthropics/claude-code/blob/main/CHANGELOG.md
最近发现一个好用的 AI 生图工具,分享一下。
写文章、做 PPT、搞 README 配图的时候经常需要快速出一张图,HiAPI.ai 直接输入描述就能出图,也支持生视频,响应很快,出图质量也不错。
新注册用户送 50 张 GPT Image 2 免费额度,不用绑卡,需要快速出图的可以试试。
👉 HiAPI.ai(直达链接:https://www.hiapi.ai/invite/QwfK)
想了解更多可以加我 vx: 257735 聊。